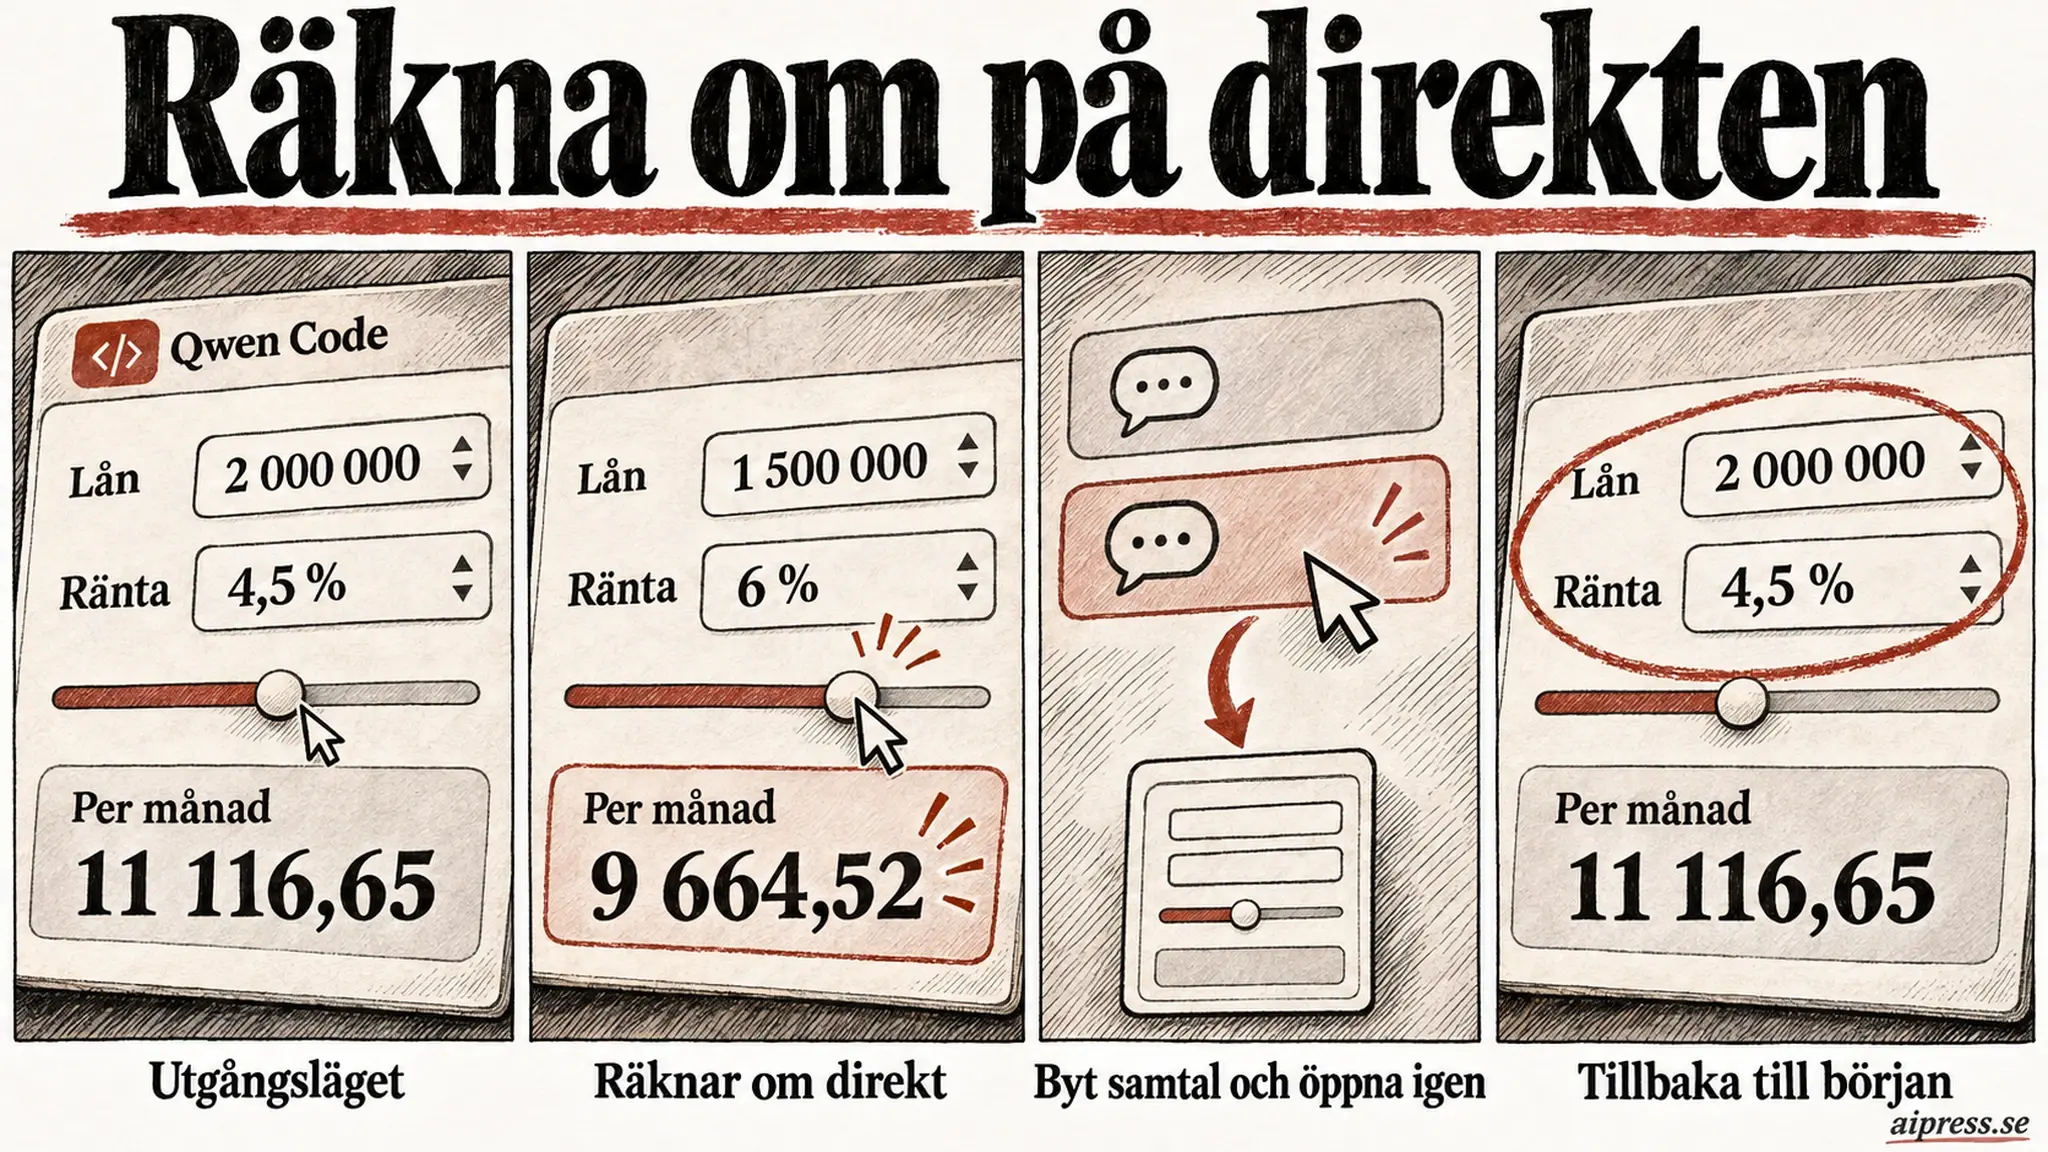
I Aipress test räknade ett lånekort om beloppen utan nya frågor till modellen. Däremot försvann de ändrade värdena när vi bytte samtal, trots Alibabas besked om att de ska finnas kvar.
Qwen Codes kort räknar om när du ändrar siffrorna
Funktionen Generated UI är på från början och ska erbjuda en interaktiv vy när användaren vill justera värden. Korten följer gränssnittets färgtema. Värdena kan följa med som underlag till nästa meddelande, med en borttagbar etikett ovanför skrivrutan.
Enligt Alibabas ändringslogg för Qwen Code ska kort som omfattas av funktionen behålla inmatning och tillstånd när man bläddrar i historiken, byter samtal eller ändrar delad vy på samma sida. De erbjuds bara i gränssnitt som kan visa MCP Apps, tekniken som används för korten. Övriga gränssnitt ska få en tydlig förklaring till att stödet saknas.
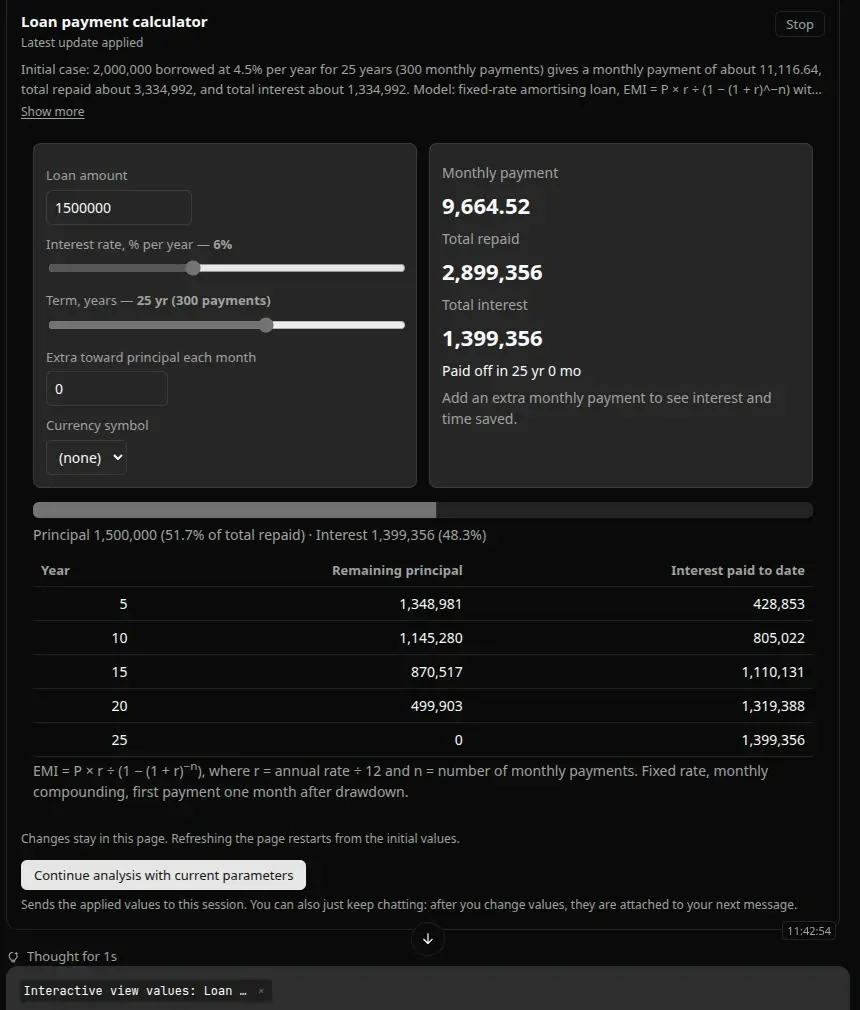
Vi bad om månadskostnaden för ett lån på 2 000 000 med 4,5 procents ränta över 25 år och skrev att vi ville prova olika siffror. Med modellen qwen/qwen3.8-omni-flash via OpenRouter kom ett lånekort efter knappt två minuter. Det hade inmatningsfält, reglage och en tabell över restskulden var femte år. Beräkningen gav rätt månadskostnad, 11 116,65, men modellens inledande text i kortet angav 11 116,64.
När vi ändrade lånet till 1 500 000 och räntan till 6 procent blev månadskostnaden direkt 9 664,52 och den totala räntan 1 399 356. Ingen ny modellfråga skickades. Både samtalsloggen och räknaren för textmängden modellen hade tillgång till stod still.
En etikett med kortets värden dök upp ovanför skrivrutan. Den gick att kryssa bort men kom tillbaka vid nästa ändring. Med etiketten kvar frågade vi hur mycket ränta fem års kortare löptid skulle spara, utan att ange några siffror. Etiketten innehöll då 1 500 000 och 4,5 procents ränta, och svaret räknade på dem och angav en besparing på 223 708.
Knappen ”Continue analysis with current parameters” skickade värdena direkt. Alibabas veckobrev beskriver en lista att granska och ett godkännande före sändning, men inget av stegen visades i testet. Svaret tog med de 1 152 i extra amortering som vi hade fyllt i och gav samma räntebesparing som kortet: 223 670,48.
Vid båda våra byten till ett annat samtal och tillbaka försvann inställningarna. Kortet ersattes av en sammanfattning och knappen ”Reopen interactive view”. När vi öppnade det igen var ursprungsvärdena tillbaka och etiketten borta. Bytet och återöppnandet skickade ingen ny fråga till modellen.
Generated UI går att stänga av under Settings, Experimental. Då skapade modellen i stället filen loan-calculator.html i projektmappen och fortsatte rätta den. Vi avbröt efter 13 modellanrop och drygt tre minuter. I terminalen blev resultatet också en HTML-fil, men inget besked om att kort inte stöds. Textens första uppskattning var 11 116,58 per månad. Modellens senare kontroll gav 11 116,65.
Kortfrågan kostade ungefär 0,009 dollar för tre anrop enligt OpenRouters modellpris. Med funktionen avstängd kostade samma fråga ungefär 0,017 dollar fram till avbrottet och i terminalen ungefär 0,011 dollar. Hela korttestet kostade cirka 0,043 dollar.
Qwen Code följer kodändringar genom granskningen
En pull request, ofta förkortad PR, är ett förslag att föra in kodändringar i ett projekt. Efter att förslaget öppnats kan automatiska kontroller misslyckas, kollegor be om ändringar eller nya ändringar i projektets huvudgren skapa konflikter.
Med /autofix-pr <PR-nummer> ska Qwen Code bevaka förslaget från din dator, normalt varannan minut. Enligt Alibaba läser verktyget loggen för en misslyckad kontroll, rättar koden, verifierar ändringen med projektets egna kontroller och skickar sedan upp den. Det svarar också på granskningskommentarer från betrodda personer och lämnar sådant det inte kan lösa till användaren.
Rättningarna görs normalt i en separat arbetskopia, en worktree, så att mappen du själv arbetar i lämnas orörd. Det nya läget --in-place i instruktionspaketet för PR-bevakning kan i stället arbeta i din befintliga arbetskopia, skicka ändringar och svara i granskningen. Om förslaget ligger efter huvudgrenen ska bevakningen först föra in de nyare ändringarna när de kan förklara en misslyckad kontroll.
Starten stoppas om förslagets gren har lokala ändringar som inte registrerats i Git, eller registrerade ändringar som ännu inte skickats upp. När en omgång blockeras publiceras en kommentar om vad verktyget har gjort, vad som hindrar fortsättningen och vilken mänsklig åtgärd som behövs. En kontroll som fortfarande misslyckas efter tre uppladdningar med rättningar lämnas till en person och visas i statusen.
/autofix-pr status visar läget, /autofix-pr resume <PR-nummer> återupptar bevakningen och /autofix-pr stop <PR-nummer> stoppar den. Web Shell, Qwen Codes webbgränssnitt, får även en bevakningssida med status per projekt, antal uppladdningar och frågor som väntar på beslut. För bevakning i det aktuella webbsamtalet går det att återvända till samtalet eller begära stopp därifrån.
För att låta Qwen Code bevaka ett kodförslag behöver GitHub-verktyget gh vara inloggat och ha rätt att skicka ändringar till grenen. Starten frågar vart ändringar ska skickas, om svar ska publiceras och om rättningarnas kommandon får utföras utan fler frågor. Vanlig start följer dina godkännandeinställningar. Att låta rättningarna fortsätta utan frågor kräver ett särskilt val och ytterligare bekräftelse.
I en vanlig terminalsession slutar bevakningen när sessionen avslutas. Via den lokala bakgrundstjänsten kan den fortsätta efter att webbläsarfliken stängts och återställas efter omstart. Omstarten tar däremot bort sessionens bekräftelse för bevakningen, som behöver bekräftas igen med återupptagningskommandot. Schemat gäller normalt i sju dagar. Bevakningen avslutas också när förslaget stängs eller förs in i projektet.
Qwen Codes aktivitetsvy samlar samtal som väntar
Webbgränssnittets nya aktivitetsvy samlar pågående arbete, olästa färdiga svar och samtal som väntar på godkännande eller inmatning. Alibaba anger även felstatus. Panelen Token Usage får samtidigt andel lyckade anrop, svarshastighet och tidsmått direkt i vyn, med olika färger och resultat per modell.
Aipress testade överblicken med tre samtidiga samtal, avsiktligt felaktiga modellnamn och två bakgrundsagenter. Modellen för de lyckade anropen var qwen/qwen3.8-omni-flash via OpenRouter.
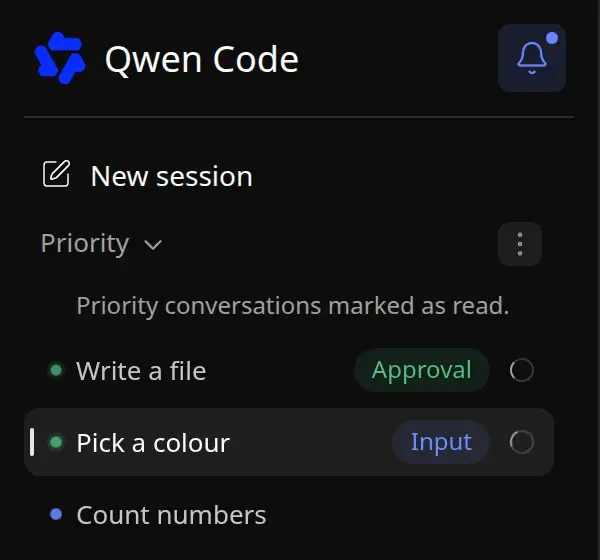
Aktivitetsvyn öppnades med klockan överst i sidopanelen, där kortkommandot Ctrl+Alt+U angavs. Under ”Priority” fick samtalet som väntade på kommandogodkännande etiketten ”Approval”. Modellens fråga fick ”Input”. Ett färdigt, oläst svar markerades med en blå prick. Ordet ”Finished” syntes först när pekaren hölls över raden. Pågående svar visades med en snurra.
Massåtgärderna fungerade: att markera allt som läst tog bort den blå pricken men behöll ”Approval”, och ”Clear read chats” flyttade det lästa samtalet till ”Today”. Arkivering frågade först om pågående arbete skulle stoppas. Alla tre samtalen arkiverades och det väntande kommandot utfördes aldrig. ”Undo” tog tillbaka samtalen men startade inte om arbetet. När vi framkallade ett modellfel fick samtalsraden däremot ingen felmarkering. Felet syntes inne i samtalet och i Token Usage.
Mätpanelen öppnades med mätarikonen överst i samtalet. Efter fem lyckade svar visade den 100 procent lyckade anrop, 71,3 token per sekund och i snitt 4,8 sekunder till första token. Token är de textbitar modellen arbetar med. Panelen visade också genereringstid och genomsnittlig svarstid utan att vi behövde hålla pekaren över något. Diagrammet gick att växla mellan hastighet och väntan till första token för varje anrop.
Antalet token för inmatning, cachelagrad text, svar och resonemang stämde exakt med OpenRouters register över samma fem anrop. Qwen Codes uppmätta tid till första token låg 75 till 315 millisekunder högre, med snittet 4,8 mot 4,7 sekunder. Hastigheten var 71,3 mot 71,6 token per sekund beräknat med OpenRouters tider.
Efter ett fel föll andelen lyckade anrop till 83,3 procent och efter nästa till 75 procent. Diagrammet markerade felen med kryss och modellen fick en egen färg och ett block med felkoden 400. Den fullständiga feltexten stod bara i samtalet. Hastighetssiffrorna påverkades inte och OpenRouter debiterade inget för felen. Det felaktiga modellvalet följde dessutom med till nästa nya samtal, tills vi bytte modell.
Web Shell och skrivbordsappen visar nu även antal aktiva bakgrundsagenter. I webbtestet visades ”2 local agents” under skrivrutan när två agenter arbetade, sedan en och till sist ingen. Knappen öppnade en lista över agenterna och deras status. Under huvudsvaret syntes i stället ”Parallel agents” i samtalet.
Testet kostade ungefär 0,022 dollar för 21 lyckade anrop. Ett svar i ett pågående samtal kostade cirka 0,0005 dollar och det första anropet utan cache cirka 0,002 dollar. Uppgiften med två bakgrundsagenter stod för ungefär 0,014 dollar för tolv anrop, eftersom agenterna gjorde egna anrop med runt 14 000 token in vardera.
Qwen Code importerar minnen från Codex
Minnen från Codex, OpenAI:s verktyg för programmering, kan nu föras över till Qwen Code. Alibaba beskriver en förhandsvisning följd av ett urval som bearbetas med projektets valda modell och sedan används i det vanliga minnessystemet.
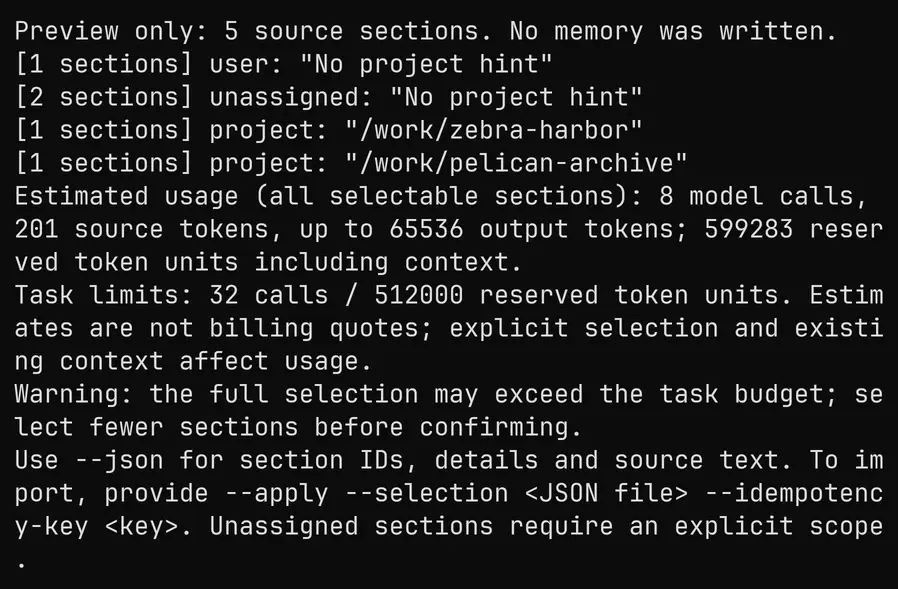
I Aipress.se:s test lade vi fem påhittade minnesavsnitt i Codex minnesmapp och valde fyra för import med qwen3.8-omni-flash via OpenRouter. Kommandot qwen memory import codex --dry-run visade antal avsnitt och uppskattad användning utan nätverk eller ändrade filer. Själva texterna kom först med --json. Även kommandot utan --dry-run stannade vid förhandsvisningen och ställde ingen fråga. En varning om att urvalet kunde gå över gränsen för en import visades trots att det bara omfattade 201 token.
Urvalet krävde en JSON-fil, ett strukturerat textformat, med varje avsnitts id och giltighetsområde: user för användaren eller project för projektet. Importen startades med qwen memory import codex --apply --selection <fil> --idempotency-key <nyckel>. Ett okänt id eller saknat område stoppades. När vi lade ett projektfaktum i användarområdet vägrade modellen och ingen fil skrevs.
Importen tog 23,7 sekunder och tre modellanrop i förgrunden, i stället för det bakgrundsarbete veckobrevet beskriver. Tabellen visar vad som faktiskt sparades i testet.
| Avsnitt | Scope vi valde | Status | Vad som hamnade i minnet |
|---|---|---|---|
| Användarprofil med två fakta | user |
added |
Två dokument, ett per fakta |
| Tips om sidoprojektets port | project |
added |
Ett dokument, porten kvar |
| Byggkommandot | project |
added |
Ett dokument, kommandot oförändrat |
| Sammanfattning av en byggsession | project |
skipped |
Inget: tiden 90 sekunder och filnamnet föll bort |
added betyder att minnet lades till och skipped att det hoppades över. Profilen, porten och byggkommandot kom med, men tid och filnamn i sessionssammanfattningen föll bort. Modellen skrev om texterna och lade även till råd som inte fanns i källan, exempelvis att en annan port skulle betraktas som ett konfigurationsfel.
Därefter frågade vi i nya samtal efter uppgifter som bara fanns i minnet. Tabellen återger svaren från Aipress test.
| Fråga om | Scope | Svar |
|---|---|---|
| Favorittestramverket och dess flagga | user |
Rätt, och svaret slutade med den enradiga sammanfattning minnet bad om |
| Byggkommandot, första frågan | project |
“I don’t know” |
| Byggkommandot, omformulerad fråga | project |
Rätt |
| Sidoprojektets port | project |
Rätt |
| Kodordet vi lämnat utanför | ingen | “I don’t know” |
| Sessionens tid och filnamn, som föll bort | project |
“I don’t know”, men svaret nämnde byggkommandot |
Modellen hittade profiluppgifterna och porten, men byggkommandot först efter en omformulerad fråga. Vid den första frågan fanns minnet med, men projektminnenas mapp saknades i den medskickade förteckningen. Modellen letade i fel mapp och valde att inte lita på minnet. Före importen hade samma fråga också besvarats med ”I don’t know”. Kodordet som vi lämnade utanför fördes inte över.
Upprepad import gav inga dubbletter. Samma importnyckel gav samma svar utan modellanrop. Med ny nyckel upptäcktes dubbletten på 0,4 sekunder utan anrop, och omformulerade källfakta kändes igen efter ett anrop. När vi tog bort ett minne med /forget återställdes det inte vid nästa import.
Saknad minnesmapp gav ett rått filfel med sökvägen. En tom mapp gav fel om ogiltigt källmaterial och en tom MEMORY.md gav en förhandsvisning med noll avsnitt.
Importen kostade ungefär 0,0016 dollar och en fråga i ett nytt samtal cirka 0,0012 dollar. Hela testet omfattade 37 anrop och kostade omkring 0,022 dollar enligt OpenRouters uppgifter. Ungefär hälften gick till Qwen Codes bakgrundsarbete som letar nya minnen efter varje session. Det sparade inget nytt i testet.
Fler ändringar i Qwen Code och QwenCloud
Web Shell kan nu hämta ett kodprojekt direkt från en Git-adress och öppna det som arbetsyta. Svar går att kopiera som ren text eller Markdown, och nya samtal får namn efter första meddelandet. Bakgrundsagenters samtal, förgreningar och schemalagda arbeten samlas under ursprungssamtalet. Extra projektmappar hanteras i ”Workspace directories” och tillägg gäller direkt i alla pågående samtal i arbetsytan.
Workflow-läget ligger kvar mellan meddelanden i samma samtal. Det aktiveras med --workflow-mode on eller /workflows mode on och visas i båda terminalgränssnitten. Återställning, förgrening, tillbakaspolning och tömning har egna regler, och ett misslyckat lägesbyte återgår till föregående tillstånd. Inställningen följer även med till en Docker-sandlåda, en avskild miljö för programmet. Reglage i Web Shell, delade vyer och VS Code-chatten ändrar nästa meddelandes inställning utan att avbryta svaret. Reglaget ligger nu i skrivrutans plusmeny.
Det alternativa terminalgränssnittet OpenTUI får diktering med mellanslag när skrivrutan är tom, inklusive mikrofontillstånd, avbrytning och inspelningsstatus. Text, bilder och verktygsresultat finns kvar när samtalet återupptas. Tillbakaspolning återställer samtal, nästa begäran och utkast tillsammans, och kontrollpunkten sparas när en ändring godkänns. Tillägg kan installeras färdigt genom panelerna Discover och Sources. Bun behöver inte längre installeras separat.
Web Shell får kortkommandon för samtalsöversikt och delad vy. Alternativet ”Add to Split View” i stödda samtalsmenyer öppnar samtal sida vid sida.
Uppdatering med ett klick av webbgränssnittets bakgrundstjänst stöder nu även installationer med pnpm, yarn, bun och npm med sudo. Om automatiken inte är tillgänglig visas manuella steg. Skrivbordsappen får också RPM-installationspaket för Fedora 44 och RHEL 10 på x64.
Det experimentella kommandot qwen serve --managed --open startar den lokala tjänsten och en hanterad agent tillsammans, med databas och ett gemensamt gränssnitt för vanliga och hanterade sessioner. Det är avsett för den egna datorn och kräver Node.js 22 eller senare samt Java 21.
I QwenCloud går qwen3.8-flash nu att använda med EU-distribution i Frankfurt och med distribution i Hongkong. Modellen kan generera text, resonera, tolka bilder, anropa funktioner och lämna strukturerade svar. Den stöder återanvändning av tidigare inmatning genom cache, rymmer en miljon token i sammanhanget och är kompatibel med OpenAI:s och Anthropics API:er, gränssnitten som andra program använder för att anropa modeller.
Den nya röstmodellen qwen-audio-3.1-realtime-flash stöder samtal i realtid med ljud åt båda håll, text och ljud som in- och utdata, funktionsanrop, webbsökning och röstkloning. Den har plats för 262 144 token i sammanhanget.
Veckans rättningar i Qwen Code
Terminalens kostnadsuppskattning dubbelräknar inte längre resonemangstoken vid användning av OpenAI Chat Completions, OpenAI Responses eller Qwen OAuth.
Web Shell ska inte längre reagera trögt när du byter namn på ett samtal.
Webbförfrågningar pausas när anslutningen försvinner och återupptas automatiskt när den kommer tillbaka.
Långa rader i verktygskortens ändringsvyer radbryts, så att kommentarer och sökvägar kan läsas med lodrät rullning.
Verktygsanslutningar via MCP hoppar över dubbla verktygsnamn men behåller alla unika verktyg, så att en namnkrock inte döljer en hel servers utbud.
Långa sidosvar från /btw går att rulla i en avgränsad panel med mushjul, Shift och upp- eller nedpil, PageUp/PageDown eller rullningslist. Korta svar är oförändrade.
Windows-installationen stoppar nu den medföljande programmiljön innan filer ersätts, för att minska uppdateringsfel när node.exe är låst.
Frågor om Qwen Codes kort och nya funktioner
Måste man slå på Qwen Codes interaktiva kort?
Nej, Generated UI är på från början. Funktionen kan stängas av under Settings, Experimental. I Aipress test skapades ett lånekort när vi bad att få prova olika siffror.
Kostar varje ändring i ett Qwen Code-kort ett nytt modellanrop?
I Aipress lånetest ändrades beräkningen direkt utan nya modellfrågor. Att be modellen analysera kortets värden igen skickade däremot en ny fråga.
Behåller Qwen Code kortets värden när man byter samtal?
Enligt Alibaba ska kort som omfattas behålla sina värden. I Aipress test återställdes lånekortet till ursprungsvärdena vid båda bytena till ett annat samtal och tillbaka.
Kan Qwen Code föra över minnen från Codex?
Ja. Importen har förhandsvisning och urval per användare eller projekt. I Aipress test krävdes en urvalsfil och uttrycklig import. Vissa uppgifter föll bort, och ett byggkommando hittades först efter en omformulerad fråga.
Källor
- Qwen Code Changelog
Qwen, hämtad
- Model releases
QwenCloud, hämtad
- Qwen Code Weekly: /autofix-pr Keeps a PR Moving After You Open It, Scheduled Tasks Clear a Gate Before the Model Runs, qwen attach Brings a Background Session Back to the Terminal
Qwen, hämtad
- Autofix a Pull Request
Qwen, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.