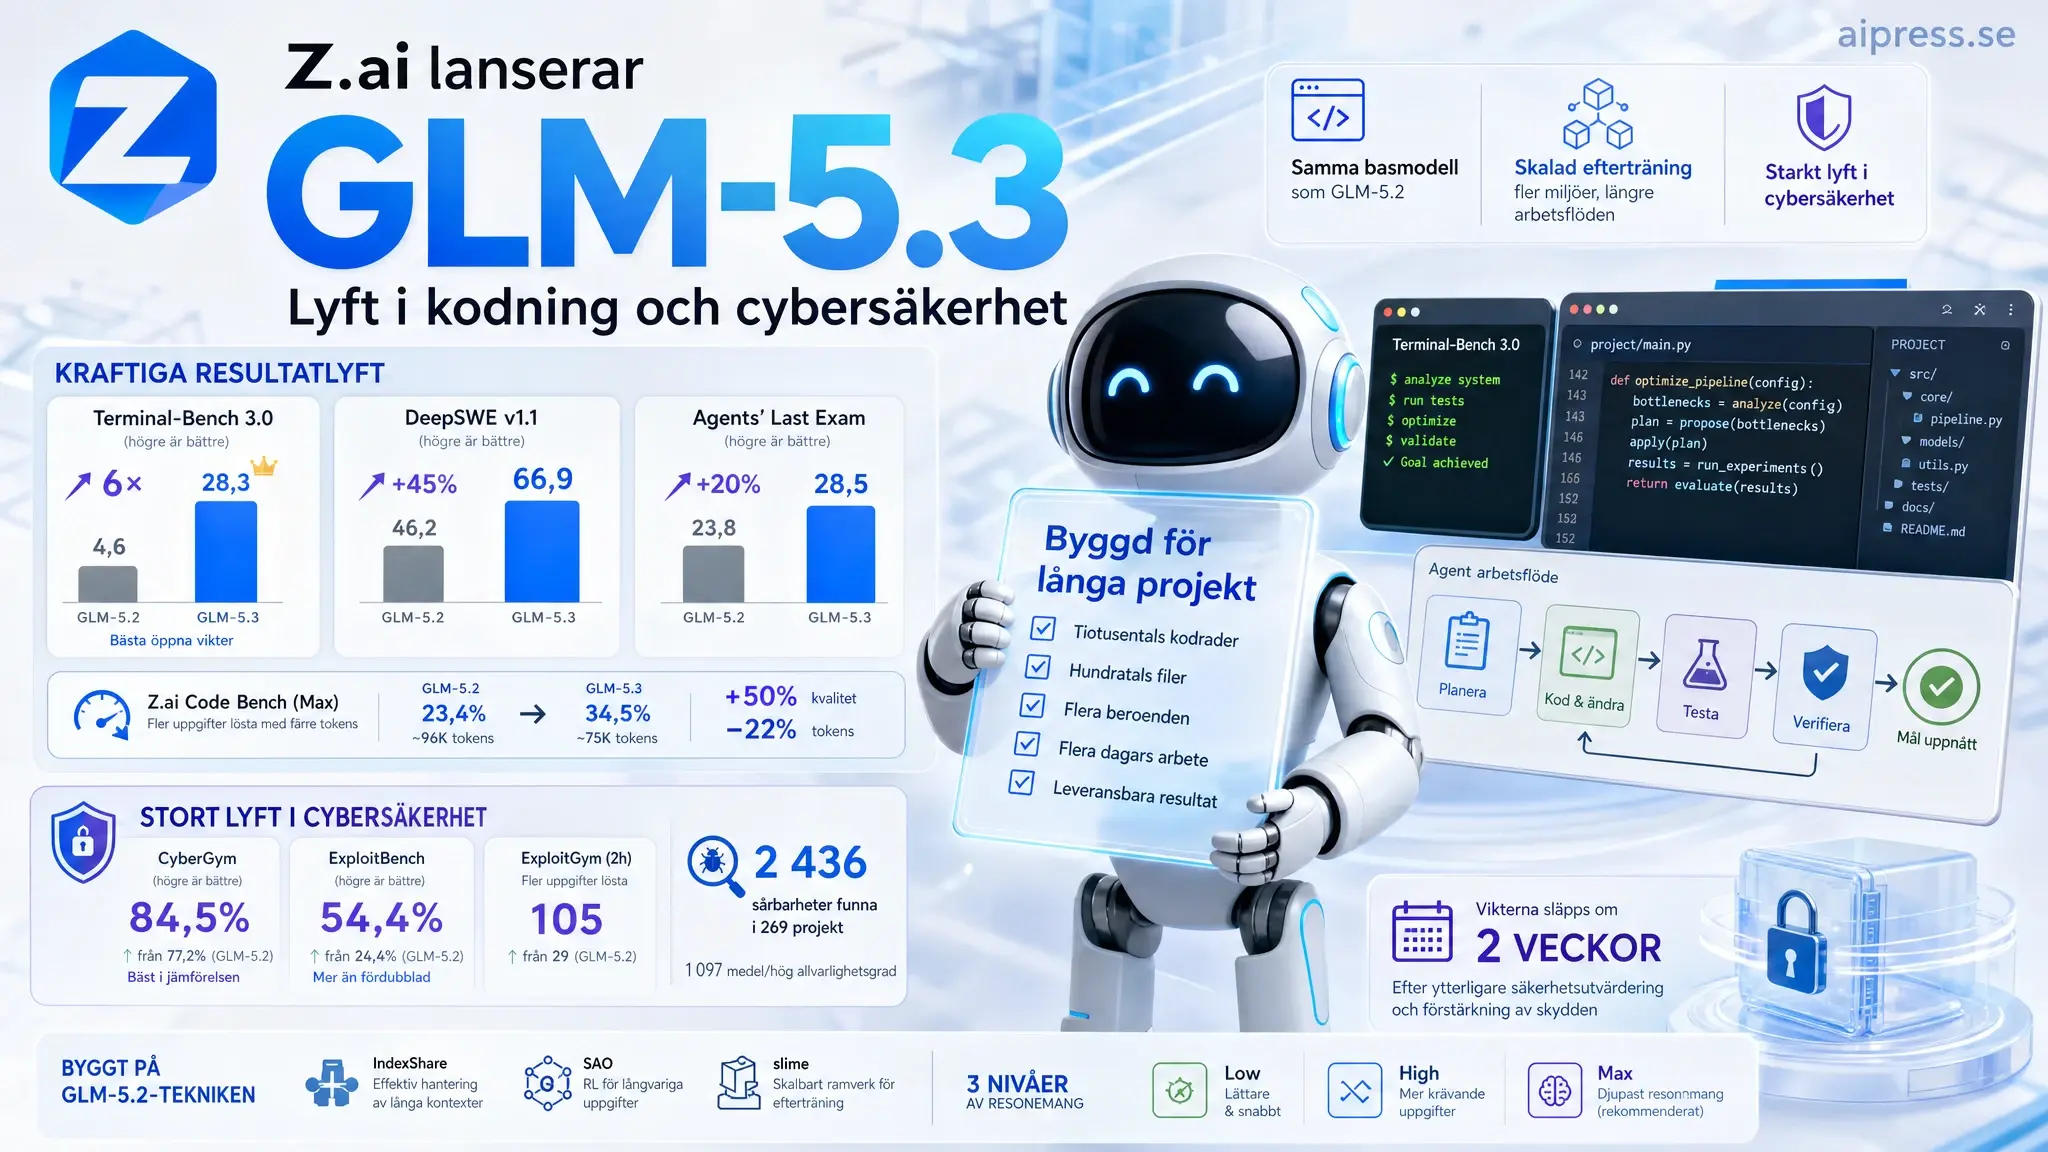
Resultaten är påtagliga. GLM-5.3 förbättras med 50 procent i företagets interna kodningstest och tar stora steg i offentliga mätningar som Terminal-Bench 3.0, DeepSWE v1.1 och Agents’ Last Exam. Modellen har också utvecklat betydligt starkare kapacitet inom sårbarhetsanalys. På vissa säkerhetstester mer än fördubblas resultatet jämfört med GLM-5.2.
Det senare var inte helt väntat. Z.ai tränade modellen på att hitta och analysera sårbarheter, men uppger att förmågan fortsatte att växa snabbare än väntat när efterträningen skalades upp. GLM-5.3 blev inte bara bättre på att upptäcka enskilda brister i kod. Den började även resonera över flera steg i en exploateringskedja och sätta samman mer sammanhängande planer.
Modellvikterna släpps inte direkt vid lanseringen. Z.ai planerar att göra dem offentligt tillgängliga två veckor senare, efter ytterligare säkerhetsutvärdering och förstärkning av skydden.
Samma basmodell: all utveckling sker efter grundträningen
GLM-5.3 är inte resultatet av en större eller helt ny basmodell. Under ytan används samma grund som i GLM-5.2. Skillnaden ligger i vad som har hänt efter den ursprungliga träningen.
Z.ai har under den senaste månaden byggt vidare på den träningsstack som togs fram för föregångaren. Fler miljöer har lagts till, uppgifterna har blivit mer varierade och mer beräkningskraft har lagts på långa arbetsförlopp. Företaget beskriver detta som skalad efterträning: modellen placeras i körbara miljöer, försöker lösa uppgifterna och får återkoppling utifrån resultat som går att kontrollera.
Arbetet bygger på tre centrala delar från GLM-5.2:
- IndexShare, för mer resurseffektiv bearbetning av långa kontexter.
- SAO, en metod för förstärkningsinlärning på uppgifter som pågår under lång tid.
- slime, Z.ai:s öppna ramverk för storskalig och asynkron efterträning.
I GLM-5.3 har denna grund inte ersatts. Den har matats med fler realistiska uppgifter, längre förlopp och mer beräkning.
Lanseringen fungerar därför också som ett experiment i hur långt en befintlig modell kan utvecklas utan att den underliggande basmodellen tränas om. Z.ai:s slutsats är att betydande kapacitetslyft går att få genom bättre miljöer och mer omfattande efterträning, åtminstone inom kodning, agenter och cybersäkerhet.
Från avgränsade kodproblem till flera dagars ingenjörsarbete
Många kodningsmodeller tränas och testas på relativt isolerade problem. De får en tydlig uppgift, ett begränsat kodstycke och ett svar som kan bedömas direkt. Sådana tester säger en del om programmeringsförmågan, men mindre om hur modellen fungerar i ett riktigt utvecklingsprojekt.
GLM-5.3 har i högre grad tränats på hela arbetsprocesser. Modellen kan behöva identifiera problemet, analysera möjliga lösningar, göra förändringar, köra tester, tolka resultat och fortsätta tills uppgiften är färdig.
En del av träningsuppgifterna motsvarar enligt Z.ai flera dagars arbete för en erfaren ingenjör. Modellen kan få tillgång till samma typer av resurser som en mänsklig utvecklare: beräkningskluster, lagringssystem, interna dokument, kodarkiv och tidigare experimentresultat.
I ett scenario för infrastruktur till maskininlärning kan uppgiften exempelvis vara att hitta flaskhalsar i en träningsstack. Modellen behöver då undersöka flera system, föreslå optimeringar, ändra implementationen och köra experiment. Det räcker inte att koden ser rimlig ut. Slutresultatet måste ge en mätbar prestandaförbättring utan att korrektheten försämras.
Den typen av träning ska göra modellen bättre på att ta ansvar för ett större stycke arbete, i stället för att vänta på att användaren delar upp allt i små och tydliga steg.
Byggd för projekt med många filer och beroenden
Z.ai beskriver GLM-5.3 som kapabel att arbeta vidare i projekt med tiotusentals kodrader, hundratals filer och flera system som är beroende av varandra. Den ska kunna hålla fast vid ett övergripande mål även när uppgiften kräver många ändringar och upprepade testomgångar.
Företaget lyfter fram front-end-utveckling, felrättning och refaktorering som exempel. I sådana uppdrag ska modellen kunna utveckla självständigt, kontrollera sitt eget arbete och föra projektet närmare ett leveransbart tillstånd med begränsad mänsklig hjälp.
Det är en annan ambitionsnivå än att generera en demonstration från en enda instruktion. En prototyp kan se övertygande ut utan att fungera stabilt eller passa in i en befintlig kodbas. Ett levererbart projekt måste också hantera tester, byggsystem, beroenden, kodstandarder och sådant som redan finns i systemet.
GLM-5.3 är tänkt att arbeta genom den friktionen. Hur väl det fungerar i praktiken beror förstås på kodbasen, verktygen och vilka rättigheter modellen får. Z.ai:s testresultat visar ändå en stor förbättring på mätningar som försöker komma närmare verkligt agentbaserat utvecklingsarbete.
Kraftigt lyft på Terminal-Bench 3.0
En av de största resultatförändringarna syns i Terminal-Bench 3.0. Där stiger GLM-modellen från 4,6 för version 5.2 till 28,3 för GLM-5.3.
Testet handlar om uppgifter som genomförs i en terminalmiljö och kräver att modellen använder verktyg, arbetar med filer och tar sig igenom flera beroende steg. Resultatet är alltså inte bara ett mått på om modellen kan skriva kod. Den behöver också kunna navigera i miljön, förstå återkoppling och justera sin plan.
Ökningen är mer än sexfaldig. Enligt Z.ai är 28,3 det bästa resultatet bland modeller med öppna vikter i den aktuella jämförelsen.
I DeepSWE v1.1, som fokuserar på långvariga uppgifter inom mjukvaruutveckling, går resultatet från 46,2 till 66,9. Även Agents’ Last Exam förbättras, från 23,8 till 28,5.
Det senare lyftet är mindre dramatiskt, men testet omfattar ett bredare urval av agentuppgifter. Det ger stöd för att förbättringarna inte är helt begränsade till ren kodgenerering.
Z.ai anser att GLM-5.3 ligger i nivå med Claude Fable 5 inom programmering och agenter. I företagets eget kodningstest är Claude-modellen dock fortfarande starkare på den högsta beräkningsnivån.
Bättre resultat med färre utdatatokens
Förutom de offentliga testerna introducerar Z.ai ett internt test kallat Z.ai Code Bench. Det är utformat för att efterlikna vanliga användarscenarier för kodningsagenter och placerar modellerna i komplexa lokala utvecklingsmiljöer.
Bedömningen görs längs två huvudspår. Det ena är hur stor andel av uppgiften som slutförs från början till slut. Det andra är mer detaljerad träffsäkerhet mot en checklista över krav och delmål.
Eftersom testet är privat minskar risken att modellerna har sett själva uppgifterna i sitt träningsmaterial. Nackdelen är att resultaten inte kan granskas och återskapas lika enkelt av utomstående. De bör därför betraktas som Z.ai:s egen utvärdering, inte som en helt oberoende mätning.
På den högsta ansträngningsnivån når GLM-5.3 ett resultat på 34,5 procent och använder omkring 75 000 utdatatokens per uppgift. GLM-5.2 får 23,4 procent samtidigt som den förbrukar ungefär 96 000 tokens.
Det handlar alltså inte bara om högre kvalitet. Den nya modellen använder även mindre utdatamängd för att nå resultatet.
På nivån High får GLM-5.3 31,4 procent med omkring 50 000 utdatatokens. Z.ai jämför det med Claude Opus 4.8, som når 29,5 procent men använder ungefär 120 000 tokens. Claude Fable 5 ligger däremot fortfarande före och når 39,5 procent på Max.
Resultaten antyder att efterträningen har gjort modellen mer fokuserad. Den kommer längre med färre genererade tokens, vilket kan påverka både kostnad och svarstid. Samtidigt är den starkaste stängda modellen i jämförelsen fortfarande klart bättre på den mest krävande nivån.
Från programmering till bredare yrkesuppgifter
GLM-5.3 har också testats på GDPval-AA v2, som täcker arbetsuppgifter från 44 yrkeskategorier. Där får modellen 1 769 poäng.
Z.ai använder resultatet för att visa att förmågan kan överföras från programmering till mer allmänt professionellt arbete. Modellen har tränats i miljöer där den behöver hantera dokument, analysera tekniska problem, använda externa resurser och leverera ett kontrollerbart slutresultat.
Kodning är fortfarande modellens tydligaste profil. Men mycket av det som krävs för att lyckas i en lång kodningsuppgift, som planering, informationssökning, verktygsanvändning, felsökning och verifiering, går även att använda inom andra yrkesområden.
Det är en viktig del av utvecklingen mot bredare AI-agenter. En agent som kan arbeta självständigt i en terminal eller ett kodarkiv har redan flera av de grundfunktioner som krävs för att genomföra andra digitala arbetsflöden.
Träningsmiljön blir lika viktig som modellen
När en agent blir bättre flyttar en del av svårigheten från själva modellen till miljön runt den. En användbar träningsuppgift måste gå att köra, ha ett lösbart mål och ge en tillförlitlig signal om huruvida modellen lyckades.
Det räcker inte att konstruera ett litet antal handskrivna miljöer. För att skala efterträningen behövs många uppgifter med olika verktyg, beroenden och dolda tillstånd. Z.ai har därför byggt processer som automatiskt tar fram kompletta träningsmiljöer.
Forskningsagenter samlar in mönster från verkligt arbete och omvandlar dem till körbara uppgifter. Dessa kan bestå av många steg där ett tidigt beslut påverkar vad som händer senare. En särskild bedömningsagent försöker sedan lösa uppgiften för att kontrollera att den faktiskt är möjlig.
Även verifierarna, alltså systemen som avgör om modellen har lyckats, kan genereras automatiskt. De skapas utan tillgång till referenslösningen. Lösningsförsök används därefter för att upptäcka och stänga genvägar där modellen skulle kunna få belöning utan att egentligen lösa uppgiften.
En verifierare måste klara flera kontroller. Den ska godkänna en korrekt lösning, underkänna ett försök där ingenting görs och även känna igen ett olöst tillstånd. Först när dessa krav är uppfyllda används den binära belöningssignalen direkt i träningen.
Z.ai medger att processen fortfarande kräver en meningsfull mängd mänskligt arbete. Ett kommande mål är att göra genereringen och verifieringen av träningsmiljöer mer självständig.
SAO ska bevara resultaten genom långa arbetsförlopp
GLM-5.3 använder vidareutvecklade strategier för förstärkningsinlärning från GLM-5.2. En av dem är SAO med komprimering, eller compaction.
När en agent arbetar länge samlas stora mängder historik: instruktioner, verktygsresultat, testloggar, felmeddelanden och tidigare försök. Om allt behålls i oförändrad form blir kontexten snabbt dyr och svår att hantera. Komprimering används för att kondensera äldre delar av arbetsförloppet utan att modellen tappar den information som fortfarande behövs.
Syftet är att förbättringarna ska hålla i sig under långvariga uppgifter och inte bara synas i korta kodproblem. Resultaten på Terminal-Bench och DeepSWE talar för att metoden har haft effekt, även om offentliga tester förstås inte fångar varje situation som kan uppstå i verkliga projekt.
Cybersäkerhetsförmågan växte snabbare än väntat
Den mest uppseendeväckande delen av GLM-5.3 är utvecklingen inom cybersäkerhet.
Z.ai lade in data och träningsmiljöer för sårbarhetsanalys i efterträningen. Förväntningen var att modellen skulle bli bättre på att läsa källkod, hitta brister och resonera om deras konsekvenser. När träningen skalades upp började modellen enligt företaget utveckla förmågan snabbare än väntat.
GLM-5.3 nöjde sig inte med att märka ut misstänkta kodstycken. Den blev bättre på att koppla samman flera steg och skapa sammanhängande exploateringskedjor.
En sådan utveckling har två sidor. Samma förmåga kan hjälpa säkerhetsgranskare att hitta allvarliga fel innan de utnyttjas. Den kan också användas offensivt om modellen får tillgång till mål, verktyg och tillräckliga instruktioner.
Det är en av anledningarna till att de öppna modellvikterna hålls tillbaka i två veckor efter lanseringen. Z.ai uppger att perioden ska användas för ytterligare säkerhetsutvärdering och härdning.
Bäst på CyberGym i Z.ai:s jämförelse
Z.ai har testat GLM-5.3 på tre säkerhetsmätningar som täcker olika delar av arbetet med sårbarheter.
På CyberGym får modellen 84,5 procent. GLM-5.2 låg på 77,2 procent. Resultatet placerar enligt Z.ai GLM-5.3 högst i jämförelsen, strax före Mythos 5 på 83,8 procent och GPT-5.6 Sol på 83,6 procent.
CyberGym börjar med tillgång till källkoden. Modellen ska hitta möjliga sårbarheter och validera dem genom att framkalla fel. Det är där GLM-5.3 är som starkast: tidigt i exploateringskedjan, när koden kan granskas direkt och en misstänkt brist ska identifieras.
På ExploitBench blir förbättringen större i relativa tal. GLM-5.3 når 54,4 procent, upp från 24,4 procent för GLM-5.2. Resultatet har alltså mer än fördubblats.
Här ligger modellen fortfarande långt bakom den stängda fronten. Mythos 5 får 78,0 procent och GPT-5.6 Sol 76,5 procent. ExploitBench kräver djupare resonemang om verkliga sårbarheter och hur de kan utnyttjas.
Mönstret är tydligt. GLM-5.3 har blivit mycket bättre genom hela kedjan, men dess främsta styrka finns fortfarande i upptäckt och inledande validering. Ju närmare ett komplett utnyttjande uppgiften kommer, desto större är avståndet till de starkaste stängda modellerna.
Fler genomförda uppgifter i ExploitGym
ExploitGym mäter hur många exploateringsuppgifter en modell kan genomföra inom en normaliserad tidsbudget. Budgeten justeras utifrån respektive modells genomströmning för att jämförelsen ska bli rimligare.
GLM-5.3 klarar 105 uppgifter inom två timmar och 130 inom sex timmar. GLM-5.2 klarade 29 respektive 39.
Även här är förbättringen stor, men Mythos 5 ligger långt före med 181 uppgifter på två timmar och 247 på sex timmar.
Z.ai beskriver utvecklingen som att kapaciteten växer snabbast där modellen tidigare låg längst efter. Det är positivt för modellens tekniska utveckling, men gör samtidigt säkerhetsfrågan mer angelägen. Om fortsatt efterträning ger lika stora lyft kan dagens avstånd till de stängda modellerna minska snabbt.
Tusentals sårbarheter hittade i verkliga kodbaser
För att undersöka om resultaten går att överföra utanför kontrollerade testmiljöer har Z.ai samarbetat med flera kinesiska säkerhetsteam. Modellerna har använts för att granska verkliga kodbaser sedan GLM-5.2.
Efter expertgranskning, filtrering och borttagning av dubbletter ska modellerna ha identifierat 2 436 sårbarheter i 269 projekt. Av dessa klassificerades 1 097 som problem med medelhög eller hög allvarlighetsgrad.
Fynden finns enligt Z.ai inom ett brett tekniskt område:
- systemkärnor
- operativsystem
- webbläsarmotorer
- öppen infrastruktur
- webbapplikationer
- nätverksprotokoll
En del av bristerna ska ha funnits oupptäckta i många år. Den äldsta uppges kunna spåras ungefär 40 år tillbaka i tiden.
Siffrorna kommer från Z.ai och dess samarbetspartner. Exakt hur många fynd som har bekräftats av berörda projekt, tilldelats CVE-nummer eller rättats framgår inte av lanseringstexten. Företaget har därför skapat Z.ai Security Disclosure Ledger, ett register som ska följa sårbarheterna genom den samordnade publiceringsprocessen.
Registret skiljer mellan problem som redan har offentliggjorts och sådana som fortfarande hanteras under sekretess. För publicerade sårbarheter ska det bland annat ange berört projekt, allvarlighetsgrad, eventuellt CVE-nummer och hur länge felet fanns i kodbasen.
Det är en viktig detalj. Att hitta en möjlig sårbarhet är bara början. Fyndet måste återskapas, bedömas, rapporteras på ett ansvarsfullt sätt och åtgärdas utan att informationen först används för angrepp.
Öppna modellvikter först efter säkerhetsarbete
Z.ai kallar GLM-5.3 för den främsta modellen med öppna vikter inom kodning, men vikterna finns inte tillgängliga vid själva lanseringen. De planeras att publiceras två veckor senare.
Företaget anger säkerhetsutvärdering och härdning som skäl till fördröjningen. Det är särskilt relevant med tanke på förbättringarna i ExploitBench och ExploitGym.
När en modell endast finns genom ett API kan leverantören övervaka användningen, ändra säkerhetsfilter, begränsa verktyg och stänga av missbruk. Offentligt tillgängliga vikter ger användare mycket större kontroll. De kan köra modellen lokalt, modifiera den och i vissa fall ta bort de skydd som leverantören lagt in.
Några detaljer om licensen, de kommande användningsvillkoren eller exakt vilka säkerhetsåtgärder som införs före publiceringen framgår inte av underlaget. Därför är det än så länge mer precist att tala om en planerad modell med offentliga vikter än att dra långtgående slutsatser om hur fri eller öppen den slutliga distributionen blir.
slime är grunden för efterträningen
All förstärkningsinlärning bakom GLM-5.3 körs genom ramverket slime. Det är ett öppet system som kopplar samman Megatron på träningssidan med SGLang för utrullning, alltså den del där modellen genererar försök och interagerar med träningsmiljöerna.
Arkitekturen låter träning, modellkörningar och databuffertar ligga i samma dataflöde. Matematikuppgifter, kodmiljöer, sandlådor, verifierare och agentbaserade scenarier kan då läggas in som datagenerering i stället för att kräva att själva träningsloopen byggs om.
Det är vad som har gjort det möjligt för Z.ai att fortsätta lägga till nya miljöer genom GLM-5.2 och GLM-5.3 utan att konstruera om hela stacken varje gång.
I den senaste versionen har slime utvecklats på två fronter: algoritmisk kontroll och systemeffektivitet.
Noggrannare kontroll över träning och utrullning
På den algoritmiska sidan har Z.ai lagt till funktioner som top-p-maskering, top-k och OPD över hela ordförrådet. Ramverket stöder även konfigurationer som ska minska skillnaden mellan hur modellen beter sig under träning och hur den genererar svar i utrullningsmiljön.
Bland dessa finns R3-liknande konfigurationer och full numerisk anpassning mellan tränings- och utrullningsvägarna. Syftet är att ge forskarna bättre kontroll över sampling, lärarsignaler och jämförande experiment.
I Z.ai:s test av överensstämmelsen mellan träning och utrullning hölls den genomsnittliga skillnaden i logaritmiska sannolikheter på nivån 10⁻⁷. Företaget beskriver det som en minskning med mer än 99,99 procent jämfört med tidigare uppsättningar.
Det kan låta som en liten teknisk detalj, men skillnader mellan träningsmotorn och systemet som genererar data kan skapa instabilitet. Ju större och längre experimenten blir, desto viktigare är det att båda sidor behandlar modellen på samma sätt.
Mer än dubblerad genomströmning i långvarig RL-träning
Z.ai har även arbetat med resursförbrukningen. Lokal lagring används nu som ett extra cachelager för modellstatus och data som annars skulle behöva ligga i värdminnet.
Det är särskilt användbart vid så kallad OPD med flera lärarmodeller. Genom dynamiska byten och förhandshämtning kan flera lärare användas utan att varje modell kräver en separat, permanent inferenstjänst. Det minskar resursbehovet och begränsar den extra belastningen.
För asynkrona agentuppgifter har schemaläggningen och lastbalanseringen mellan routern och slime förbättrats. Sådana arbetsflöden är svåra att planera eftersom en modellkörning kan ta några sekunder medan en annan fortsätter länge, använder flera verktyg och genererar betydligt mer text.
Systemet analyserar nu arbetsbelastningen och väljer inställningar för bland annat fördelningen mellan prefill och avkodning, samtidighet och andra parametrar som påverkar genomströmningen.
Tillsammans ska optimeringarna ha ökat den totala träningshastigheten med mer än 2,3 gånger för långvariga kodningsuppgifter. Z.ai kan därmed träna på längre förlopp och mer komplexa miljöer utan att resurskostnaden växer i samma takt.
Tre nivåer för modellens resonemang
GLM-5.3 stöder tre nivåer för hur mycket arbete modellen ska lägga på sitt resonemang:
- Low för lättare resonemang och lägre resursförbrukning.
- High för mer krävande uppgifter.
- Max för djupast resonemang och långvariga arbetsflöden.
Max är standardinställningen och rekommenderas av Z.ai för kodningsuppgifter.
Till skillnad från GLM-5.2 går det inte längre att stänga av tänkandet helt. Parametern thinking.type måste vara satt till enabled. En förfrågan med värdet disabled kommer att misslyckas.
En grundläggande API-konfiguration ser ut så här:
{
  "model": "glm-5.3",
  "thinking": {
    "type": "enabled"
  },
  "reasoning_effort": "max"
}
Utvecklare som använder GLM-5.2 med avstängt tänkande behöver ändra sin integration innan modellnamnet byts. Z.ai rekommenderar att thinking.type först sätts till enabled och att reasoning_effort anges som low. Därefter kan modell-id:t ändras till glm-5.3.
Det är en migrering som måste göras uttryckligen. Att bara ersätta modellnamnet kan leda till att befintliga anrop slutar fungera.
Att tänkandet inte kan stängas av innebär också att GLM-5.3 inte nödvändigtvis passar varje enkel och svarstidskänslig uppgift. Low-läget kan begränsa arbetet, men modellen kommer fortfarande att använda sin resonemangsmekanism.
Tillgänglig i flera kodningsagenter
GLM-5.3 kan användas genom ZCode och GLM Coding Plan. Den går också att koppla till externa kodningsmiljöer och agenter som Claude Code och OpenCode.
ZCode har flera funktioner som riktar sig till långvariga projekt. I Goal-läget ska systemet planera, skriva kod, köra tester och kontrollera resultatet tills det uppsatta målet är nått. Användaren kan också följa och styra pågående uppgifter från en mobiltelefon genom WeChat eller Feishu.
Z.ai uppger en cacheträff på över 98 procent för upprepad kontext. Material som redan har behandlats kan då debiteras till den lägre cachenivån. Enligt företaget motsvarar besparingen omkring 30 procent fler effektiva tokens.
Under en begränsad period får användare dessutom 1,5 gånger den vanliga kvoten. Erbjudandet gäller till och med den 31 augusti 2026. När kvotökningen kombineras med cachebesparingen uppger Z.ai att användaren kan få upp till 180 procent av standardkvotens normala räckvidd.
GLM Coding Plan går över till poäng
GLM-5.3 har rullats ut till samtliga användare av GLM Coding Plan. Samtidigt införs ett kvotsystem som bygger på poäng.
Indatatokens, cachade indatatokens och utdatatokens räknas separat. Modellanrop utanför belastningstopparna kostar 50 procent av det vanliga antalet poäng.
Högtrafik gäller mellan klockan 14.00 och 18.00 i tidszonen UTC+8, måndag till fredag. Alla andra tider får den lägre nivån. Det gäller även helger.
För användare i Sverige motsvarar tidsintervallet olika klockslag beroende på sommar- eller vintertid. Själva beräkningen utgår dock från UTC+8, vilket är den tidszon Z.ai anger för abonnemanget.
Det poängbaserade upplägget gör kostnaden mer komplicerad än en rak tokenavgift. Hur långt en kvot räcker påverkas av när modellen används, hur mycket kontext som kan hämtas från cache och hur mycket utdata uppgiften genererar.
Lokal drift blir möjlig efter viktsläppet
När vikterna har publicerats ska GLM-5.3 kunna köras lokalt. Z.ai anger däremot inga hårdvarukrav i lanseringsmaterialet.
Det är en viktig uppgift som fortfarande saknas. En flaggskeppsmodell kan kräva betydande GPU-minne och avancerad inferensinfrastruktur, särskilt vid långa kontexter och Max-läget. Kvantisering och distribuerad körning kan minska kraven, men sådana alternativ beskrivs inte här.
Lokal drift kan vara attraktiv för organisationer som arbetar med känslig kod eller interna dokument. Den ger större kontroll över data, modellversion och tillgänglighet. Den medför samtidigt mer ansvar för säkerhet, övervakning och resursplanering.
Det gäller i synnerhet GLM-5.3. Modellens förmåga att hitta och validera sårbarheter gör den användbar för defensivt säkerhetsarbete, men också känsligare att distribuera utan kontroll.
Resultaten behöver läsas med vissa reservationer
GLM-5.3 visar stora förbättringar, men flera av påståendena kommer från Z.ai:s egna tester och jämförelser.
Z.ai Code Bench är privat och kan därför inte granskas på samma sätt som ett offentligt benchmark. Företaget framhåller att det minskar risken för förorenade testdata, vilket är rimligt, men utomstående kan inte kontrollera uppgifternas svårighetsgrad eller exakt hur modellerna har konfigurerats.
På cybersäkerhetsområdet är bilden blandad. Modellen leder på CyberGym, där den får läsa källkoden och hitta sårbarheter. När uppgifterna går längre mot faktisk exploatering ligger den fortfarande tydligt efter Mythos 5 och GPT-5.6 Sol.
Samma mönster syns inom kodning. GLM-5.3 förbättras kraftigt och slår flera modeller i tokeneffektivitet, men Claude Fable 5 är fortfarande bättre på den högsta nivån i Z.ai Code Bench.
Det gör inte förbättringen mindre intressant. Däremot är GLM-5.3 inte överlägsen på varje område. Modellens främsta styrka är kombinationen av öppna vikter, stark kodning, långa agentuppgifter och en snabbt växande förmåga inom säkerhetsanalys.
Ett tydligt exempel på vad efterträning kan åstadkomma
Den stora tekniska poängen med GLM-5.3 är att basmodellen inte har förändrats. Z.ai har fått fram lyften genom att träna den vidare i fler och bättre miljöer.
Terminal-Bench 3.0 går från 4,6 till 28,3. DeepSWE v1.1 stiger från 46,2 till 66,9. På ExploitBench går resultatet från 24,4 till 54,4. Samtidigt använder modellen färre utdatatokens i företagets interna kodningstest.
Det visar hur stor betydelse träningsmiljöerna har fått. Nästa generations förbättringar behöver inte alltid komma från fler parametrar eller en ny grundmodell. De kan lika gärna uppstå när en befintlig modell får arbeta med bättre uppgifter, tydligare verifiering och längre återkopplingsförlopp.
Utvecklingen har dock en säkerhetsmässig baksida. När samma träning som ger bättre problemlösning även stärker modellens förmåga att skapa exploateringskedjor blir det svårare att skilja produktiv kapacitet från risk. Fördröjningen av viktsläppet visar att Z.ai är medvetet om detta, men lanseringsmaterialet ger ännu ingen fullständig bild av vilka skydd som kommer att finnas när modellen kan köras fritt.
GLM-5.3 är ändå ett stort steg från GLM-5.2. Den skriver inte bara bättre kod. Den kan arbeta längre, använda mer komplexa miljöer och själv kontrollera en större del av processen. Samtidigt har den blivit en betydligt starkare säkerhetsmodell, på gott och ont.
För utvecklare är frågan nu hur väl benchmarkresultaten håller i riktiga kodbaser. För säkerhetsbranschen är frågan större: vad händer när modeller med den här förmågan blir fritt tillgängliga och fortsätter förbättras genom efterträning? GLM-5.3 ger inget slutligt svar, men den visar tydligt att den utvecklingen redan är i gång.
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.