Haiku 5.5 får för första gången i Haiku-serien en valbar tankenivå. Dess kontextfönster rymmer också fem gånger så många token som Haiku 4.5:s. Anthropic beskriver i lanseringen av Claude Haiku 5.5 en modell för bland annat sammanfattningar, sortering av information, kundsupport och avgränsade deluppgifter åt större modeller.
Vad kan Claude Haiku 5.5 användas till?
Haiku 5.5 är tänkt för arbete där många små uppgifter ska lösas snabbt och kostnaden för varje svar spelar stor roll. Den kan exempelvis plocka ut en uppgift ur ett dokument, sortera kundärenden eller sammanfatta en lång konversation så att ett program kan fortsätta arbeta med en kortare version. I ett större kodprojekt kan Opus 5.5 eller Sonnet 5.5 leda arbetet och ge Haiku en begränsad deluppgift. En sådan hjälpare kallas en underagent.
Anthropic kallar Haiku 5.5 sin snabbaste modell vid ordinarie hastighet. Opus i Fast Mode är dock snabbare, enligt företagets fotnot. Hastigheten för en viss uppgift beror också på hur mycket modellen tänker innan den svarar.
Några kunder redovisar tidiga resultat i lanseringsmaterialet. Asana uppger över 30 procent kortare tid till slutförda uppgifter och upp till 2,5 gånger snabbare svar per agentsteg jämfört med modellen företaget använder i dag, som inte namnges. AlphaSense testade 400 dokumentfrågor och rapporterar ett resultat på 0,84 för Haiku 5.5 mot 0,76 för Haiku 4.5. Box uppger 11 poäng högre resultat än Haiku 4.5 med ungefär halva svarstiden. Det är kundernas mätningar på deras egna uppgifter, återgivna av Anthropic.
Vad kostar Claude Haiku 5.5?
För anrop med högst 100 000 token i inmatningen kostar Haiku 5.5 0,10 dollar per miljon inmatade token och 0,50 dollar per miljon utmatade token. Token är de textbitar modellen läser och skriver, och de används för att beräkna API-kostnaden. Ett API låter ett program anropa modellen direkt.
Över gränsen stiger priserna till 0,50 respektive 2,50 dollar per miljon token. Den högre prisnivån gäller alltså anrop med längre inmatning. Jämfört med Haiku 4.5 är priset per token 90 procent lägre under gränsen och 50 procent lägre över den.
Anthropics priser per miljon token
| Pris per 1 miljon token | Haiku 5.5, inmatningar upp till / över 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Cacheläsning | $0,01 / $0,05 | $0,10 | $0,10 |
| Cacheskrivning | $0,125 / $0,625 | $1,25 | $2,50 |
| Inmatade token | $0,10 / $0,50 | $1,00 | $2,00 |
| Utmatade token | $0,50 / $2,50 | $5,00 | $10,00 |
Tabellen visar Anthropics listpriser. Haiku 5.5 har lägst pris i alla kategorier, även för längre inmatningar. Cache betyder här att återanvändbart material sparas så att programmet kan läsa det igen till lägre pris. Att skriva till cachen kostar mer än att läsa ur den. Sonnet 5.5 och Haiku 4.5 har samma pris för cacheläsning i tabellen, efter den prissänkning för Sonnet som följer med lanseringen.
Anthropic uppskattar att Haiku 5.5 i genomsnitt kostar omkring 75 procent mindre per uppgift än Haiku 4.5. Det är en annan jämförelse än priset per token: den tar hänsyn till både längden på tidigare Haiku-anrop och hur många token den nya modellen använder. Dokumentationen anger att samma text räknas som ungefär 30 procent fler token med Haiku 5.5:s nya sätt att dela upp text. Batchanrop, där flera uppgifter skickas för bearbetning tillsammans, ger 50 procents rabatt på inmatning och utmatning.
Haiku 5.5 i Anthropics jämförelser
Anthropics huvudtabell visar stora förbättringar från Haiku 4.5. Sonnet 5.5 har samtidigt det högsta redovisade resultatet på varje rad. På FrontierCode finns en viktig inställningsskillnad: Sonnets resultat i huvudtabellen är från Xhigh. I systemkortet får Haiku 46,4 procent och Sonnet 46,2 procent när båda använder Max, medan Sonnet når sitt bättre resultat på Xhigh.
Anthropics prestandajämförelse för Haiku 5.5
| Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 som jämförelse | ||
|---|---|---|---|---|---|
| Yrkesuppgifter (GDPval-AA v2.1) | 1620 | 735 | 1437 | 1840 | |
| Yrkesuppgifter (AA-Briefcase v1.1) | 1578 | 614 | 1336 | 1824 | |
| Datoranvändning (OSWorld 2.1) | 72,4 %, Delmängd utan internetåtkomst | 15,7 %, Delmängd utan internetåtkomst | 48,9 %, Delmängd utan internetåtkomst | 83,9 %, Delmängd utan internetåtkomst | |
| Resonemang inom flera ämnen (Humanity’s Last Exam) | 45,9 %, utan verktyg / 57,4 %, med verktyg | 10,2 %, utan verktyg / 18,7 %, med verktyg | — / — | / | 56,9 %, utan verktyg / 64,5 %, med verktyg |
| Kodarbete med självständiga agenter (Terminal-Bench 4.0) | 39,2 % | 0,0 % | 16,4 % | 70,6 % | |
| Kodarbete med självständiga agenter (FrontierCode 1.1 (huvuddel)) | 46,4 % | - | 42,4 % | 52,1 %, Xhigh | |
| Visuellt resonemang (Chartography) | 46,4 %, utan verktyg | 6,4 %, utan verktyg | 29,1 %, utan verktyg | 61,6 %, utan verktyg |
Resultaten kommer från flera utvärderare. Artificial Analysis har gjort mätningarna av yrkesuppgifter i GDPval-AA oberoende, och Cognition har gjort mätningarna i FrontierCode. Övriga resultat redovisas av Anthropic med konkurrentuppgifter från publicerade källor eller egna jämförande försök. Streck och tomma celler betyder att ett resultat inte redovisas. Haikus resultat i systemkortets sammanställning bygger i regel på Max och ett genomsnitt av fem försök, snarare än den förvalda nivån Medium.
För datorprovet OSWorld är resultatet 72,4 procent ett delpoängsmått som ger poäng för avklarade steg. Andelen försök där Haiku uppfyllde samtliga krav var 37,1 procent, enligt systemkortet. Det högre talet betyder alltså inte att modellen klarade lika stor andel av uppgifterna helt.
De två första radernas tal är Elo-poäng, en relativ rangordning utifrån jämförelser mellan svar, och ska inte läsas som procent rätt. GDPval-AA prövar arbetsuppgifter inom 44 yrken. Anthropic framhåller att Haiku 5.5 når 1 620 Elo på Max, jämfört med 735 för Haiku 4.5, men fortfarande ligger efter Sonnet 5.5 på 1 840.
Hur påverkar tankenivån Haiku 5.5?
Haiku 5.5 använder adaptivt tänkande: modellen avgör hur mycket den behöver resonera, med den valda tankenivån som styrning. Nivåerna är Low, Medium, High, Xhigh och Max. Medium är förvald i API:t. Mer tänkande kan förbättra svaret, men ökar också mängden utmatade token och tiden det tar.
Anthropics jämförelse på GDPval-AA visar hur mycket kostnaden kan ändras. Haiku 5.5 går från 1 125 Elo och 0,01 dollar per uppgift på Low till 1 620 Elo och 0,87 dollar på Max. På Medium får modellen 1 277 Elo, och enligt systemkortet använder den ungefär en tiondel så många utmatade token som på Max.
Resultat och kostnad på GDPval-AA vid olika tankenivåer
| Effort (Elo, as reported · Cost per task (USD, log scale)) | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| Low | 1125, $0,01 | 1179, $0,22 | 1036, $0,004 | |
| Med | 1277, $0,03 | 1324, $0,27 | 1262, $0,02 | |
| High | 1420, $0,09 | 1551, $0,62 | 1344, $0,03 | |
| Xhigh | 1513, $0,27 | 1731, $1,88 | 1364, $0,05 | |
| Max | 1620, $0,87 | 735, $0,24 | 1840, $6,78 | 1437, $0,09 |
Sonnet 5.5 har högst Elo på varje nivå i tabellen. Haiku 5.5 är billigare än Sonnet, men GPT-6 Luna kostar mindre än Haiku på samtliga tankenivåer i tabellen. På Max ger Haiku 5.5 ett högre resultat än Haiku 4.5 till högre kostnad per uppgift. Ett lägre tokenpris betyder alltså inte att varje färdigt arbete blir billigare. Resultaten är Artificial Analysis mätningar, återgivna av Anthropic. Elo anger relativ kvalitet, och dollarbeloppen är genomsnittlig kostnad per uppgift.
Aipress testar Haiku 5.5 på sju vardagsuppgifter
Aipress.se gav Haiku 5.5, Sonnet 5.5 och Opus 5.5 samma uppgifter med samma text. Provet omfattar korrektur, kodfel, avläsning av ett kvitto och ett foto, väderuppgifter via ett verktyg samt skapande av Excel- och PowerPoint-filer. Tabellen visar resultat, uppmätt svarstid och kostnad beräknad med Anthropics listpris för anropen. Alla modeller använde Medium. Token ut omfattar både svaret och modellens tänkande, med tanketoken inom parentes.
| Uppgift | Haiku 5.5: resultat | Haiku 5.5: tid | Haiku 5.5: tokens ut (varav tankar) | Haiku 5.5: kostnad | Sonnet 5.5: resultat | Sonnet 5.5: tid | Sonnet 5.5: kostnad | Opus 5.5: resultat | Opus 5.5: tid | Opus 5.5: kostnad |
|---|---|---|---|---|---|---|---|---|---|---|
| Rätta ett kundmejl med sju inlagda fel | 6 av 7 (lät felet i datumet stå) | 6,6 s | 1 512 (1 181) | 0,000934 USD | 7 av 7 | 4,7 s | 0,0076 USD | 7 av 7 | 9,8 s | 0,0244 USD |
| Hitta två fel i en Python-funktion som räknar ihop en varukorg | 2 av 2, plus en ändring som inte begärts (round(summa, 2)) |
5,9 s | 1 051 (693) | 0,000697 USD | 2 av 2, plus samma avrundningsändring | 4,1 s | 0,0064 USD | 2 av 2, plus samma avrundningsändring | 8,8 s | 0,0177 USD |
| Göra ett kvitto till JSON och kontrollera summan | värdena rätt, men JSON i ett kodblock | 4,7 s | 829 (506) | 0,000596 USD | värdena rätt, men JSON i ett kodblock | 5,9 s | 0,0106 USD | värdena rätt, JSON i kodblock | 7,0 s | 0,0195 USD |
| Kolla vädret för två orter via ett verktyg | rätt (båda orterna, rätt slutsats) | 4,0 s | 412 (115) | 0,000501 USD | rätt | 4,8 s | 0,0086 USD | rätt | 7,1 s | 0,0184 USD |
| Läsa en prislista på ett foto och räkna ihop en beställning | rätt summa, 156, direkt | 3,6 s | 398 (134) | 0,000743 USD | 156, men skrev först 113 i samma svar | 4,5 s | 0,0134 USD | 156 | 7,3 s | 0,0274 USD |
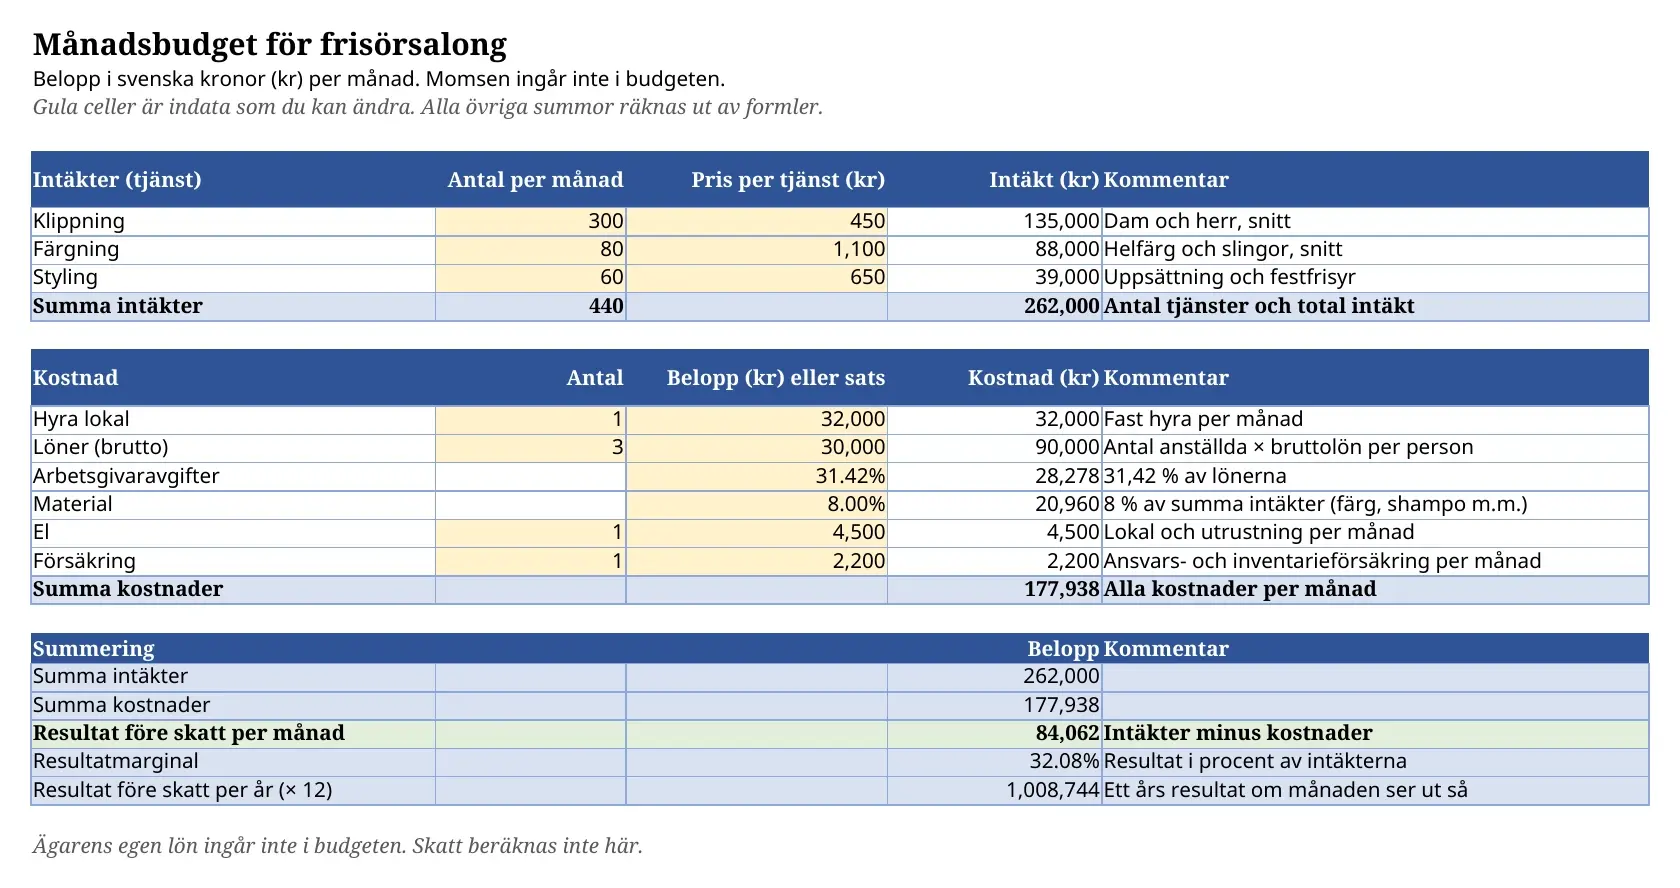
| Excel-fil: månadsbudget för en frisörsalong med riktiga formler | 9 av 9 krav | 43,6 s | 10 019 (4 622) | 0,0145 USD | 9 av 9 krav | 30,6 s | 0,1827 USD | 9 av 9 | 74,7 s | 0,5130 USD |
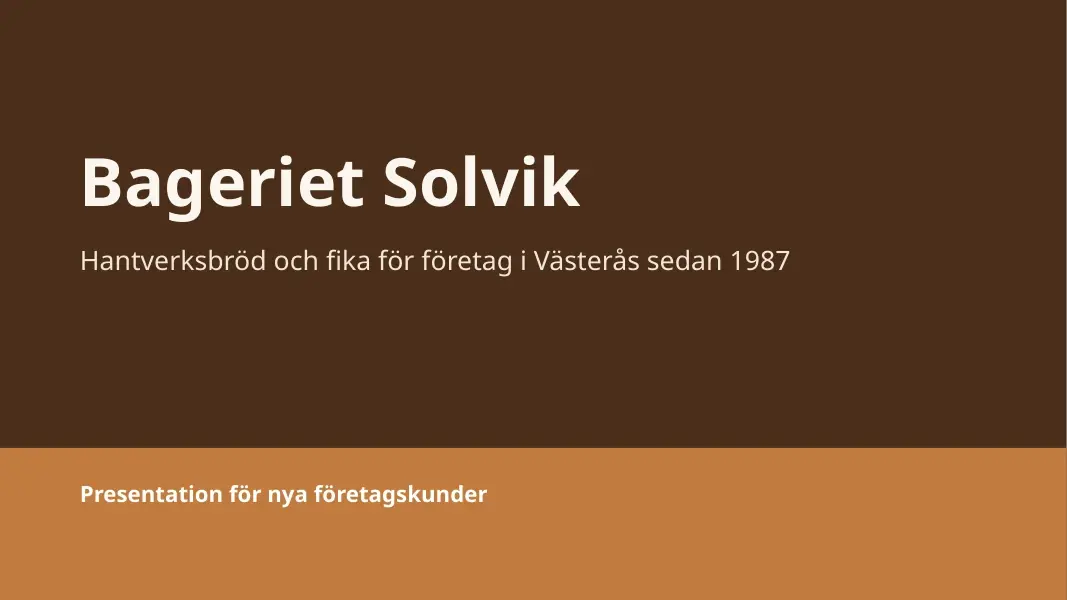
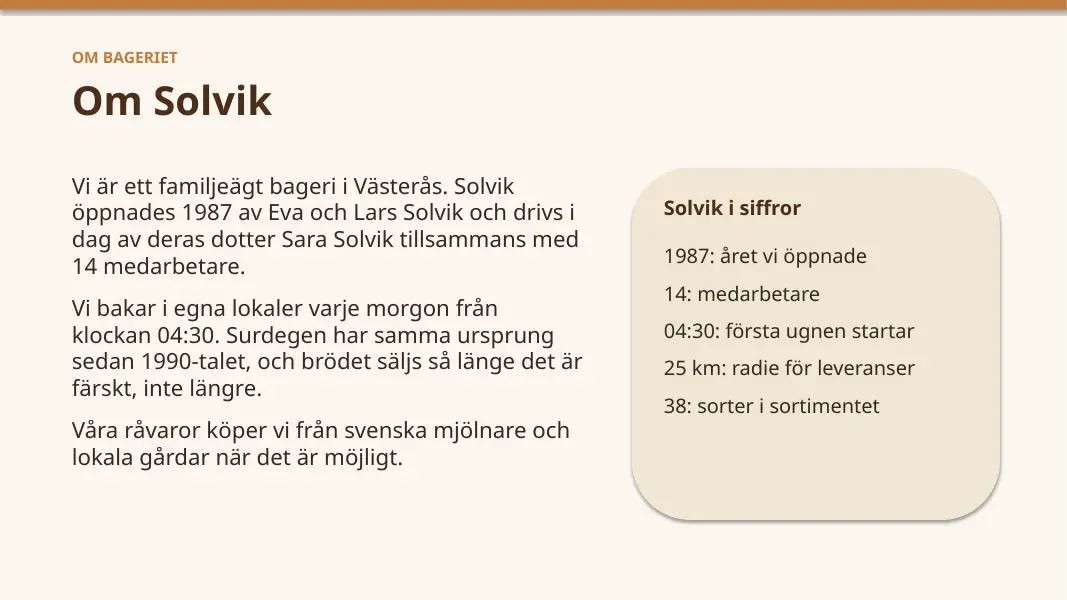
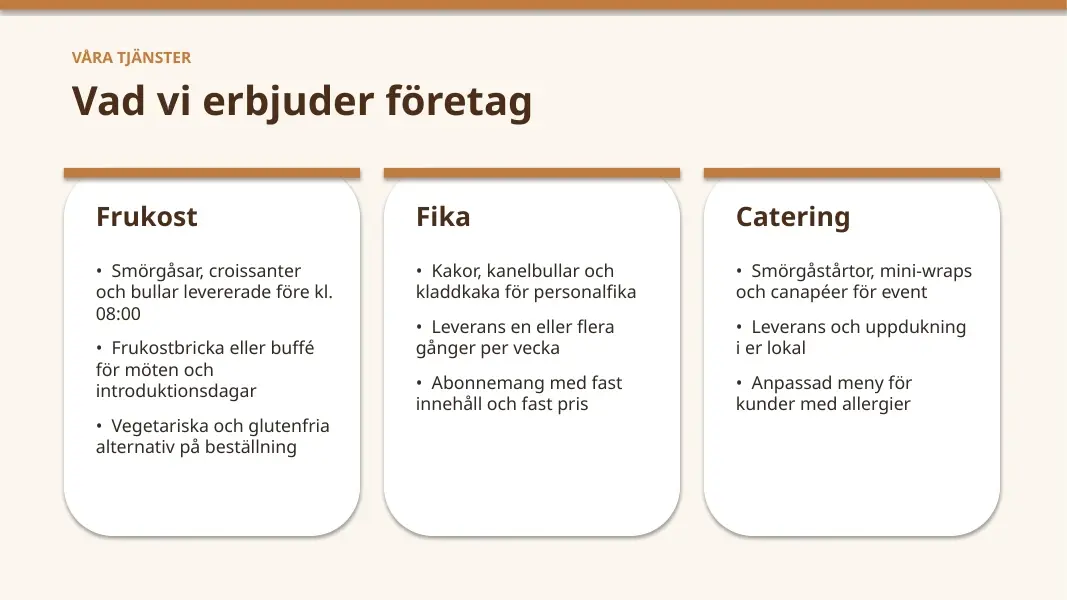
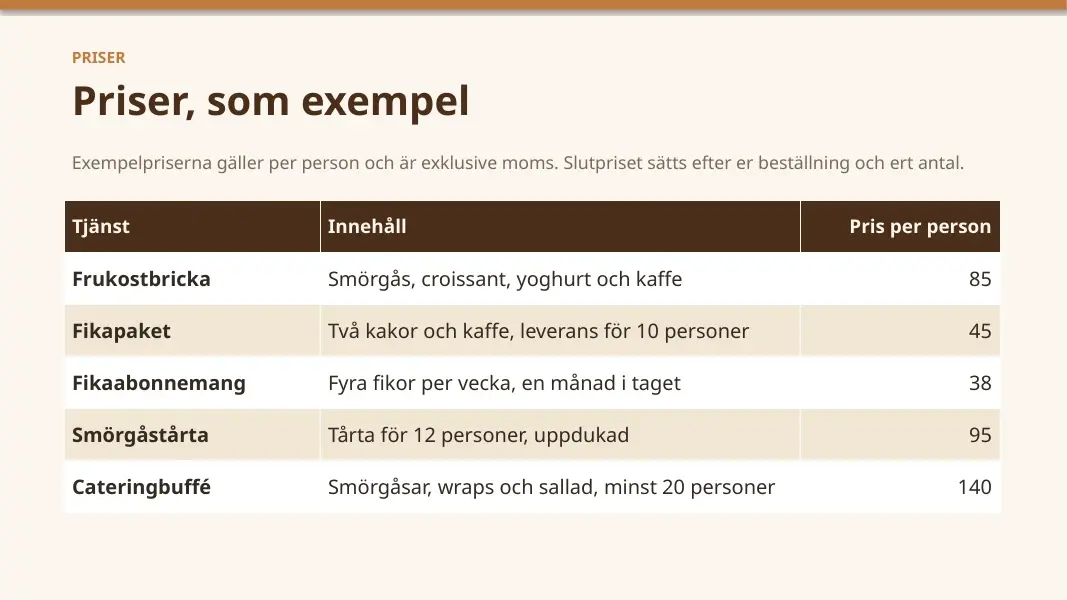
| PowerPoint-fil: fem bilder för ett bageri som presenterar sig för en företagskund | 10 av 10 krav | 37,5 s | 8 503 (2 364) | 0,0118 USD | 10 av 10 krav | 48,0 s | 0,1837 USD | 10 av 10 | 74,1 s | 0,4389 USD |
| Summa sju uppgifter | 5 av 7 helt rätt | 105,9 s | 22 724 (9 615) | 0,0298 USD | 5 av 7 helt rätt | 102,6 s | 0,413 USD | 6 av 7 helt rätt | 188,8 s | 1,059 USD |
Haiku och Sonnet klarade fem av sju uppgifter helt, medan Opus klarade sex. Haiku missade ett datumfel i kundmejlet och nämnde inte det kvarvarande felet i sin ändringslista. Alla tre modeller återgav kvittots värden rätt men lade JSON-svaret i ett kodblock, en särskilt markerad textruta. Uppgiften krävde enbart JSON, ett strukturerat dataformat, så svaren gick inte att läsa in direkt som JSON utan att först ta bort markeringen.
I Python-uppgiften hittade alla tre modeller de två avsedda felen men ändrade också avrundningen utan att ha blivit ombedda. Det gav 672,3 i ett av facitets fall, där facit var 672. På fotot av prislistan gav Haiku däremot rätt summa direkt, medan Sonnet först skrev en felaktig summa och rättade sig i samma svar.
Excel-filen från Haiku uppfyllde alla nio krav. Den hade 17 formler med sparade uträknade värden, så resultaten fanns tillgängliga redan när filen öppnades. Modellen lade också till bland annat arbetsgivaravgifter, marginal och årsresultat. Den egna förhandsbilden använde engelska talformat, exempelvis kommatecken mellan tusental och punkt i procenttal, och innehöll stavningen ”shampo”.
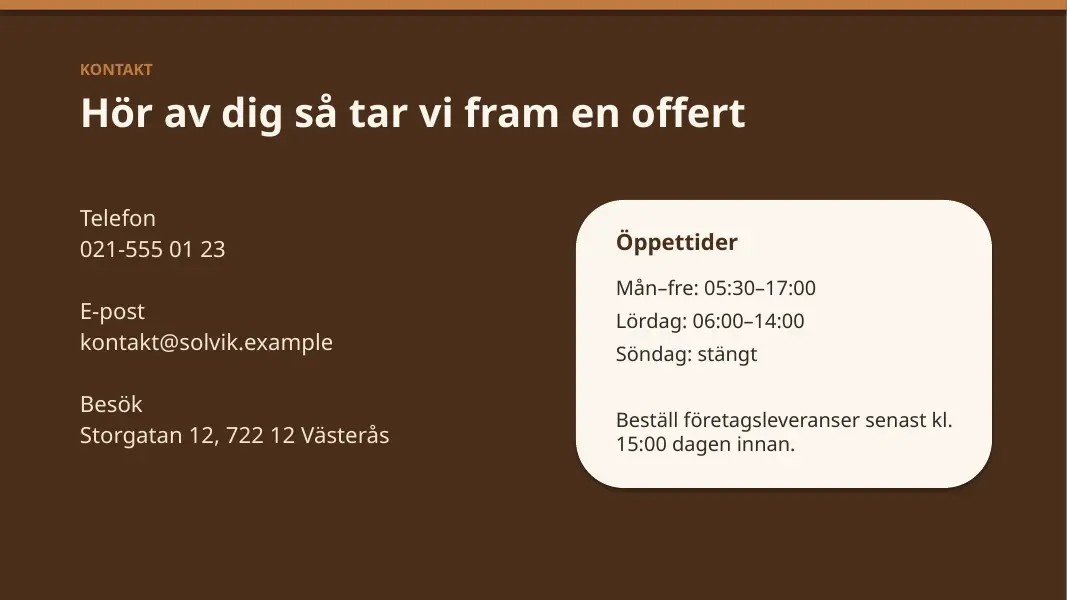
PowerPoint-filen uppfyllde alla tio krav och hade fem bilder med tydliga rubriker och text inom bildytan. Presentationen gällde det påhittade Bageriet Solvik. Modellen förklarade i svaret att bageriet var påhittat, men det framgick inte på själva bilderna, som innehöll kontaktuppgifter.
| Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Haiku 5.5 mot Sonnet 5.5 | Haiku 5.5 mot Opus 5.5 | |
|---|---|---|---|---|---|
| tokens ut | 22 724 | 13 018 | 18 283 | +74,6 % | +24,3 % |
| sekunder (hela svarstiden) | 105,9 | 102,6 | 188,8 | +3,2 % | -43,9 % |
| kostnad | 0,0298 USD | 0,413 USD | 1,059 USD | -92,8 % | -97,2 % |
Haiku hade lägst listkostnad: 0,0298 dollar för de sju uppgifterna, mot 0,413 dollar för Sonnet och 1,059 dollar för Opus. Trots att Haiku skrev fler token än båda jämförelsemodellerna blev kostnaden 92,8 procent lägre än Sonnets och 97,2 procent lägre än Opus kostnad.
Sonnet var snabbast sammanlagt med 102,6 sekunder, strax före Haiku på 105,9 sekunder. Opus tog 188,8 sekunder. Haiku använde tanketoken på alla sju uppgifter, Sonnet på tre. Haiku var långsammare än Sonnet på Excel-filen men snabbare på presentationen. Resultaten gäller dessa uppgifter och försök, och visar inte att någon modell alltid är snabbast eller mest korrekt.
Hjälper mer tänkande Haiku 5.5 med korrektur?
Korrekturprovet prövar om modellerna hittar och rättar sju inlagda fel i samma kundmejl. Aipress testade mejlet på alla fem tankenivåer. Varje cell visar rättade fel, uppmätt tid, utmatade token med tanketoken inom parentes och kostnad enligt Anthropics listpris.
| Tankenivå | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| low | 7 av 7 · 5,5 s · 1 250 (892) · 0,000803 USD | 7 av 7 · 4,7 s · 479 (0) · 0,0078 USD | 7 av 7 · 8,1 s · 737 (163) · 0,0207 USD |
| medium | 6 av 7 · 6,6 s · 1 512 (1 181) · 0,000934 USD | 7 av 7 · 4,7 s · 464 (0) · 0,0076 USD | 7 av 7 · 9,8 s · 920 (399) · 0,0244 USD |
| high | 7 av 7 · 9,6 s · 2 528 (2 150) · 0,00144 USD | 6 av 7 · 5,8 s · 758 (382) · 0,0106 USD | 7 av 7 · 11,6 s · 1 107 (583) · 0,0281 USD |
| xhigh | 7 av 7 · 9,8 s · 2 484 (2 118) · 0,00142 USD | 6 av 7 · 10,7 s · 1 527 (1 082) · 0,0183 USD | 7 av 7 · 15,7 s · 1 583 (970) · 0,0376 USD |
| max | 7 av 7 · 67,8 s · 17 556 (17 068) · 0,00896 USD | 6 av 7 · 43,2 s · 6 733 (6 301) · 0,0703 USD | 7 av 7 · 155,3 s · 17 331 (16 665) · 0,3526 USD |
Opus rättade alla sju fel på varje nivå i dessa försök. Haiku gjorde det på Low, High, Xhigh och Max, men missade datumfelet på Medium. Sonnet missade samma datumfel på High, Xhigh och Max. Mer tänkande gav alltså inte konsekvent bättre korrektur i det här provet.
För Haiku tog Low 5,5 sekunder och Max 67,8 sekunder. Max kostade också mer och lade till en obeställd anmärkning om att en tidsangivelse borde kontrolleras innan mejlet skickades. Ett lyckat försök på Low räcker inte för att slå fast att nivån alltid är bäst för korrektur.
Haiku 5.5 skapade ett spelbart asteroidspel
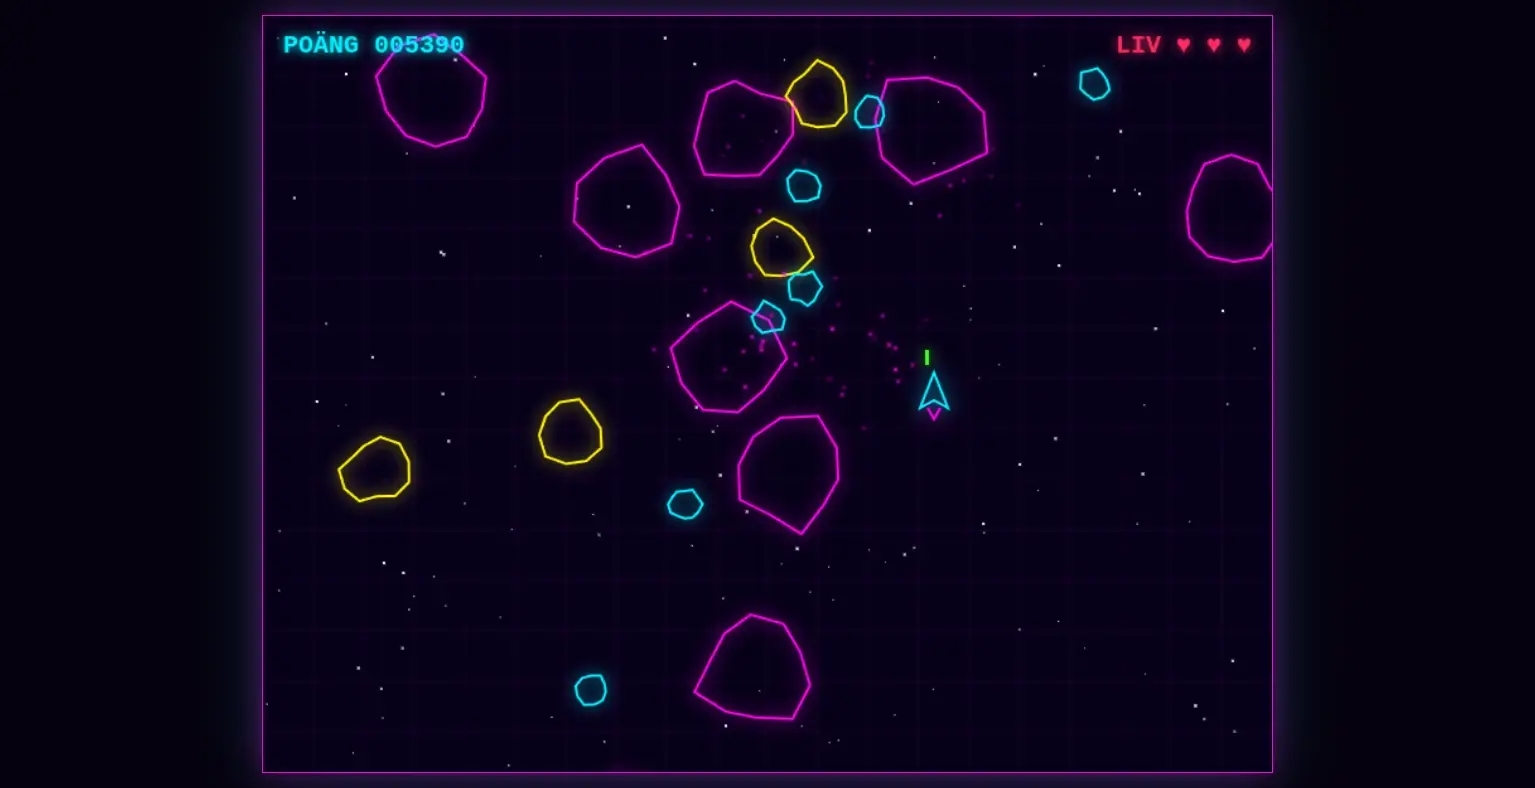
Spelprovet bad modellerna skapa ett litet asteroidspel i cyberpunkstil i en enda HTML-fil, som går att öppna i en webbläsare. Frågan var om de oredigerade spelen gick att spela för en människa. Alla tre modeller använde Medium.
| Modell och tankenivå | Spelbart för en människa | Rader kod | Tokens ut (varav tankar) | Tid | Kostnad |
|---|---|---|---|---|---|
| Haiku 5.5, medium | ja | 378 | 12 626 (7 460) | 40,6 s | 0,00646 USD |
| Sonnet 5.5, medium | ja | 418 | 5 560 (0) | 29,3 s | 0,0579 USD |
| Opus 5.5, medium | ja | 518 | 7 465 (383) | 54,4 s | 0,1539 USD |
Alla tre spel var spelbara. Sonnet skapade sitt spel snabbast, på 29,3 sekunder, följt av Haiku på 40,6 sekunder och Opus på 54,4 sekunder. Haiku hade lägst listkostnad, 0,00646 dollar, trots att modellen skrev flest token. Haikus spel heter ”Neon Asteroider”. Bedömningen gäller de tre spelfilerna, och är inget allmänt mått på modellernas förmåga att utveckla spel.
Haikus sju vardagsuppgifter, de fyra extra korrekturförsöken och asteroidspelet kostade tillsammans 0,0489 dollar enligt listpriset.
Haiku 5.5 får starkare skydd, men kan fortfarande hitta på fakta
Anthropic beskriver förbättrat motstånd mot promptinjektion, alltså instruktioner som en angripare gömmer i material modellen läser för att få den att frångå användarens uppdrag. I en extern utvärdering sjönk andelen lyckade angrepp från 83,2 procent för Haiku 4.5 till 7,1 procent för Haiku 5.5 när angriparen fick 15 försök. Kvarvarande sårbarhet var störst när modellen arbetade i grafiska datorgränssnitt. Sonnet 5.5 och Opus 5.5 var mer motståndskraftiga i den utvärderingen.
Anthropic har skärpt skydden mot skadlig användning inom cybersäkerhet jämfört med Haiku 4.5. De tillåter fler försvarsuppgifter än Sonnets skydd, men blockerar fortfarande bland annat penetrationstestning, där man försöker ta sig in i ett system för att hitta säkerhetsbrister.
Systemkortet beskriver också begränsningar. Haiku 5.5 hittade på fakta ungefär lika ofta som Haiku 4.5 och oftare än andra nyligen släppta Claude modeller. I en bred automatiserad beteendegranskning avvisade modellen ofarliga uppgifter oftare än övriga testade modeller. I ett separat prov med enstaka ofarliga frågor avvisade den däremot färre än Haiku 4.5. Resultaten gäller olika testupplägg.
Anthropic rapporterar dessutom kvarstående brister i svar om självskada och tvekan inför att söka hjälp. Skyddande systeminstruktioner i claude.ai minskade vissa problem, men motsvarande instruktioner följer inte automatiskt med API:t. Företaget uppmanar utvecklare att lägga till egna skydd, särskilt om tänkandet stängs av. Säkerhetstesterna är delvis gjorda utan produktens extra skydd, och vissa använder tidigare modellversioner. De ska därför inte läsas som ett direkt mått på alla användares upplevelse.
Var finns Haiku 5.5 och vad ändras för utvecklare?
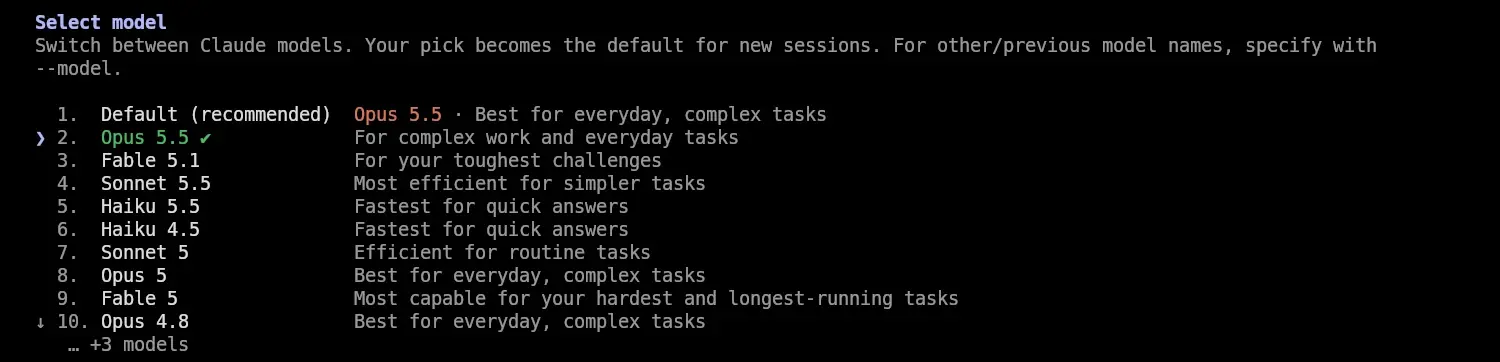
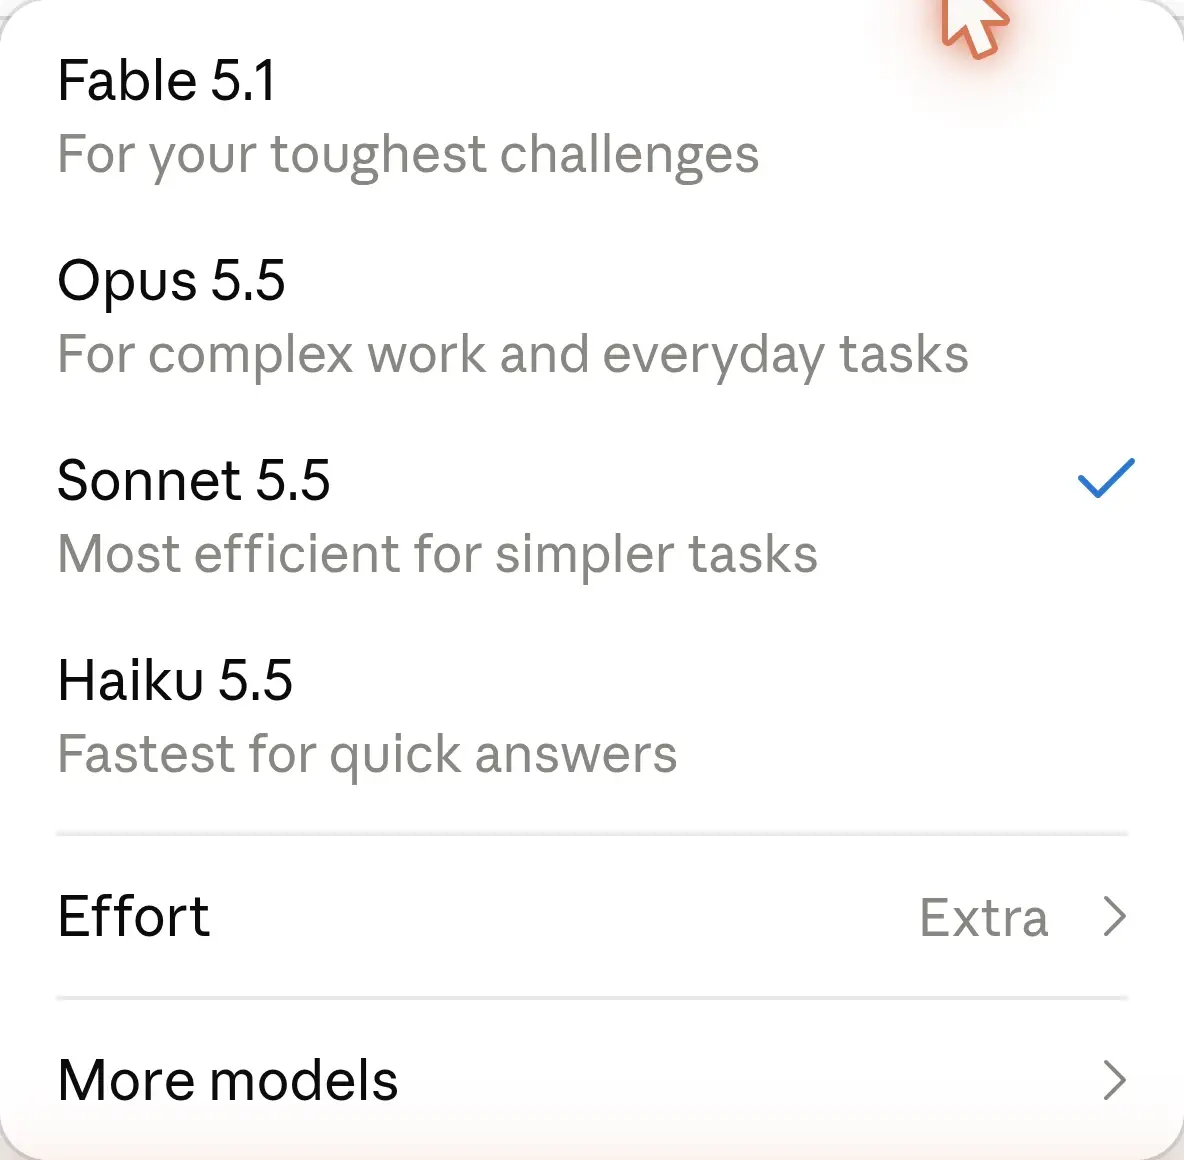
Haiku 5.5 finns enligt Anthropic på Claude Platform samt via Amazon Web Services, Google Cloud och Microsoft Azure. På Aipress Max 5x-konto kunde vi välja modellen både i Claude Code och på claude.ai i webbläsaren. På claude.ai hade Haiku 4.5 försvunnit från huvudlistan. Vi har inte kontrollerat Free, Pro eller Team, eller dator- och mobilapparna.
För den som vill bygga med modellen beskriver översikten på Claude Platform modellnamn, åtkomst och gränser. API-namnet är claude-haiku-5-5. Modellen tar emot text och bilder och svarar med text.
Kontextfönstret, alltså mängden material modellen kan ha tillgänglig samtidigt, är en miljon token mot Haiku 4.5:s 200 000. Dokumentationen anger att den nya gränsen motsvarar ungefär 555 000 ord. Ett vanligt API-svar kan innehålla upp till 128 000 token, dubbelt så mycket som tidigare. För batchanrop finns en funktion i beta för upp till 300 000 token i svaret.
Program som använder Haiku 4.5 kan behöva ändras. Den äldre inställningen budget_tokens, som satte en manuell budget för tänkandet, ger ett 400-fel med Haiku 5.5. Adaptivt tänkande är på som standard, och svaret kan börja med särskilda tänkandeblock. Ändrade värden för temperature, top_p och top_k stöds inte heller. I migrationsguiden för befintliga program beskriver Anthropic vilka ändringar bytet kräver.
Sonnet 5.5 blir billigare och abonnenter får API-kredit
Samtidigt halverar Anthropic priset för Sonnet 5.5:s cacheläsning från 0,20 till 0,10 dollar per miljon token. Företaget uppskattar att det sänker kostnaden med omkring 20 procent för de flesta uppgifter där modellen arbetar i flera steg med verktyg.
Som exempel redovisar Anthropic kostnaden för Sonnet 5.5 på Terminal-Bench 4.0, som prövar komplexa arbetsuppgifter i en kommandoradsmiljö. På Max sjunker kostnaden per försök från 14,15 till 10,44 dollar, medan resultatet ligger kvar på 70,6 procent lyckade försök.
Anthropic lyfter jämförelsen för att visa att Sonnet 5.5 och Opus 5.5 fortfarande är bättre val för komplexa koduppgifter där modellen arbetar självständigt i flera steg. Haiku är enligt företaget bättre lämpad för avgränsade uppgifter som sammanfattningar och arbete som underagent.
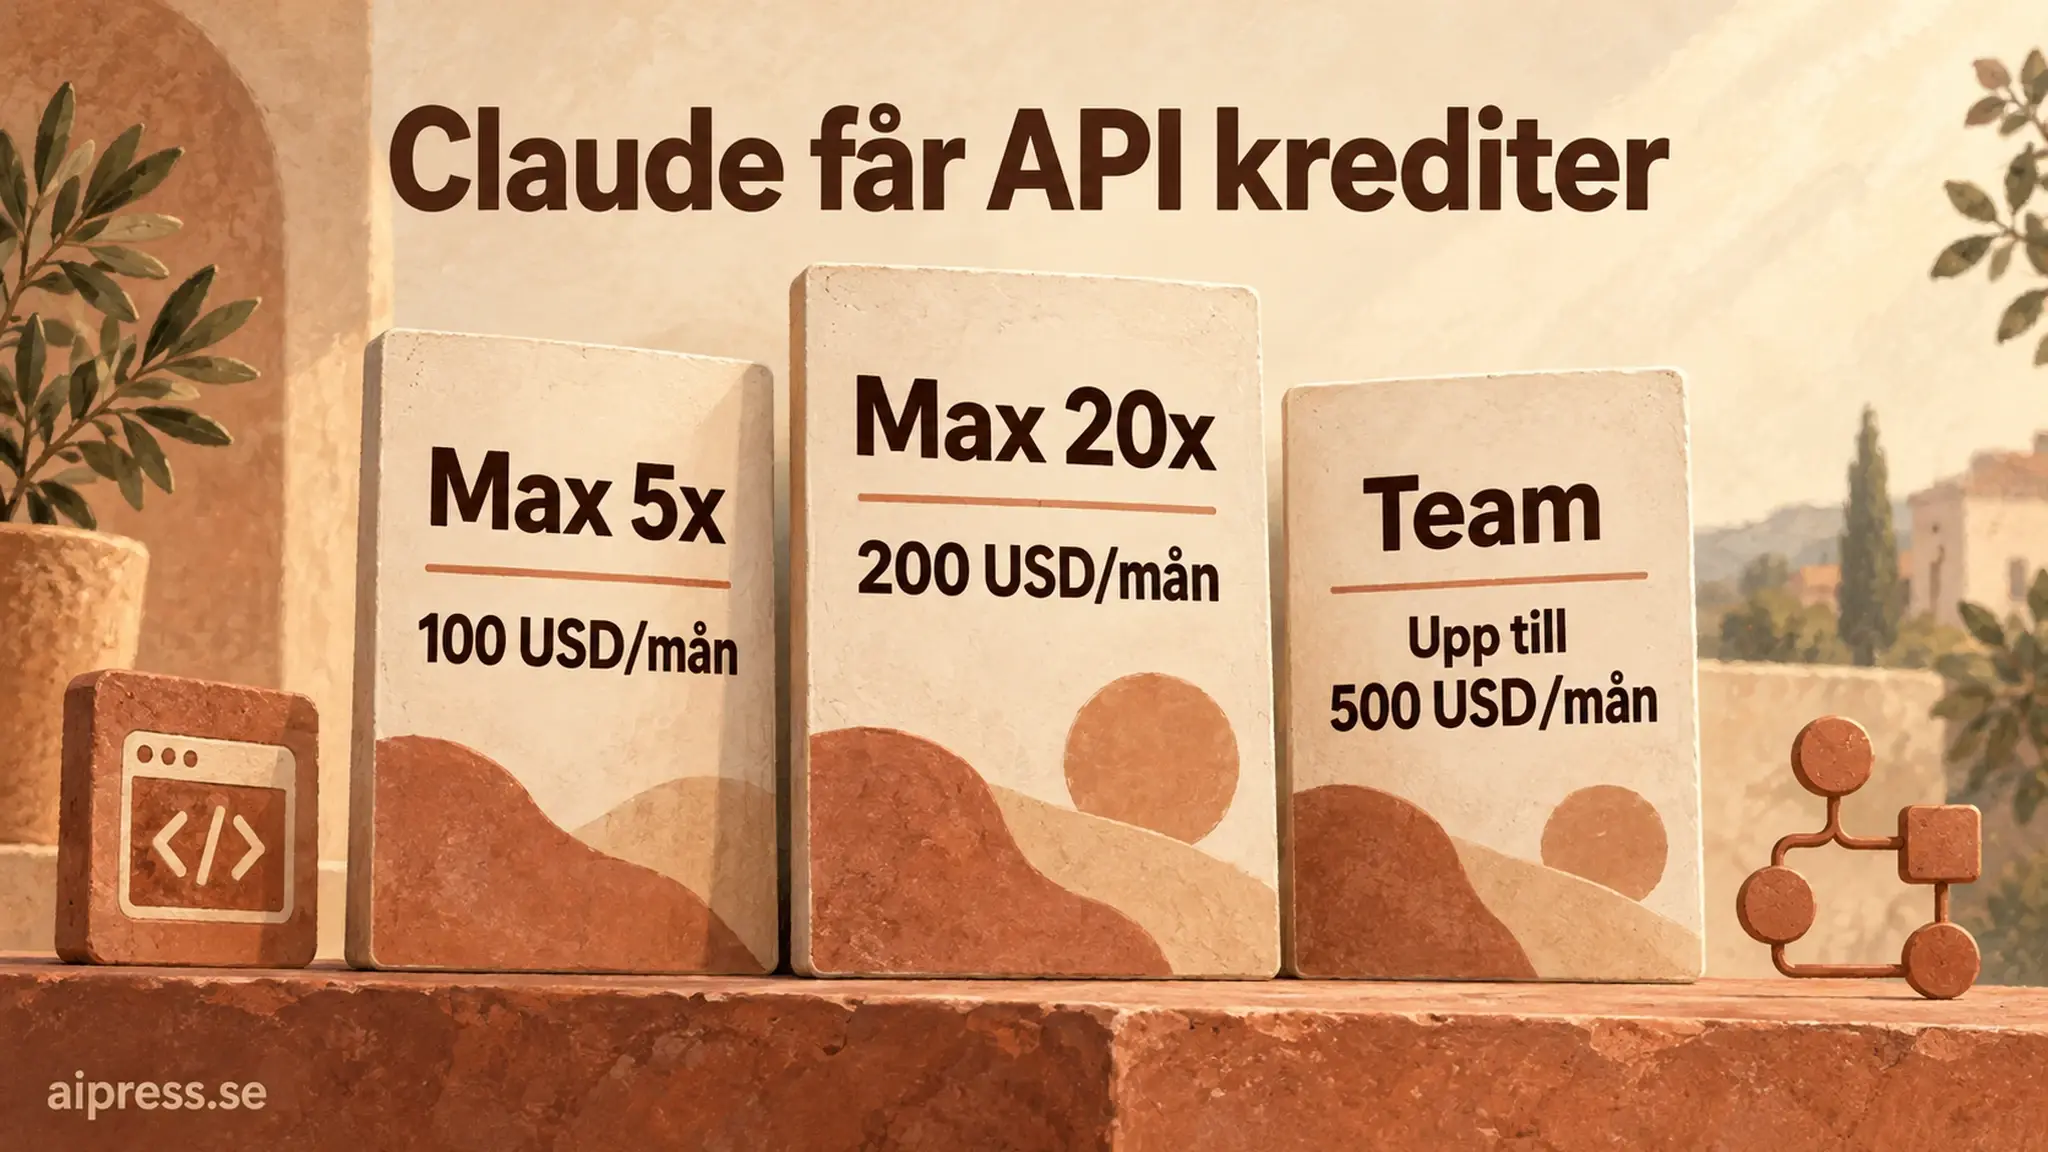
Under lanseringsveckan ska Max- och Team-abonnenter få en månatlig API-kredit att använda på Claude Platform. Max-abonnemangen får 100 dollar per månad på nivån 5x och 200 dollar på nivån 20x. Team får upp till 500 dollar per månad som delas mellan användarna. Krediten kan användas med alla modeller. I hjälpcentrets villkor för API-krediten finns mer information om hur den fungerar.
Anthropic uppdaterar också sina utvecklarpaket för Python och TypeScript med betastöd för att styra datorer och webbläsare. Företagets ambition med Haiku 5.5 är att fler sådana återkommande uppgifter ska bli rimliga att automatisera till en låg kostnad.
Frågor om Claude Haiku 5.5
Hur mycket billigare är Haiku 5.5 än Haiku 4.5?
Priset per token är 90 procent lägre för anrop med högst 100 000 inmatade token och 50 procent lägre för längre anrop. Anthropic uppskattar den genomsnittliga kostnadsminskningen per uppgift till omkring 75 procent, när även tokenförbrukningen räknas in.
Är Haiku 5.5 snabbare än Sonnet 5.5?
Anthropic beskriver Haiku 5.5 som sin snabbaste modell vid ordinarie hastighet. I Aipress sju vardagsuppgifter på Medium var Sonnet något snabbare sammanlagt. Haiku var snabbare på vissa uppgifter och långsammare på andra.
Vilken tankenivå har Haiku 5.5 som standard?
Medium är förvald i API:t. Modellen har adaptivt tänkande och stöder Low, Medium, High, Xhigh och Max. Högre nivå kan ge bättre resultat men också längre svarstid och högre kostnad.
Går Haiku 5.5 att välja i Claude?
På Aipress Max 5x-konto fanns Haiku 5.5 i modellväljaren på claude.ai och i Claude Code. Vi har inte verifierat tillgången för andra abonnemang eller i dator- och mobilapparna.
Källor
- Claude Haiku 5.5
Anthropic, hämtad
- Claude Haiku 5.5
Anthropic, hämtad
- Claude Haiku 4.5
Anthropic, hämtad
- Claude Sonnet 5.5
Anthropic, hämtad
- Claude Platform release notes by Anthropic
Anthropic, hämtad
- System Card: Claude Haiku 5.5
Anthropic, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.