I Aipress test använde Sonnet 5.5 34 procent färre utdatatoken än Sonnet 5. Den sammanlagda svarstiden minskade med 54 procent och den beräknade API-kostnaden med 46 procent. Fem av sju uppgifter blev helt rätt, samma antal som för Sonnet 5. Opus 5.5 klarade sex.
Anthropic uppger även att Sonnet 5.5 är den första Sonnet-modellen som har klarat Pokémon Red enbart utifrån skärmbilder. Företaget beskriver inte hur testet genomfördes, hur många försök modellen fick eller hur resultatet bedömdes.
Vad kostar Claude Sonnet 5.5?
Anthropic tar 2 dollar per miljon indatatoken och 10 dollar per miljon utdatatoken. Läsning ur cachen kostar 0,20 dollar per miljon token. Priserna är oförändrade jämfört med Sonnet 5.
| Post, dollar per miljon token | Sonnet 5.5 | Sonnet 5 |
|---|---|---|
| Indata | 2 | 2 |
| Utdata | 10 | 10 |
| Cache-skrivning, 5 minuter | 2,50 | 2,50 |
| Cache-skrivning, 1 timme | 4 | 4 |
| Cache-läsning | 0,20 | 0,20 |
| Batch, indata | 1 | 1 |
| Batch, utdata | 5 | 5 |
Opus 5.5 kostar dubbelt så mycket med samma räknesätt: 4 dollar för indata och 20 dollar för utdata.
När Anthropic säger att modellen kan kosta upp till 30 procent mindre per uppgift beror det därför på att den ska använda färre token, inte på ett lägre tokenpris. Företaget uppger också att Sonnet 5.5 genererar svar minst 30 procent snabbare än föregångaren. Lanseringsinlägget redovisar inte hur hastigheten eller kostnaden per uppgift mättes.
Sonnet 5.5 har ett kontextfönster på en miljon token och kan lämna svar på upp till 128 000 token. Batch API har betastöd för upp till 300 000 utdatatoken. Modellen tar emot text och bilder men lämnar bara text. Den pålitliga kunskapsgränsen är juni 2026.
Sonnet 5.5 mot Sonnet 5, Opus 5.5, Astra och Grok
Modellerna fick sju uppgifter: språkgranskning, felsökning av kod, omvandling av ett kvitto till JSON, informationshämtning med ett verktyg, bildtolkning, en Excel-budget och en PowerPoint-presentation.
Varje uppgift fick ett försök. Sonnet 5.5 och Sonnet 5 testades med Claude Code 2.1.284 och tankenivån medium. Sonnet 5 testades för den här jämförelsen. Opus 5.5, GPT-6 och Grok 4.7 är äldre resultat som inte upprepades. Opus 5.5 använde Claude Code 2.1.280. Testdagarna var Opus 5.5 den 22, GPT-6 Astra den 5, 12 och 22 samt Grok 4.7 den 21 och 22, alla under samma månad.
Varje cell visar resultat, tid och listpris-motsvarighet, alltså vad samma anrop hade kostat med en API-nyckel. För Astra och Grok visar vi bara tid och pris.
| Uppgift | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Astra | Grok 4.7 |
|---|---|---|---|---|---|
| Korrekturmejl | 7 av 7, 4,7 s, 0,0076 dollar | 6 av 7, 4,2 s, 0,0054 dollar | 7 av 7, 9,8 s, 0,0244 dollar | 11,4 s, 0,0263 dollar | 43,7 s, 0,0217 dollar |
| Python-bugg | 2 av 2 plus en extra ändring, 4,1 s, 0,0064 dollar | 2 av 2, 6,9 s, 0,0045 dollar | 2 av 2 plus en extra ändring, 8,8 s, 0,0177 dollar | 5,2 s, 0,0136 dollar | 9,0 s, 0,0040 dollar |
| Kvitto till JSON | Rätta värden men kodblock, 5,9 s, 0,0106 dollar | Rätta värden men kodblock, 5,0 s, 0,0064 dollar | Rätta värden men kodblock, 7,0 s, 0,0195 dollar | 8,1 s, 0,0224 dollar | 25,5 s, 0,0132 dollar |
| Väder via verktyg | Rätt, 4,8 s, 0,0086 dollar | Rätt, 6,2 s, 0,0111 dollar | Rätt, 7,1 s, 0,0184 dollar | 6,1 s, 0,0110 dollar | 4,8 s, 0,0071 dollar |
| Prislista på bild | Rättade 113 kr till 156 kr i samma svar, 4,5 s, 0,0134 dollar | 156 kr, 4,5 s, 0,0145 dollar | 156 kr, 7,3 s, 0,0274 dollar | 4,1 s, 0,0117 dollar | 5,4 s, 0,0043 dollar |
| Excel-budget | 9 av 9 krav, 30,6 s, 0,1827 dollar | 9 av 9 krav men inga sparade formelvärden, 114,1 s, 0,4377 dollar | 9 av 9 krav, 74,7 s, 0,5130 dollar | 41,3 s, 0,1578 dollar | 219,1 s, 0,1037 dollar |
| PowerPoint | 10 av 10 krav, 48,0 s, 0,1837 dollar | 10 av 10 krav, 80,9 s, 0,2898 dollar | 10 av 10 krav, 74,1 s, 0,4389 dollar | 99,3 s, 0,2843 dollar | 181,9 s, 0,0743 dollar |
| Summa sju uppgifter | 5 av 7 helt rätt, 102,6 s, 0,413 dollar | 5 av 7 helt rätt, 221,8 s, 0,769 dollar | 6 av 7 helt rätt, 188,8 s, 1,059 dollar | 175,5 s, 0,527 dollar | 489,4 s, 0,228 dollar |
Testerna ingick i ett abonnemang och debiterades därför inte separat. Sonnet 5.5 använde sammanlagt 13 018 utdatatoken, varav 1 645 tanketoken. Sonnet 5 använde 19 711 utdatatoken, varav 936 tanketoken. Opus 5.5 använde 18 283 utdatatoken, varav 3 485 tanketoken.
Störst tidsskillnad mot Sonnet 5 kom i Excel-uppgiften, 30,6 mot 114,1 sekunder, och presentationen, 48,0 mot 80,9 sekunder. På mejlet, buggen och kvittot låg modellerna närmare varandra.
Så svarade Sonnet 5.5 på de sju uppgifterna
Korrekturmejlet
Modellen fick ett kundmejl med sju planterade fel och den här instruktionen:
Rätta alla fel i texten nedan. Skriv först den rättade texten i sin helhet, och lista sedan varje ändring på en egen rad (fel -> rätt).

Hej! Jag skriver till er för att jag har ett problem med min beställning. Jag beställde en jacka den 12:e augusti men den har fortfarande inte kommit. Jag har ringt till kund tjänsten två gånger och dem sa att paketet skulle komma inom en vecka. Nu har det gått tre veckor och jag börjar bli oroligt. Kan ni kolla vart paketet är? Om det har försvunnit vill jag ha pengarna tillbaks. Jag betalade 1 299 kronor med kort. Min order nummer är 48213. Jag hoppas att ni kan hjälpa mig snabbt, för jag behöver jackan innan hösten. Tack på förhand, och ha en trevlig dag! Med vänliga hälsningar, Anna Lindkvist
Sonnet 5.5 hittade alla sju felen på medium och skrev bland annat “den 12 augusti” och “kundtjänst”. Modellen lade även till ett komma före “men” och flyttade hälsningen till egna rader.
Sonnet 5 lät “den 12:e augusti” stå kvar. Opus 5.5 rättade alla sju fel.
Buggen i Python-funktionen
Uppdraget var att rätta alla fel i en funktion som räknar ut totalpriset för en varukorg med rabattkod och frakt, och att lista dem. Koden såg ut så här:
def totalpris(varor, rabattkod=None):
    summa = 0
    for namn, pris, antal in varor:
        summa += pris
    if rabattkod == "HÖST10":
        summa = summa * 0.10
    if summa < 500:
        summa += 49
    return round(summa)
Sonnet 5.5 hittade båda avsedda felen. Modellen ändrade också round(summa) till round(summa, 2) och presenterade det som ett tredje fel. Därmed gav funktionen 747, 672,3 och 198 i facitets tre fall. Facit var 747, 672 och 198.
Opus 5.5 och GPT-6 Astra gjorde samma extra avrundningsändring. Sonnet 5 behöll round(summa) och gav rätt värden i alla tre fallen.
Kvittot till JSON
Modellen skulle göra om ett ICA-kvitto till JSON och kontrollera summan. Instruktionen var att svara bara med JSON, ingen annan text.
Alla värden blev rätt. Svaret innehöll rätt butik, datum, sex rader, en separat pantrad, mjölk 39,90 gånger två, totalsumman 210,13 kronor och moms på 22,51 kronor.
Svaret låg däremot i ett markdown-kodblock. Därför kan hela svaret inte läsas in som JSON rakt av. Sonnet 5 och Opus 5.5 gjorde likadant. Sonnet 5 behöll kilovikten i namnet på bananraden, medan Sonnet 5.5 skrev enbart “Bananer”.
Vädret via ett verktyg
Modellen skulle kolla vädret för två orter med hjälp av ett testverktyg. Verktygets anropslogg visar att båda orterna hämtades för lördag.
Sonnet 5.5 återgav regn och 12 grader på den ena orten samt mulet och 13 grader på den andra. Slutsatsen var att ta med regnjacka. Modellen påpekade också att prognosen inte sa något om morgonen. Sonnet 5 svarade rätt på samma sätt och menade att regnet kunde hänga med på vägen.
Prislistan på bilden
Modellen fick en bild av ett cafés prislista och den här frågan:
Bilden visar en prislista från ett café. Vad kostar det att köpa två kanelbullar, en kaffe och en havredryck-latte? Räkna ut totalen och visa uträkningen.Sonnet 5.5 öppnade svaret med att beställningen kostade 113 kronor. Längre ned räknade modellen rätt, 70 + 32 + 54 = 156, och skrev att 113 kronor var ett räknefel. Slutsumman blev alltså rätt, men den felaktiga första siffran stod kvar i samma svar.
Sonnet 5 skrev 156 kronor direkt.
Excel-budgeten
Uppdraget var en enkel månadsbudget för en liten frisörsalong i en Excel-fil: intäkter per tjänst, kostnader och en summering med resultat före skatt, riktiga formler i alla summor och all text på svenska. En PNG-bild av hela kalkylbladet med uträknade värden ingick också.
Sonnet 5.5 skapade bladet Månadsbudget med tio formler och sparade värden för samtliga. Intäkterna var 159 000 kronor, kostnaderna 111 700 kronor, resultatet före skatt 47 300 kronor och marginalen 29,7 procent. Alla värden stämde vid en separat uträkning.
Bilden av kalkylbladet visar tusental med engelskt kommatecken på grund av renderingens språkinställning. Modellen upplyste om det i svaret.
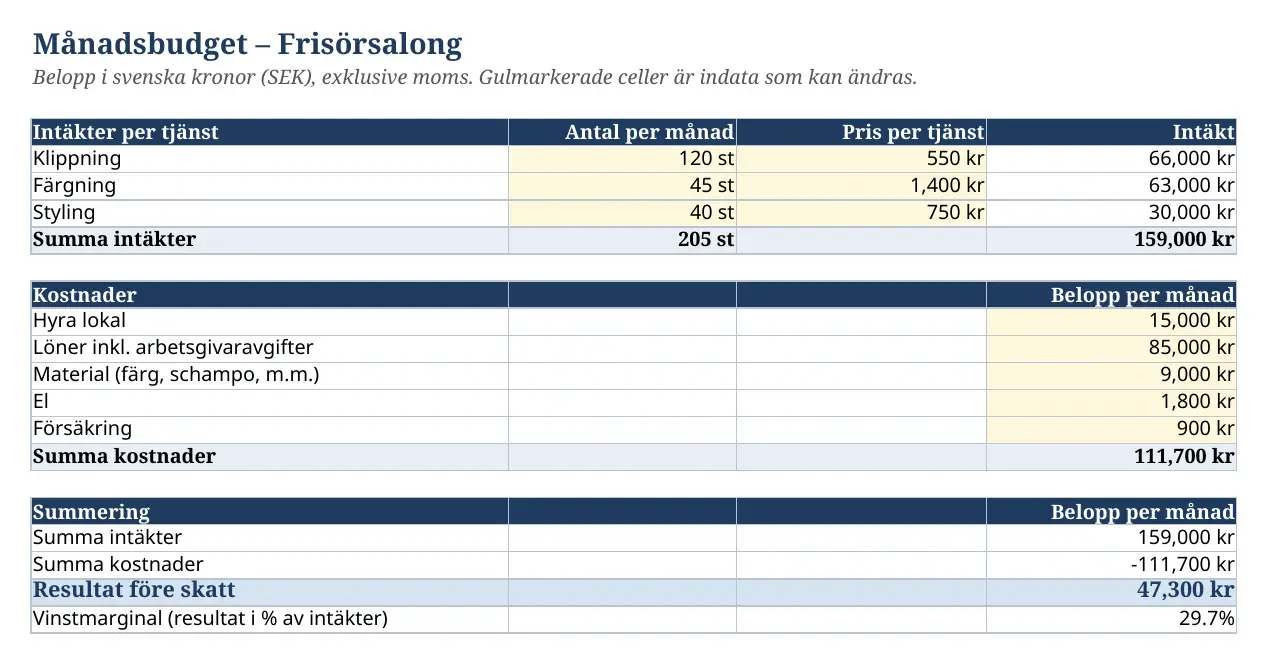
Sonnet 5 döpte bladet till Manadsbudget, använde nio formler och sparade inga uträknade formelvärden i filen. Formlerna räknas först när filen öppnas. Bilden visade ändå uträknade värden.
Frisörbudgeten med de tio formlerna ligger orörd som xlsx-fil, precis som modellen lämnade den.
PowerPoint-presentationen
Uppdraget gällde fem bilder för ett litet bageri som presenterar sig för en ny företagskund: titelbild, om bageriet, erbjudanden för företag, exempelpriser och kontakt. Påhittade uppgifter var tillåtna, layouten skulle vara ren med en tydlig rubrik per bild, och varje bild exporterades som PNG.
Sonnet 5.5 skapade en brun och krämfärgad presentation för “Stenugnsbageriet Solsidan”. Den hade fem bilder i bredbildsformat, tydliga rubriker, sidnummer och inga texter utanför bildytan. Kontaktadressen slutade på .example, och modellen skrev att namn, adress och priser var påhittade.
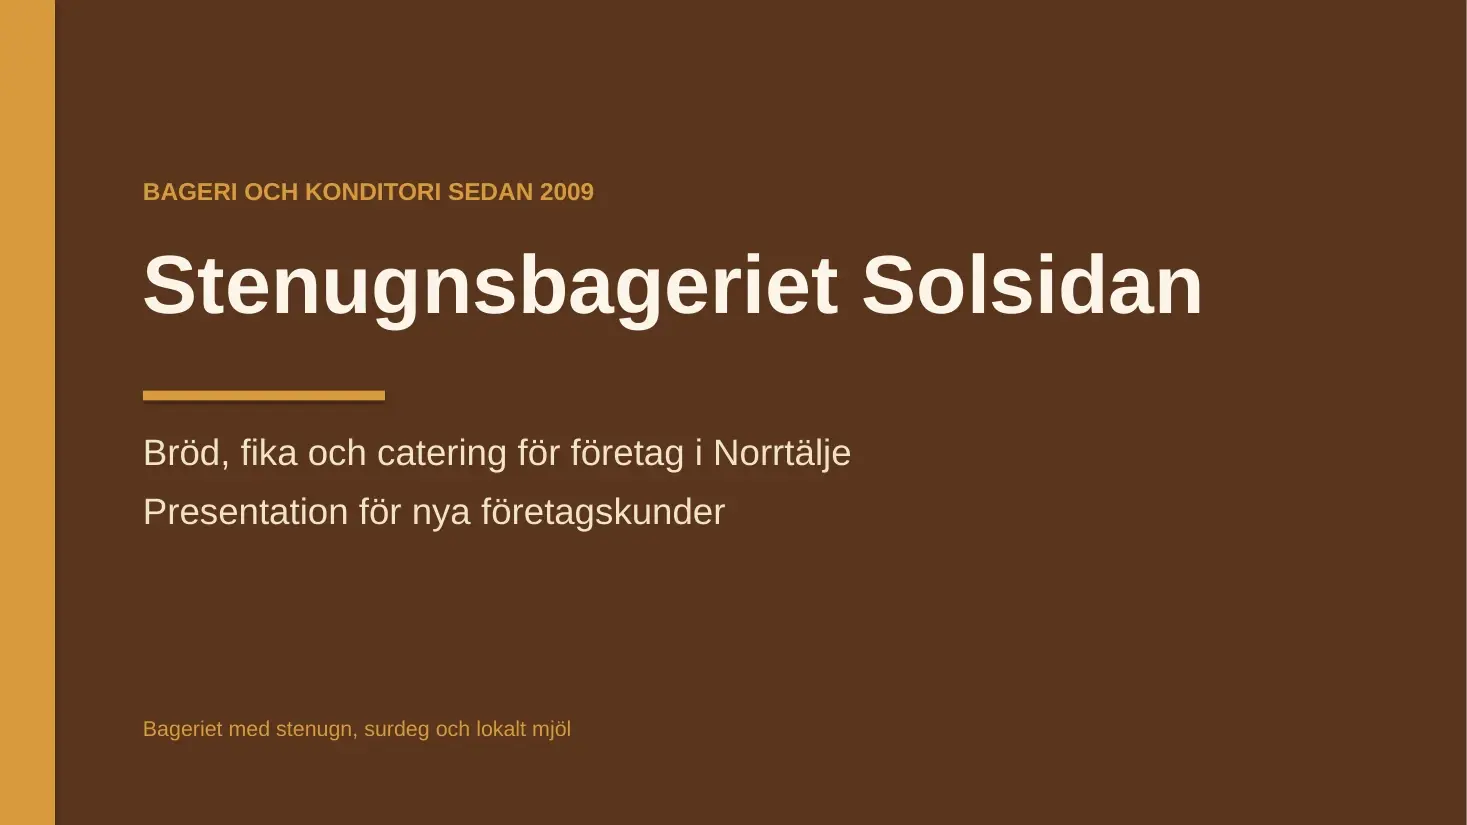
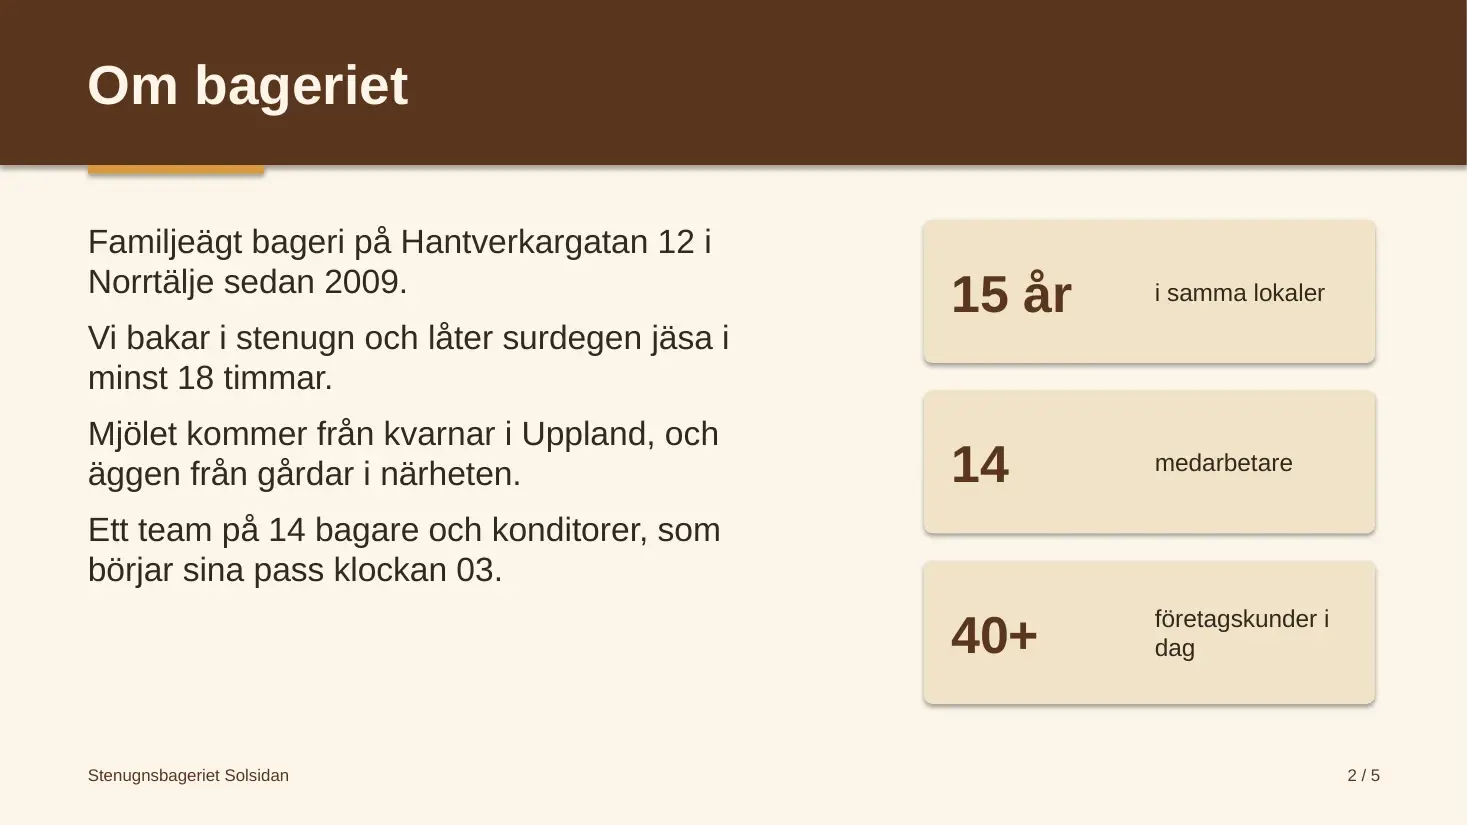
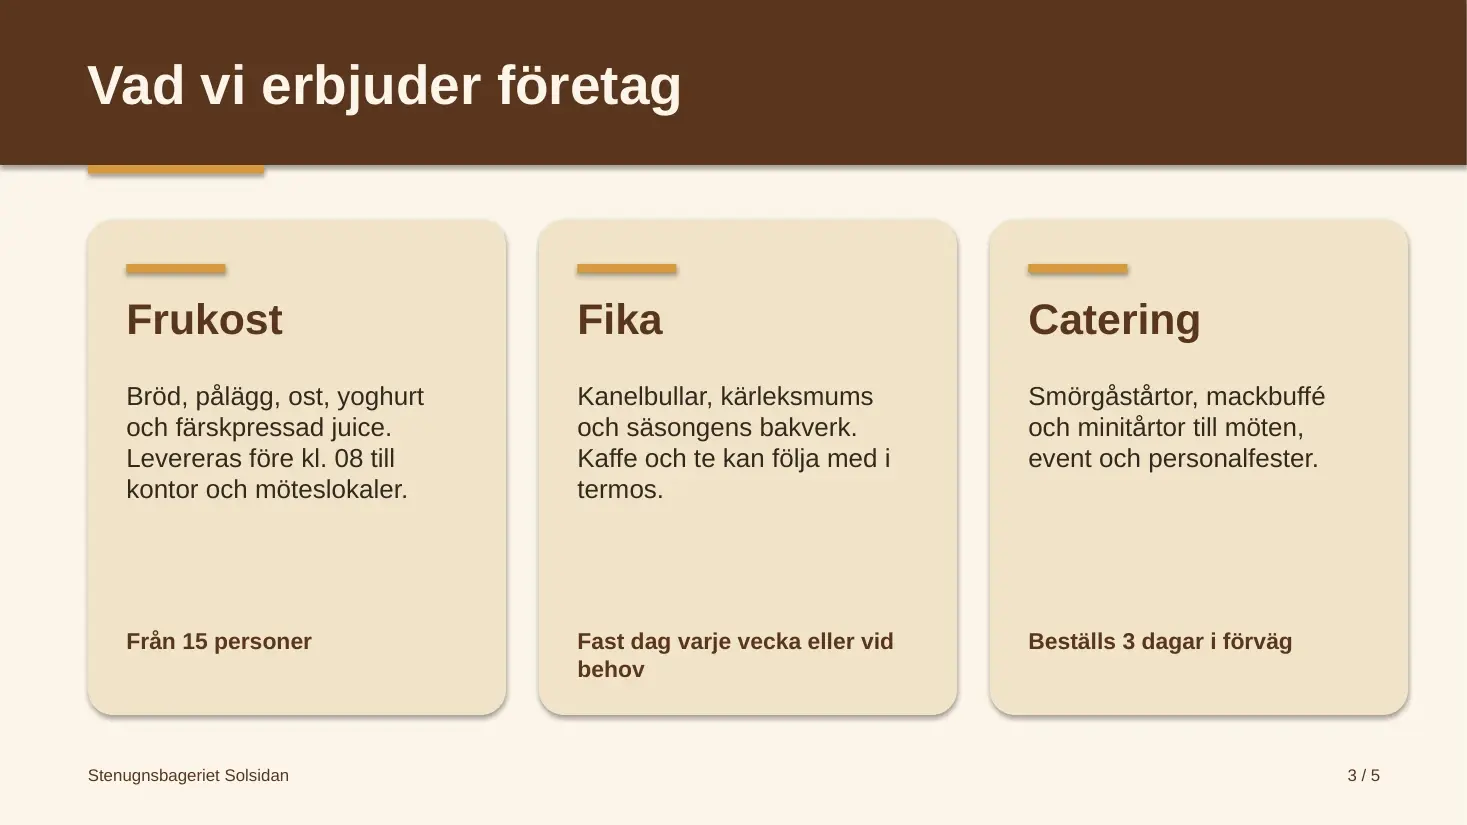
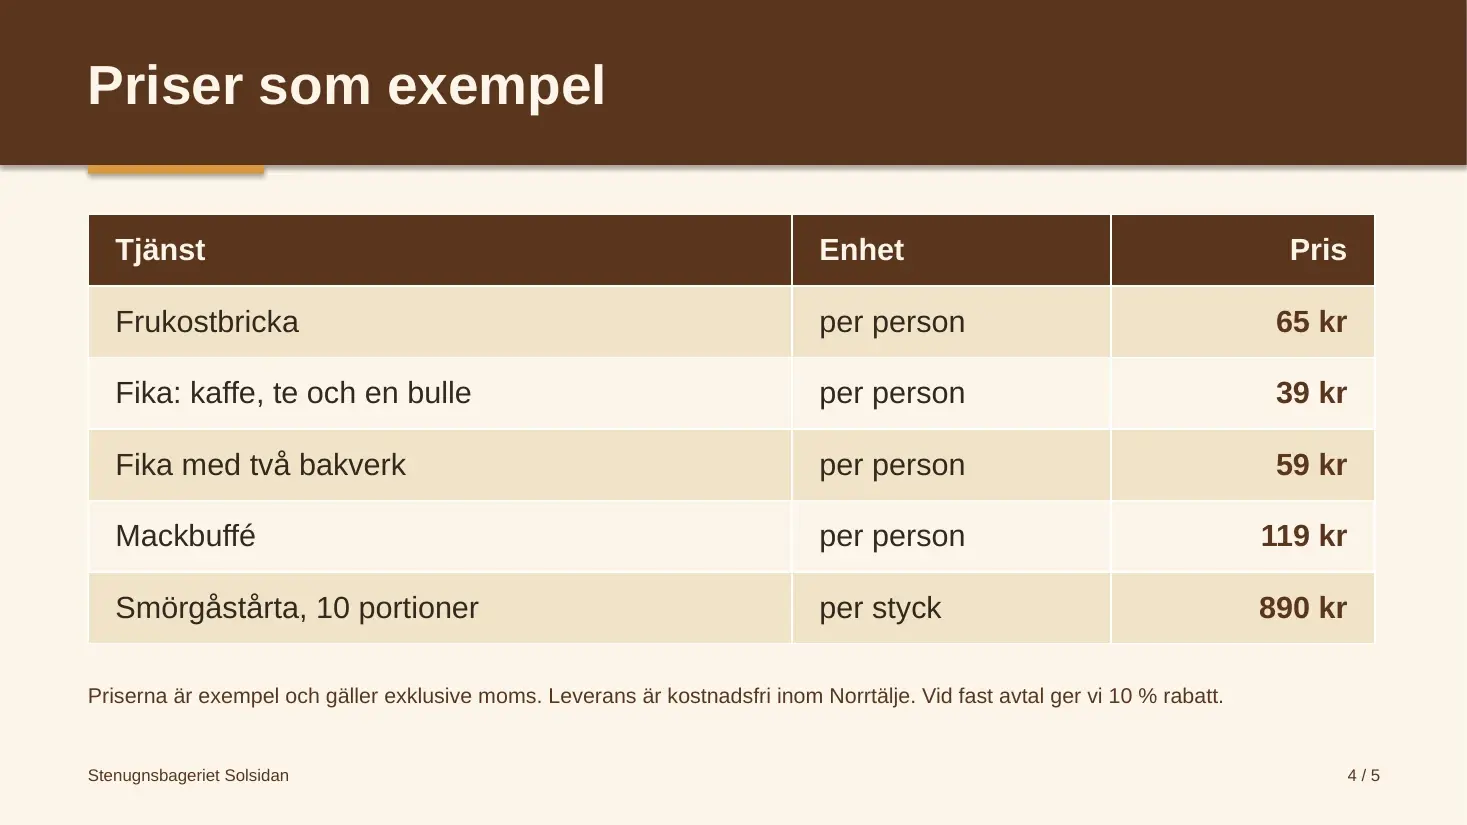
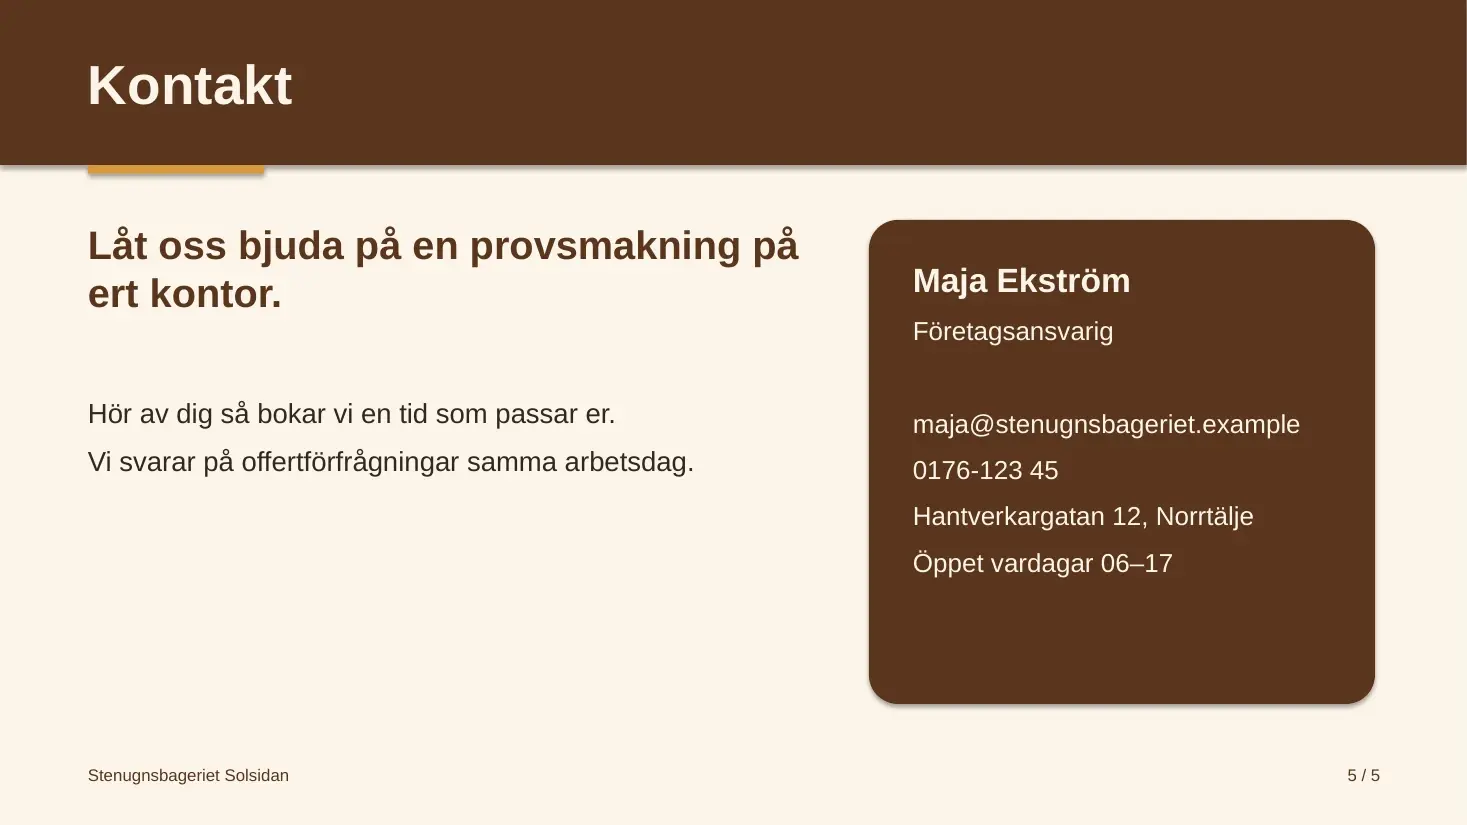
Sonnet 5 använde kontaktuppgifter som ser verkliga ut utan att ange att de var påhittade. Presentationen hade också dekorativa cirklar som gick utanför bildkanten på första och sista bilden. Ingen text skars av.
Bageriets fem bilder är sparade som pptx-fil, så att du kan bläddra bland dem själv.
Högre tankenivå gav inte bättre språkgranskning
Sonnet 5.5 har fem tankenivåer: low, medium, high, xhigh och max. Claude Code och Claude-apparna använder medium som förval. API-plattformen använder high.
Samma korrekturuppgift gavs en gång till varje nivå. Low och medium hittade alla sju fel. High, xhigh och max missade samma formulering, “den 12:e augusti”. De övriga sex felen rättades på samtliga nivåer. De två lägsta stegen tog lika lång tid. Därefter steg både tiden och antalet tanketoken för varje nivå.
Varje cell visar antal funna fel, tid, utdatatoken med tanketoken inom parentes och listpris-motsvarighet.
| Nivå | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol | Grok 4.7 |
|---|---|---|---|---|---|---|
| Low | 7 av 7, 4,7 s, 479 (0), 0,0078 dollar | - | 7 av 7, 8,1 s, 737 (163), 0,0207 dollar | 7 av 7, 7,8 s, 424 (135), 0,0233 dollar | 7 av 7, 10,0 s, 543 (288), 0,012 dollar | 6 av 7, 18,7 s, 1 370 (1 160), 0,0094 dollar |
| Medium | 7 av 7, 4,7 s, 464 (0), 0,0076 dollar | 6 av 7, 4,2 s, 382 (0), 0,0054 dollar | 7 av 7, 9,8 s, 920 (399), 0,0244 dollar | 7 av 7, 8,3 s, 529 (183), 0,0285 dollar | 7 av 7, 10,9 s, 772 (516), 0,016 dollar | 7 av 7, 43,7 s, 3 425 (3 192), 0,0217 dollar |
| High | 6 av 7, 5,8 s, 758 (382), 0,0106 dollar | - | 7 av 7, 11,6 s, 1 107 (583), 0,0281 dollar | 7 av 7, 36,1 s, 1 293 (1 009), 0,0667 dollar | 7 av 7, 13,0 s, 791 (516), 0,0166 dollar | 6 av 7, 45,8 s, 3 533 (3 319), 0,0224 dollar |
| Xhigh | 6 av 7, 10,7 s, 1 527 (1 082), 0,0183 dollar | - | 7 av 7, 15,7 s, 1 583 (970), 0,0376 dollar | 7 av 7, 52,0 s, 2 191 (1 894), 0,1116 dollar | 7 av 7, 24,5 s, 1 810 (1 552), 0,0370 dollar | 6 av 7, 42,9 s, 3 254 (3 044), 0,0207 dollar |
| Max | 6 av 7, 43,2 s, 6 733 (6 301), 0,0703 dollar | - | 7 av 7, 155,3 s, 17 331 (16 665), 0,3526 dollar | - | - | - |
GPT-modellernas resultat för de två lägsta stegen är från 5 september och för de två högsta från 22 september. Sonnet 5 lät samma datum stå kvar på medium. Grok 4.7 missade datumet på low, high och xhigh. Opus 5.5 rättade det på samtliga fem nivåer.
Max tog drygt nio gånger så lång tid som medium och kostade drygt nio gånger så mycket. Resultatet säger bara vad som hände i ett försök per modell och nivå. Det räcker inte för att fastställa att en högre tankenivå generellt ger sämre språkgranskning.
Poängen sjönk också mellan de två högsta nivåerna i ett av kodtesterna i tabellen nedan, FrontierCode. Skälet förklaras där.
Klarar asteroidspelet både 60 och 144 Hz?
Modellen fick skapa ett komplett asteroidspel i en enda HTML-fil.
Skapa ett litet webbläsarspel i en enda HTML-fil: ett rymdskepp som skjuter asteroider, i cyberpunkstil (neonfärger, mörk bakgrund). Styrning med piltangenterna, skjut med mellanslag. Visa poäng och liv. Spelet ska fungera direkt när filen öppnas i en webbläsare, utan externa bibliotek eller bilder. Svara med endast HTML-filen i ett kodblock.Hz visar hur många bilder som ritas varje sekund: 60 på en vanlig bildskärm och 144 på en för dataspel. Ett spel som flyttar saker ett fast steg per bildruta går därför mer än dubbelt så fort på den senare (144 delat med 60 är 2,4), medan ett som räknar med tid går lika fort på båda. Alla krav kan vara uppfyllda och ändå går det inte att spela. Därför provades varje fil på tre sätt i webbläsaren med en klocka som vi styr själva: samma fil på 60 och 144 Hz, skeppet stillastående och skjutande i 20 s (det ska inte förlora alla liv av sig självt) och en minut i mänskligt tempo (det ska överleva minst en halv minut).
Alla tre Sonnet-versioner uppfyllde de nio grundkraven och startade utan konsolfel. Medium och high flyttade däremot spelobjekten ett fast steg per bildruta. Vid 144 Hz gick asteroider, svängning och skott därför 2,40 gånger så snabbt som vid 60 Hz.
Medium
Medium tog 29,3 sekunder, använde 5 560 utdatatoken utan tanketoken.
Vid 144 Hz rörde sig asteroiderna 2,40 gånger så fort som vid 60 Hz. Svängningen steg från 257,8 till 618,8 grader per sekund och skotten från 472,9 till 1 135,1 pixlar per sekund.
I ett 60 sekunder långt prov med mänsklig styrning överlevde spelet hela minuten vid 60 Hz med ett liv kvar. Vid 144 Hz var spelet över efter 27,83 sekunder, en bit under gränsen på 30. När skeppet stod still och bara sköt i 20 sekunder förlorade det inget liv.
High
High tog 29,0 sekunder, använde 6 034 utdatatoken utan tanketoken.
Asteroidfarten steg från 59,9 till 143,9 pixlar per sekund mellan 60 och 144 Hz. Svängningen steg från 275,0 till 660,0 grader per sekund och skotten från 472,9 till 1 135,1 pixlar per sekund. Även tiden som skeppet var osårbart efter en träff räknades i bildrutor.
Vid 60 Hz var spelet över efter 44,37 sekunder. Vid 144 Hz tog det slut redan efter 21,52. I stillastående-provet hade spelet alla tre liv kvar efter 20 sekunder.
Xhigh
Xhigh tog 181,5 sekunder, använde 32 039 utdatatoken, varav 19 347 tanketoken.
Den här versionen räknade rörelser utifrån förfluten tid. Asteroidfarten var densamma vid båda bildfrekvenserna. Svängningen låg på 252,1 grader per sekund och toppfarten på 380,0 pixlar per sekund vid både 60 och 144 Hz.
Vid 60 Hz var spelet över efter 54,98 sekunder. Vid 144 Hz levde spelaren fortfarande efter 60 sekunder med ett förlorat liv och 1 380 poäng. Xhigh var den enda av Sonnet-versionerna som klarade både 60 och 144 Hz.
I stillastående-provet förlorade xhigh-spelet alla tre liv genom registrerade krockar efter 4,87, 10,48 och 19,50 sekunder. Liv försvann bara genom krockar, aldrig av något annat skäl, så provet räknas som godkänt, men spelet var hårdare än Astras, som förlorade två liv i samma prov. Själva slutet mättes inte, men koden i filen väntar 1,6 s efter sista livet innan det är över.
| Modell och nivå | Krav uppfyllda | Krasch på första bildrutan | Samma fart på 60 och 144 Hz | Spelbart för en människa | Tid | Kostnad |
|---|---|---|---|---|---|---|
| Sonnet 5.5 medium | 9 av 9 | Nej | Nej, 2,40 gånger | Nej | 29,3 s | 0,0579 dollar |
| Sonnet 5.5 high | 9 av 9 | Nej | Nej, 2,40 gånger | Nej | 29,0 s | 0,0627 dollar |
| Sonnet 5.5 xhigh | 9 av 9 | Nej | Ja | Ja, men tappar alla liv om skeppet står still | 181,5 s | 0,3227 dollar |
| Opus 5.5 medium | 9 av 9 | Nej | Ja, utom toppfarten | Ja, med en brist | 54,4 s | 0,1539 dollar |
| GPT-6 Astra medium | 9 av 9 | Nej | Ja | Ja | 58,9 s | 0,2166 dollar |
| Grok 4.7 medium | 2 av 9 | Ja | Kraschade | Nej | 44,5 s | 0,0267 dollar |
| Grok 4.7 high | 2 av 9 | Ja | Kraschade | Nej | 51,5 s | 0,0326 dollar |
| Grok 4.7 xhigh | 9 av 9 | Nej | Nej, 2,40 gånger | Nej, för snabbt | 33,5 s | 0,0209 dollar |
Två av tre Grok-spel kraschade på första bildrutan. Sonnet 5.5 kraschade inte på någon nivå, men bara xhigh-versionen hanterade båda bildfrekvenserna. Groks xhigh-fil, den enda som gick att starta, gick senare för fort på en bildskärm med 144 Hz, och det var slut efter 6,77 s vid 60 Hz.
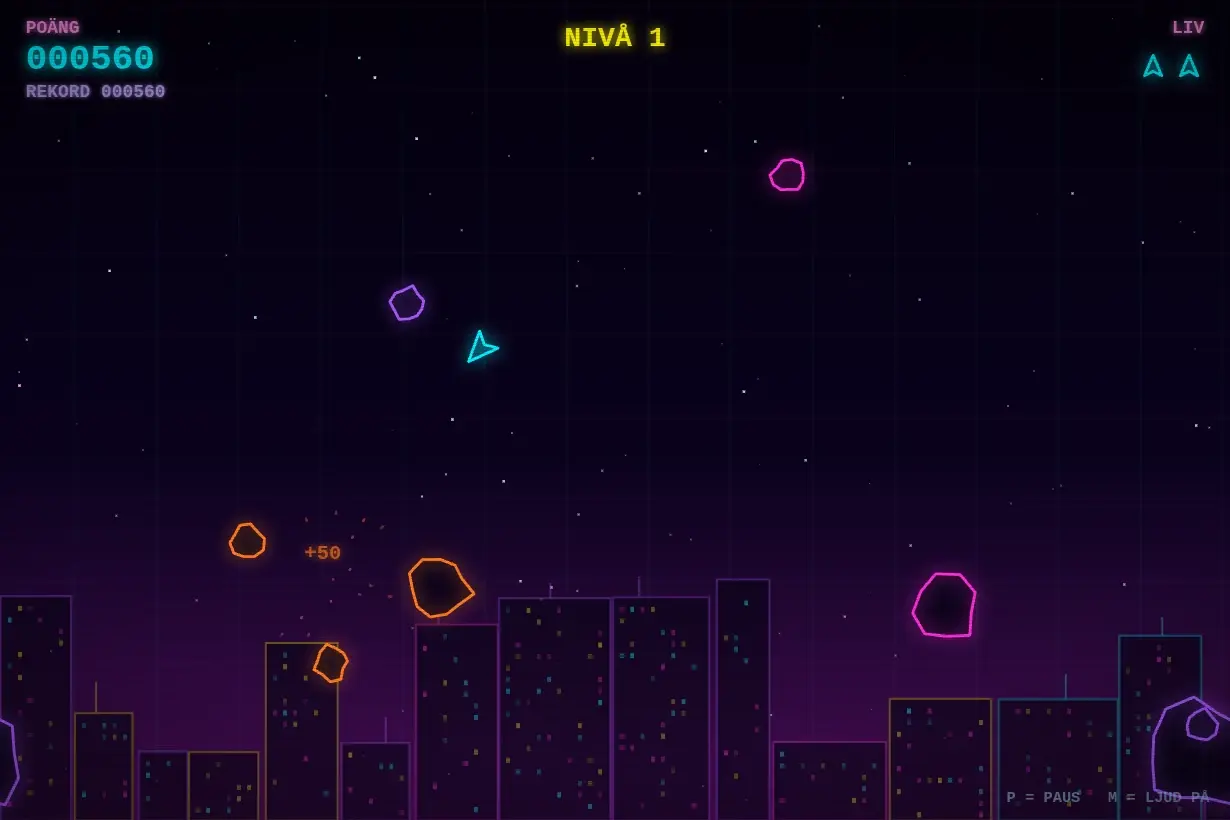
Rymdskeppet i neon som styrs med piltangenter och mellanslag heter Sonnet-Asteroid. Det är modellens egen xhigh-fil, oredigerad, med bara en svensk titel och beskrivning tillagd i sidhuvudet.
Anthropics egna riktmärken placerar Sonnet 5.5 nära Opus 5.5
Tabellen nedan kommer från Anthropics lanseringsinlägg. Företaget har testat sina egna modeller med skydden påslagna och jämför dem med värden från respektive resultattavla. Det är inte en oberoende mätning.
| Riktmärke | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % | - |
| FrontierCode 1.1 Main | 46,2 % på max | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | - |
| GDPval-AA v2.1, Elo | 1 844 | 1 449 | 1 846 | 1 487 |
| AA-Briefcase v1.1, Elo | 1 811 | 1 359 | 1 822 | 1 483 |
| Humanity’s Last Exam med verktyg | 64,5 % | 54,9 % | 67,7 % | - |
| OSWorld 2.1, delmängd | 80,1 % | 57,0 % | 81,8 % | - |
| Chartography utan verktyg | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
I jämförelsen leder Opus 5.5 på sju av åtta rader. Terminal-Bench är det enda undantaget.
Terminal-Bench är ett agentbaserat kodningstest. FrontierCode bedömer om en kodändring kan slås samman utan mänskliga rättelser och drar av för ändringar utanför uppgiften. CursorBench använder uppgifter från verkliga kodningssessioner i Cursor.
GDPval-AA prövar verkliga arbetsuppgifter från 44 yrken i nio större branscher. AA-Briefcase mäter långvarigt kunskapsarbete. OSWorld gäller datoranvändning och Chartography gäller diagramtolkning. Underlaget beskriver inte Humanity’s Last Exam närmare än att den redovisade versionen använder verktyg.
FrontierCode-raden kräver extra sammanhang. Sonnet 5.5 fick 52,1 procent på xhigh, vilket är högre än GPT-6 Sols 49,3 procent. På max fick Sonnet 5.5 i stället 46,2 procent, vilket är lägre än Sol. Förklaringen står i fotnot 2 i inlägget: på max använde modellen oftare Claude Codes kodgranskningsfunktion, som delar granskningen mellan många underagenter, och i två fall som Cognition undersökte ledde det till en tidsgräns eller extra ändringar utanför uppgiften. Systemkortets avsnitt om testet bekräftar poängen. Lanseringsinlägget anger dessutom att high matchar Sols bästa resultat, men visar inget numeriskt high-värde.
Chartography-raden gäller test utan verktyg. Systemkortet anger även resultat med verktyg. Där fick Sonnet 5.5 90,2 procent och Opus 5.5 89,0 procent.
Kortet har två poster till där Sonnet 5.5 slår Opus 5.5 och som inlägget saknar. På HealthBench Professional fick Sonnet 5.5 69,2 och Opus 5.5 65,6 efter en justering för svarslängd. Före justeringen hade båda 77,1, så samma poäng rankas olika beroende på justeringen. På AutomationBench fick Sonnet 5.5 44,7 mot Opus 5.5:s 42,5.
Artificial Analysis testade GDPval-AA och AA-Briefcase på en tidig driftsättning som hade ett fel som kunde försämra strukturerade svar. Anthropic bedömer att eventuell påverkan var liten och i så fall sänkte Sonnet 5.5:s resultat. Felet har rättats.
OpenAI har också rättat ett fel som försämrade bildförståelsen i GPT-6 Sol. Värdena för AA-Briefcase, GDPval-AA och Chartography kan vara äldre än rättelsen. Artificial Analysis väntar sig ingen större förändring i de två första testerna. Anthropics interna test tyder på att Chartography-resultatet inte påverkades.
GPT-6 Sol saknar publika värden för Terminal-Bench och CursorBench. Diagrammen i inlägget för dessa två tester jämför därför med GPT-5.6 Sol, medan tabellen visar streck i GPT-6 Sol-kolumnen.
Terminal-Bench har överlappande felmarginaler
Sonnet 5.5 står 4,2 procentenheter över Opus 5.5 i Terminal-Bench. Standardfelet är plus minus 2,5 procentenheter för Sonnet 5.5 och plus minus 2,6 för Opus 5.5. Skillnaden bör därför inte läsas som ett säkert bevis för att Sonnet är bättre.
Jämförelsen använder dessutom olika tankenivåer. Sonnet 5.5:s 70,6 procent är från max. Opus 5.5:s 66,4 procent är från xhigh. Opus fick 64,8 procent på max.
I mätningen bakom den siffran skickade skyddssystemet 1,2 procent av Sonnet 5.5:s begäranden till en reservmodell. Det berörde 1,5 procent av försöken, och ett försök avslutades utan svar.
Hoppet från Sonnet 5:s 10,3 procent till Sonnet 5.5:s 70,6 procent finns i lanseringsinlägget. Sonnet 5-värdet finns däremot inte i systemkortets redovisning av Terminal-Bench.
Systemkortet redovisar begränsningar och säkerhetsskydd
Systemkortet är medvetet kortare än tidigare kort. Anthropic skriver att kommande kort för modeller som inte ligger vid kapacitetsgränsen också ska kortas, om en modell inte har särskilda egenskaper som kräver en längre genomgång. Kortet har inget eget avsnitt om begränsningar.
Anthropic skriver att Sonnet 5.5:s tänkande är mer svårläst än hos många tidigare modeller. Företaget redovisar också försämringar i vissa flerstegstester, bland annat spårning och övervakning. Vägran vid skadliga uppgifter i miljöer för datoranvändning ligger nära Opus 5.5 men är sämre än hos vissa äldre modeller.
Anthropic behandlar Sonnet 5.5 som att den uppfyller nivåerna CB-1 och Autonomy-1. Företaget bedömer att modellen inte passerar CB-2 eller Autonomy-2.
Lanseringsinlägget beskriver cybersäkerhetsförmågan som ett stort lyft från Sonnet 5. Systemkortets mer precisa formulering är att Sonnet 5.5 kan ta fram avancerade sårbarhetsangrepp betydligt bättre än Sonnet 5, men inte lika bra som Opus 5.5 eller Mythos 5.1. För Sonnet 5.5 nämns ingen oberoende säkerhetsutvärderare. Underlaget består av Anthropics egen bedömning.
I Claude-apparna granskas varje begäran av säkerhetsfilter. Kontrollen omfattar även minne, anslutna tjänster, sökresultat och filer som modellen läser. Vissa avancerade frågor om cybersäkerhet skickas till Sonnet 5. Begäranden som kan bidra till allvarlig biologisk skada blockeras.
På API-plattformen är automatiskt modellbyte inte påslaget från början. Utvecklaren måste konfigurera en reservmodell. Utan en sådan inställning kan API:et svara med statuskod 200 men avsluta med en särskild stop-orsak i stället för ett vanligt modellsvar.
Sonnet 5.5 är den första Sonnet-modellen som lanseras med säkerhetsklassificerare som ska hindra att modellens tänkande plockas ut. Bevarat tänkande har också utökats, vilket innebär att tankeinnehåll inte kan flyttas mellan konton.
Cyberförsvarare ska enligt Anthropic snart kunna ansöka till Cyber Verification Program. Sonnet 5.5 ingår inte i programmet vid lanseringen, och företaget anger inget datum för när det ändras.
Finns Sonnet 5.5 i Claude Code och på claude.ai?
Sonnet 5.5 finns via Claude API, Amazon Bedrock, Google Cloud och Microsoft Foundry. Modell-id:t är claude-sonnet-5-5. Claude Code kräver version 2.1.284 eller senare.
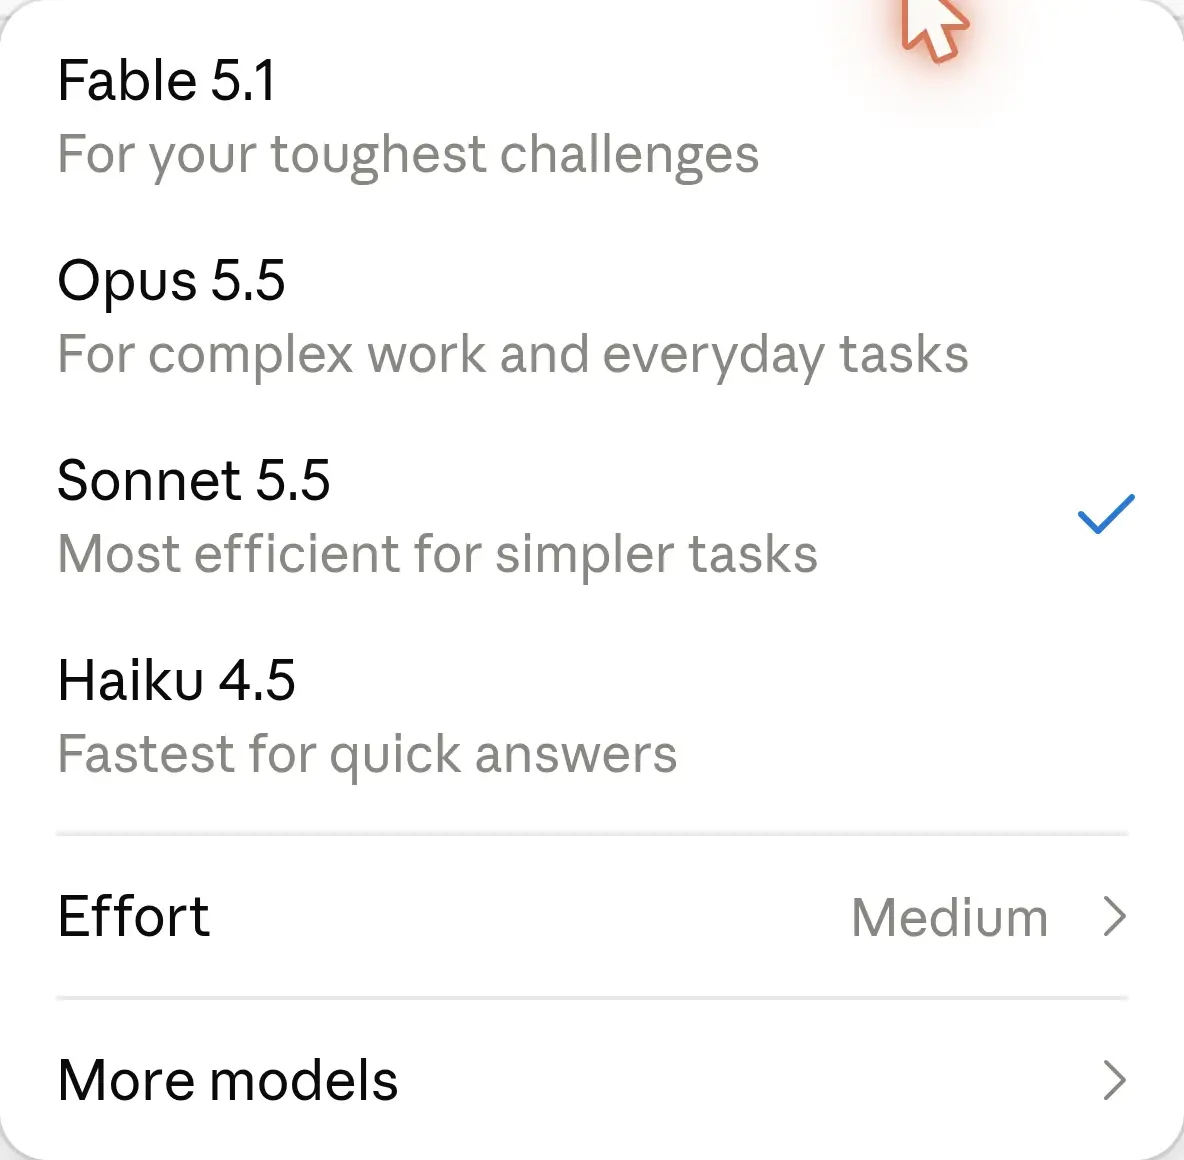
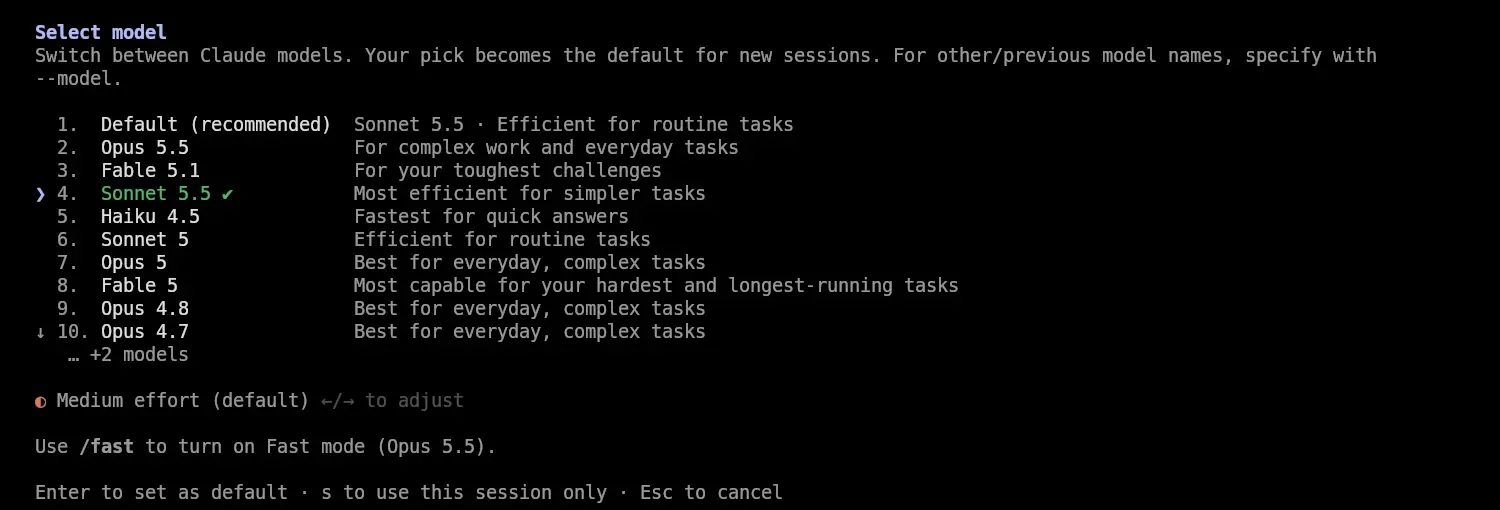
Dokumentationen säger att standardmodellen i Claude Code för Pro, Max, Team, Enterprise och API är Opus 5.5. På det Max-konto som Aipress kontrollerade öppnade både Claude Code och webbappen i stället med Sonnet 5.5 på medium. Kommandot /model visade “Default (recommended): Sonnet 5.5”. Motsägelsen mellan dokumentationen och det observerade kontot är inte löst.
Anthropics planjämförelse anger “Sonnet: Yes” för Free, Pro och båda Max-planerna, men sidan anger aldrig vilken Sonnet-version det gäller. Opus är markerad som “No” på Free. Free, Pro och Team har inte kontrollerats direkt. Detsamma gäller skrivbordsappen och mobilappen.
Aliaset sonnet är en inställning i Claude Code. På Anthropics API pekar det på Sonnet 5.5. Hos andra molnleverantörer kan samma alias fortfarande välja en äldre Sonnet-version. Den som behöver en bestämd modell bör använda hela modell-id:t.
Utvecklare som har stängt av tänkande för Sonnet måste byta till inställningen between_tools före en flytt till Sonnet 5.5. Text mellan verktygsanrop kommer nu tillbaka i tankeblock, vilket kan påverka program som förväntar sig vanlig svarstext mellan anropen.
Vanliga frågor (FAQ)
Hjälper en högre tankenivå Sonnet 5.5 att svara bättre?
Inte i Aipress korrekturtest. Medium, som är förval i Claude Code och Claude-apparna, hittade alla sju fel på 4,7 sekunder för 0,0076 dollar, medan high, xhigh och max missade samma datumfel. Max tog 43,2 sekunder och kostade 0,0703 dollar, men det var ett försök per nivå.
Är Sonnet 5.5 billigare än Sonnet 5?
Tokenpriset är oförändrat: 2 dollar per miljon indatatoken och 10 dollar per miljon utdatatoken. I Aipress sju uppgifter använde Sonnet 5.5 däremot 13 018 utdatatoken mot 19 711 för Sonnet 5, vilket sänkte den beräknade API-kostnaden från 0,769 till 0,413 dollar.
Passar Sonnet 5.5 eller Opus 5.5 bäst för vardagsarbete?
Sonnet 5.5 passar när snabbare svar och lägre kostnad väger tyngst, medan Anthropic skriver att Opus 5.5 fortfarande är tydligt starkare på öppna och komplexa uppgifter. I Aipress test klarade Sonnet 5.5 fem av sju uppgifter helt rätt på 102,6 sekunder för 0,413 dollar. Opus 5.5 klarade sex av sju på 188,8 sekunder för 1,059 dollar.
Varför svarar Claude ibland med Sonnet 5 fast jag valt Sonnet 5.5?
Claude-apparnas säkerhetsfilter kan automatiskt skicka vissa avancerade frågor om cybersäkerhet från Sonnet 5.5 till Sonnet 5. Begäranden som kan bidra till allvarlig biologisk skada blockeras i stället. På API-plattformen sker inget automatiskt byte om utvecklaren inte har konfigurerat en reservmodell, och utan en sådan kan API:et svara med statuskod 200 och en särskild stopporsak.
Vilka Claude-abonnemang får Sonnet 5.5?
Anthropic anger inte uttryckligen vilka claude.ai-abonnemang som får just Sonnet 5.5. Planjämförelsen säger endast ”Sonnet: Yes” för Free, Pro och båda Max-planerna utan att ange modellversion. På Aipress Max-konto var Sonnet 5.5 med medium förvald i både Claude Code och webbappen, men Free, Pro och Team har inte kontrollerats.
Källor
- Introducing Claude Sonnet 5.5
Anthropic, hämtad
- System Card: Claude Sonnet 5.5
Anthropic, hämtad
- Claude Sonnet 5.5
Anthropic, hämtad
- What's new in Claude Sonnet 5.5
Anthropic, hämtad
- Migrating to Claude Sonnet 5.5
Anthropic, hämtad
- Models overview
Anthropic, hämtad
- Pricing
Anthropic, hämtad
- Plans & Pricing | Claude by Anthropic
Anthropic, hämtad
- Claude Platform release notes
Anthropic, hämtad
- Model configuration
Anthropic, hämtad
- Claude Code changelog
Anthropic, hämtad
- Real-time cyber safeguards on Claude Opus and Sonnet
Anthropic, hämtad
- Anthropic’s Responsible Scaling Policy
Anthropic, hämtad
- An alignment assessment of recent cybersecurity incidents
Anthropic, hämtad
- Why Claude switched models in your conversation with Sonnet 5.5
Anthropic, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.