Modellen finns redan i DeepSeeks kostnadsfria webbchatt. Aipress har bekräftat att chatten fungerar från Sverige. Det krävs inget program: användaren öppnar chat.deepseek.com och loggar in med Google, Apple, telefonnummer eller e-postadress.
DeepSeek-V4.1-Flash kan läsa både text och bilder men lämnar sina svar som text. Det går exempelvis att ladda upp en bild av ett kvitto eller en prislista och be modellen läsa innehållet.
För utvecklare finns modellen i DeepSeeks API under namnet deepseek-flash. Modellvikterna kan också hämtas från Hugging Face och användas enligt MIT-licensen, även kommersiellt.
Hur klarade DeepSeek-V4.1-Flash Aipress vardagstest?
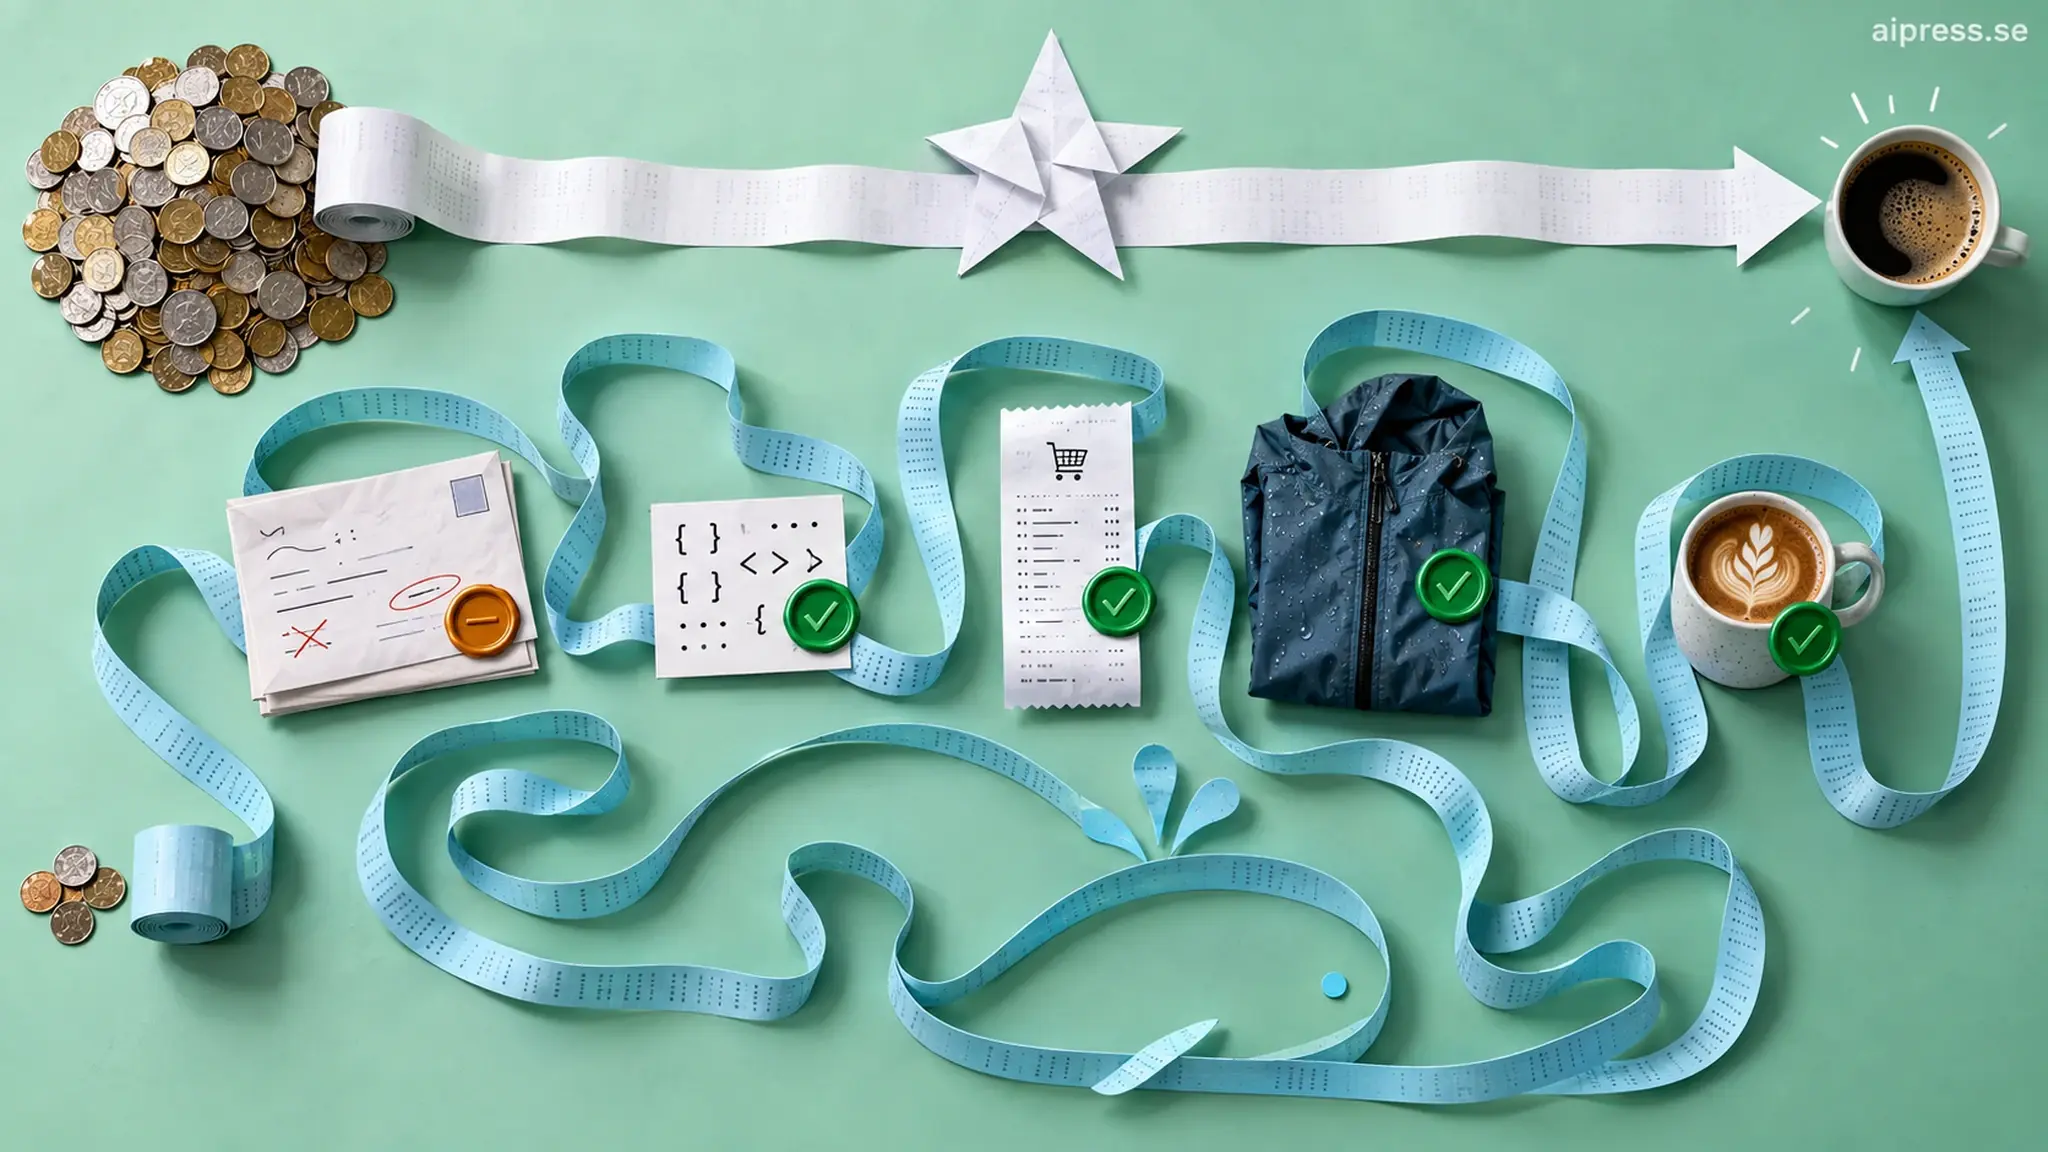
Aipress jämförde DeepSeek-V4.1-Flash med OpenAI GPT-6 Astra den 12 september. Modellerna fick samma fem instruktioner och varje test kördes en gång.
DeepSeek användes genom API:et med det tänkande standardläget aktiverat. Astra kördes med medelhög resoneringsnivå.
I korrekturtestet fick modellerna ett svenskt kundmejl med sju planterade språkfel. Astra hittade samtliga. DeepSeek upptäckte sex men lämnade datumformen ”12:e augusti” orättad.
Båda modellerna hittade två fel i en Python-funktion för en kundvagn och skrev kod som klarade alla tre kontrollfallen. Astra gjorde samtidigt en extra ändring av avrundningen som inte efterfrågades.
Nästa moment var att omvandla texten från ett ICA-kvitto till strikt JSON och kontrollera slutsumman. Båda gav giltig JSON, fick med alla sex rader och räknade fram rätt totalbelopp på 210,13 kronor.
I ett test av verktygsanrop skulle modellerna avgöra om en cyklist behövde regnjacka mellan Uppsala och Sigtuna. Båda hämtade väderdata för de två orterna och rekommenderade jackan. DeepSeek lade dock till en lista med cykeltips som ingen hade bett om.
Slutligen fick modellerna läsa en bild av en svensk kafémeny och räkna ut priset för två kanelbullar, en kaffe och en latte med havremjölk. Båda kom fram till rätt svar: 156 kronor inklusive tillägget för havremjölk.
Resultatet blev fem helt korrekta test för Astra och fyra för DeepSeek. Underlaget är för litet för att avgöra vilken modell som är bäst generellt, men visar hur de fungerar i några konkreta svenska vardagssituationer.
| Test | DeepSeek-V4.1-Flash | GPT-6 Astra |
|---|---|---|
| Svenskt korrektur | 6 av 7 fel | 7 av 7 fel |
| Rätta Python-kod | Godkänd | Godkänd |
| Kvitto till JSON | Godkänd | Godkänd |
| Anropa väderverktyg | Godkänd | Godkänd |
| Läsa kafémeny | Godkänd | Godkänd |
| Total tid | 53 sekunder | 35 sekunder |
| Total kostnad | 0,0068 USD | 0,0849 USD |
DeepSeek kostade en tolftedel så mycket eftersom testet gjordes under företagets lågpristid. Med ordinarie vardagspris hade skillnaden varit mindre: Astra skulle då ha kostat ungefär 6,3 gånger mer.
Varför använde DeepSeek-V4.1-Flash så många token?
DeepSeeks låga pris per token berättar inte hela historien. Modellen använde totalt 10 838 utdatatoken i de fem testen. Av dessa var 9 518 interna tanketoken. Astra använde 1 336 utdatatoken, varav 323 tanketoken.
I flera av de korta momenten förbrukade DeepSeek mellan 2 000 och 4 000 token på sitt resonemang innan det ganska korta svaret skrevs. Eftersom även dessa token kostar pengar blev den verkliga prisskillnaden mindre än vad prislistorna först antyder. Det omfattande resonemanget bidrog sannolikt också till att DeepSeek var långsammare i tre av fem test. Den sammanlagda tiden var 53 sekunder, jämfört med 35 sekunder för Astra.
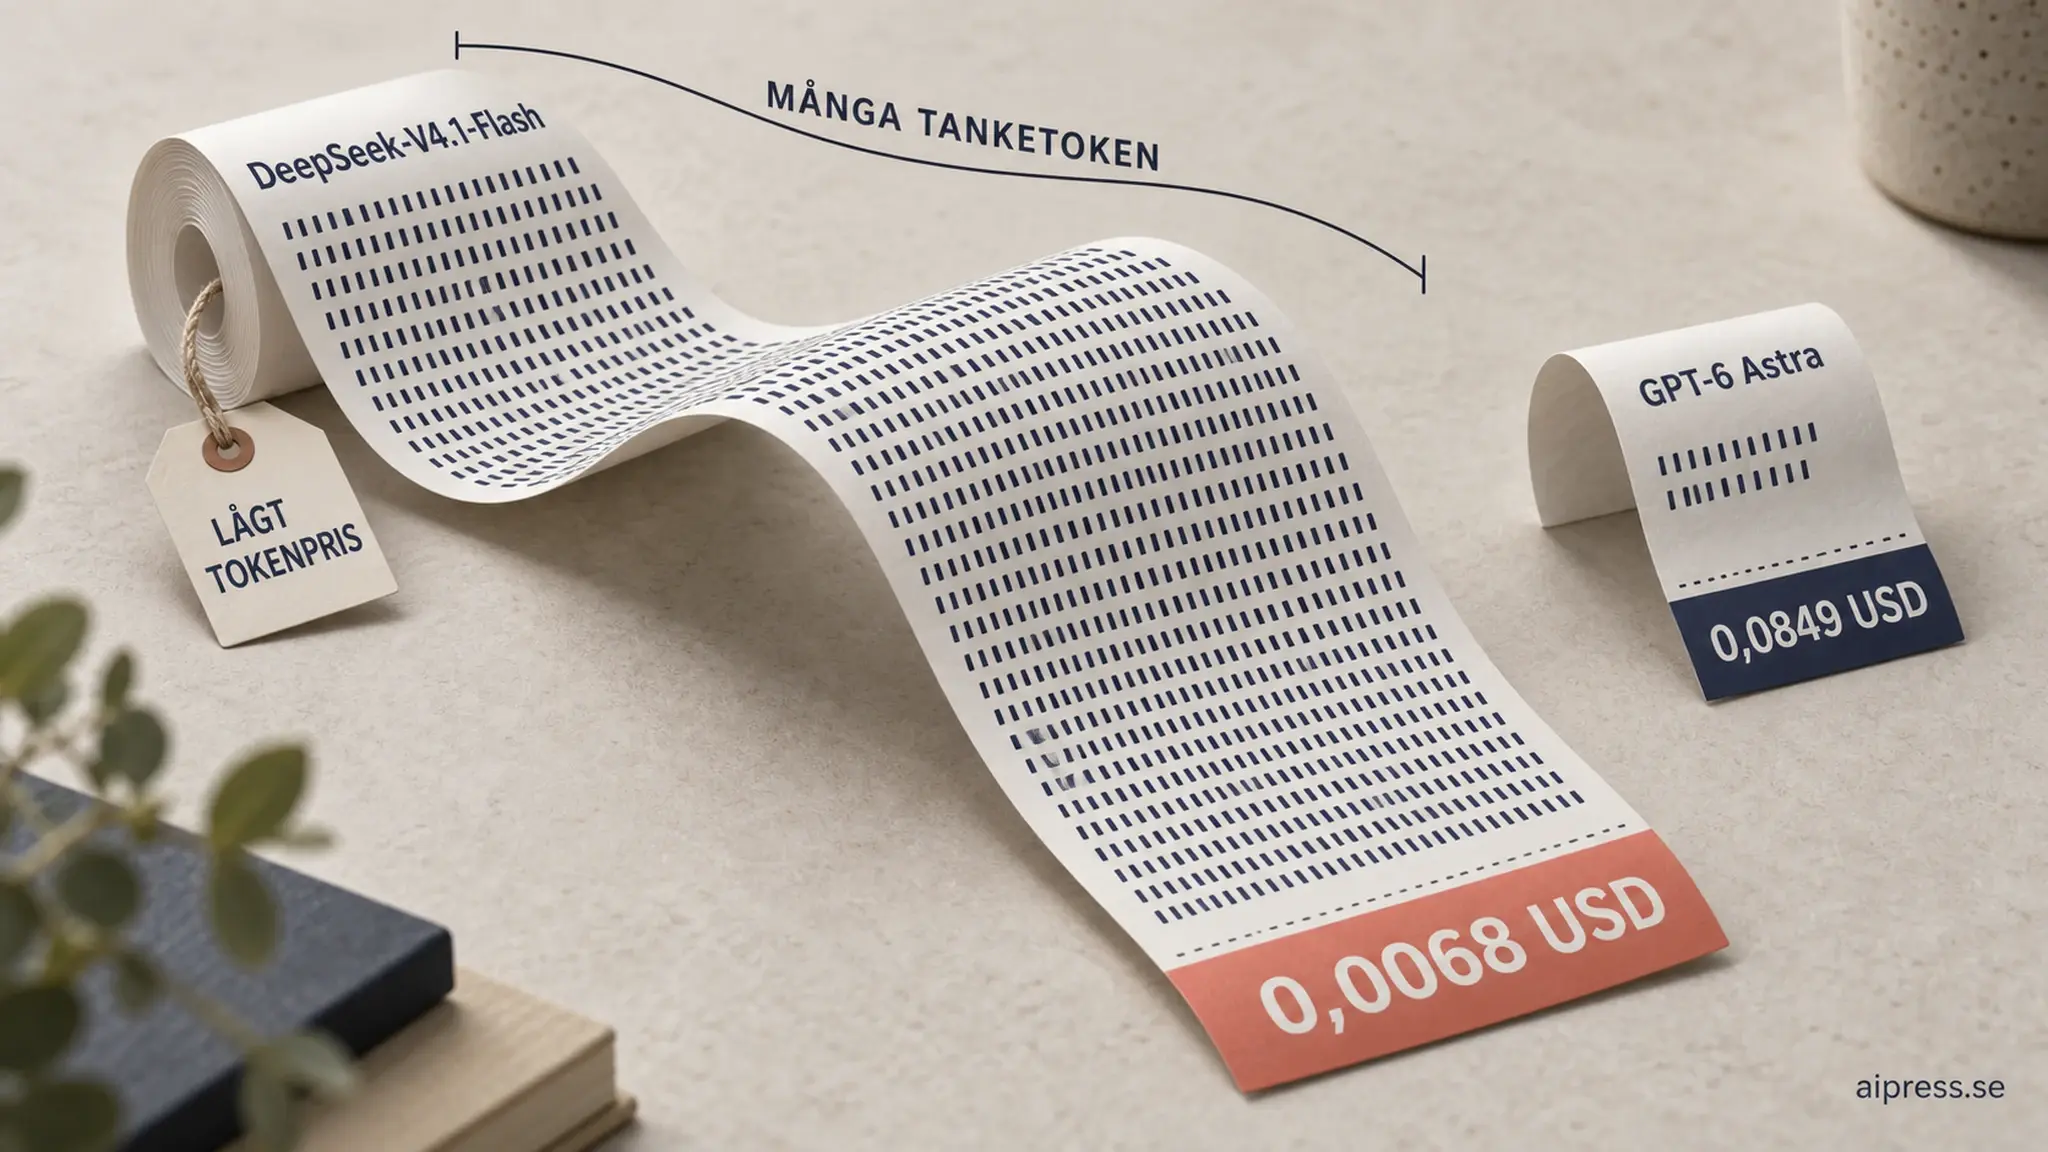
Skillnaden mot resultaten från OpenDesign kan delvis förklaras av arbetenas storlek. DeepSeeks konstruktion är särskilt anpassad för längre agentkörningar med stora mängder återanvänd indata. Aipress korta test innehöll nästan ingen cachad information, samtidigt som tankeläget producerade många debiterade utdatatoken.
API-användare bör därför följa både priset per token och modellens faktiska förbrukning. Det tänkande läget kan stängas av när ett ärende inte kräver ett långt resonemang.
Hur står sig DeepSeek-V4.1-Flash i OpenDesign?
OpenDesign har jämfört modellerna i mer omfattande arbeten som att skapa webbappar, landningssidor och kontrollpaneler. Där nådde DeepSeek-V4.1-Flash enligt organisationens mätning 98 procent av Astras sammanlagda resultat till 1,4 procent av kostnaden.
En färdig design kostade i genomsnitt 0,023 dollar med DeepSeek och 1,61 dollar med Astra. DeepSeek var samtidigt snabbare, med en genomsnittlig tid på 5,3 minuter mot 11,1 minuter.
Resultatet skilde sig mellan olika typer av arbeten. DeepSeek placerade sig bättre på webbplatser och landningssidor än på kontrollpaneler och administrationsgränssnitt. OpenDesign rekommenderar därför att modell väljs efter det aktuella arbetet, inte enbart efter totalpoängen.
Vad kostar DeepSeek-V4.1-Flash?
DeepSeek använder två prisnivåer. Lågpriset gäller hela helgen och under större delen av vardagsdygnet. Under svensk sommartid gäller ordinarie pris på vardagar klockan 03.00 till 06.00 och 08.00 till 12.00.
Priserna anges i dollar per miljon token:
| Användning | Ordinarie pris | Lågpris | GPT-6 Astra (OpenAI) |
|---|---|---|---|
| Indata utan cacheträff | 0,30 USD | 0,15 USD | 10 USD |
| Indata med cacheträff | 0,006 USD | 0,003 USD | 1 USD |
| Utdata | 1,20 USD | 0,60 USD | 50 USD |
En cacheträff uppstår när modellen kan återanvända indata som redan har behandlats, exempelvis en lång kodbas eller dokumentation som följer med i flera steg av samma arbetsflöde. Det är där modellens lägsta pris kan få störst betydelse.
API-kunder fyller på ett saldo i dollar som användningen dras från. DeepSeek erbjuder ingen svensk prissättning i kronor. Den vanliga webbchatten är däremot gratis.
DeepSeek-V4.1-Flash minskar minnesbehovet med en ny konstruktion
DeepSeek-V4.1-Flash innehåller totalt 552 miljarder parametrar. Det betyder inte att hela modellen används för varje ord. Konstruktionen är en så kallad expertblandning där olika delar aktiveras beroende på innehållet.
Enligt modellkortet aktiveras omkring 8 miljarder parametrar per token när modellen läser in material och 16 miljarder när den skriver svaret. DeepSeek kallar konstruktionen för en asymmetrisk Causal Encoder-Decoder.
Modellens arbetsminne för tidigare token, den så kallade KV-cachen, har minskats till ungefär en fjärdedel av föregångarens storlek. Den del av cachen som lagras på SSD ska bara kräva en åttondel så mycket utrymme.
Den tekniska förändringen har ett tydligt ekonomiskt syfte. Långa AI-agenter behöver ofta läsa samma filer och tidigare meddelanden om och om igen. Ett mindre minnesbehov gör sådan användning billigare och ger utrymme för fler samtidiga körningar.
Modellen har ett kontextfönster på en miljon token och kan som mest lämna 384 000 utdatatoken. Den stöder bland annat verktygsanrop, JSON-svar samt API-format som är kompatibla med OpenAI Responses API och Anthropics API.
DeepSeek-V4.1-Flash presterar ojämnt i företagets egna test
DeepSeek uppger att V4.1-Flash slår den större V4-Pro i flera test och når samma nivå som betydligt dyrare modeller i vissa agentmoment. I företagets egen mätning fick modellen exempelvis 90,6 poäng i Terminal-Bench 2.1 och 74,2 i DeepSWE. Testerna mäter arbete i terminalmiljö respektive rättning av verkliga programfel.
I svårare kunskaps- och resonemangstest var bilden en annan. DeepSeek-V4.1-Flash fick 36,8 poäng på Humanity’s Last Exam, jämfört med 44,5 för GPT-5.6 Sol och 56,3 för Claude Opus 5.0. I Terminal-Bench 4.0 hamnade Flash också tydligt efter Opus.
Siffrorna kommer från DeepSeek och bygger på modellens högsta resoneringsnivå. De bör därför läsas som leverantörens mätningar, inte som en oberoende garanti för hur modellen fungerar i andra tjänster eller med standardinställningar.
Fungerar DeepSeek-V4.1-Flash gratis i Sverige?
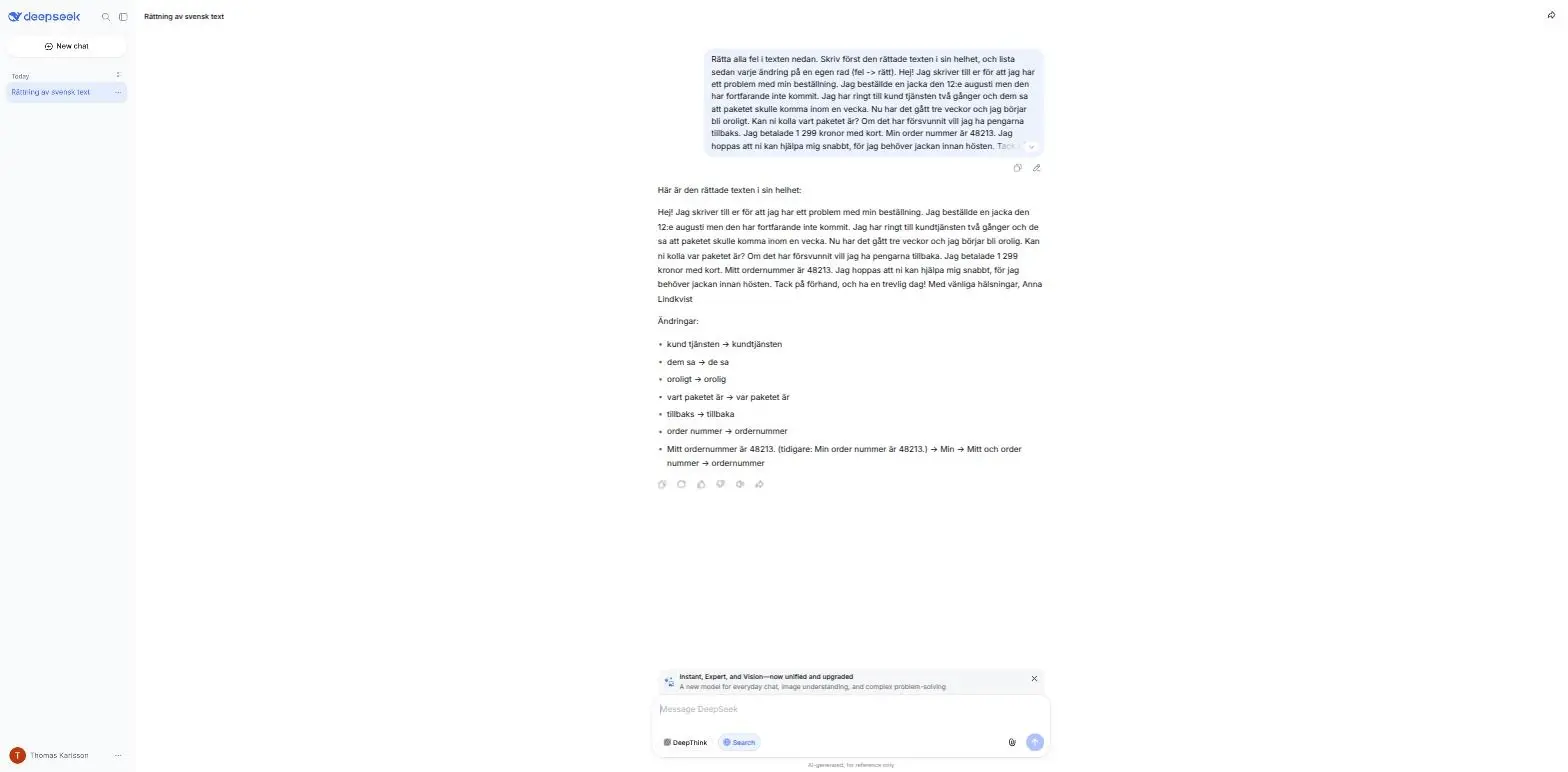
Aipress kunde använda DeepSeeks webbchatt från Sverige med ett vanligt Google-konto. Efter inloggningen efterfrågades födelseår och födelsemånad för ålderskontroll.
Under textrutan finns valen DeepThink och Search. DeepThink aktiverar modellens mer omfattande resonemang, medan Search ger den möjlighet att söka på webben. Det går även att bifoga bilder.
När Aipress körde korrekturtestet i det vanliga chattläget, utan DeepThink, svarade modellen på svenska efter omkring tio sekunder. Resultatet blev detsamma som i API-testet: sex av sju fel hittades.
De öppna modellvikterna finns också tillgängliga för svenska användare genom Hugging Face. Att köra hela modellen lokalt är dock inget realistiskt alternativ på en vanlig dator. De 552 miljarder parametrarna kräver mycket omfattande serverutrustning.
Så lagrar DeepSeek dina personuppgifter i Kina
I DeepSeeks integritetspolicy, senast uppdaterad den 10 februari 2026, står att företaget samlar in bland annat användarens instruktioner, uppladdade filer, bilder, chatthistorik samt konto- och betalningsinformation. DeepSeek uppger att personuppgifterna samlas in, behandlas och lagras i Kina. Hur länge de behålls anges endast som så länge det behövs för att tillhandahålla tjänsterna eller uppfylla rättsliga och avtalsmässiga krav.
Om lagringsplatsen skriver DeepSeek så här:
The Personal Data we collect from you may be stored on a server located outside of the country where you live. To provide you with our services, we directly collect, process and store your Personal Data in People’s Republic of China.
Det betyder att allt du skriver i chatten eller skickar genom API:et hamnar på servrar i Kina, och att det gäller lika för gratischatten och betalkunder.
För svenska företag och myndigheter kan användningen därmed innebära att personuppgifter överförs till ett land utanför EU och EES. Integritetsskyddsmyndigheten anger att sådana överföringar bara är tillåtna under vissa förutsättningar. Det räcker alltså inte att en AI-tjänst går att öppna från Sverige för att den ska vara lämplig för kunddata, personalinformation eller annat skyddsvärt material. Den kostnadsfria chatten och DeepSeeks API bör därför inte användas för känsligt innehåll utan en noggrann kontroll av dataskyddet.
Den som hämtar de öppna vikterna och driver modellen helt på egen utrustning behöver däremot inte skicka sina instruktioner till DeepSeek. Det är den viktigaste integritetsskillnaden mellan den nedladdningsbara modellen och företagets chatt eller API.
DeepSeek-V4.1-Flash ersätter äldre Flash-modeller
DeepSeek har pensionerat V4-Flash och V4-Flash-Vision-Exp. Anrop med de gamla modellnamnen skickas tills vidare vidare till V4.1-Flash och debiteras enligt det nya Flash-priset.
Vad som händer med V4-Pro är mindre tydligt. I lanseringsinformationen står att anrop till modellen ska styras om till V4.1-Flash från den 14 september i väntan på V4.1-Pro. På prissidan står samtidigt att V4-Pro får fortsätta efter önskemål från användarna och behåller sin nuvarande prissättning. Befintliga API-kunder bör därför kontrollera modell och kostnad i sina egna anrop efter den 14 september.
Vanliga frågor om DeepSeek V4.1 Flash
Fungerar DeepSeek V4.1 Flash på svenska?
Ja, DeepSeek V4.1 Flash svarade på svenska i både webbchatten och API:et i Aipress test. Modellen hittade sex av sju planterade fel i ett svenskt kundmejl, läste ett svenskt ICA-kvitto till korrekt JSON och räknade rätt på en svensk kaféprislista i en bild, men missade datumformen ”12:e augusti”.
Kan jag använda DeepSeek V4.1 Flash på jobbet?
Ja, men undvik att skicka personuppgifter eller känslig företagsinformation till DeepSeek V4.1 Flash utan att arbetsgivaren först har bedömt dataskyddet. DeepSeeks integritetspolicy anger att personuppgifter behandlas och lagras i Kina, medan Integritetsskyddsmyndigheten kräver att vissa villkor är uppfyllda för överföring utanför EU och EES. Om du laddar ner de öppna vikterna och kör modellen på egen utrustning skickas inga uppgifter till DeepSeek.
Källor
- DeepSeek-V4.1-Flash Release
DeepSeek, hämtad
- Models & Pricing
DeepSeek, hämtad
- DeepSeek-V4.1-Flash
DeepSeek via Hugging Face, hämtad
- We benchmarked DeepSeek V4.1 Flash
OpenDesign on X, hämtad
- DeepSeek Privacy Policy
DeepSeek, hämtad
- Pricing
OpenAI, hämtad
- Överföring till tredje land
Integritetsskyddsmyndigheten, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.