Promptcachning kan sänka kostnaden när ett företag skickar samma långa instruktion till en AI-modell flera gånger. Modellen behöver då inte behandla hela texten på nytt, utan kan läsa den redan bearbetade början från cachen. Textmängden mäts i token. En token motsvarar ungefär ett ord eller en del av ett ord.
Problemet har varit att en missad cacheträff inte ger något vanligt felmeddelande. Anropet fungerar fortfarande, men kan bli betydligt dyrare. Utvecklaren har behövt granska antalet cachade och nyskrivna token och sedan själv försöka hitta vad som förändrats.
Den 8 september 2026 gjorde OpenAI Prompt Cache Diagnostics allmänt tillgängligt i Responses API för GPT-5.6 och senare modeller som stöder funktionen. Verktyget kontrollerar ett nytt API-svar mot ett tidigare och försöker namnge orsaken till att ett förväntat promptprefix inte kunde läsas från cachen.
Funktionen gäller OpenAI API, inte vanliga samtal i ChatGPT.
Hur fungerar kontrollen?
Ett promptprefix är den sammanhängande text som ligger först i ett API-anrop. Det kan exempelvis bestå av en lång kundtjänstinstruktion, företagets regler och en lista över verktyg som modellen får använda. För GPT-5.6 och senare måste den cachningsbara delen vara minst 1 024 token lång.
Funktionen behöver ett tidigare, slutfört API-svar som bas. Följande exempel visar först basanropet och därefter ett nytt anrop som skickar det första svarets id i prompt_cache_options:
from openai import OpenAI

client = OpenAI()

first = client.responses.create(
    model="gpt-5.6-sol",
    instructions=policy,
    input="Vad kostar frakten till Umeå?",
)

second = client.responses.create(
    model="gpt-5.6-sol",
    instructions=policy,
    input="Vad kostar frakten till Kiruna?",
    prompt_cache_options={
        "comparison_response_id": first.id
    },
)
Beskedet finns i fältet prompt_cache_diagnostics. En miss kan exempelvis se ut så här:
{
  "type": "cache_miss",
  "reason": "tools_changed",
  "comparison_reusable_tokens": 2442,
  "cache_missed_tokens": 2442
}
comparison_response_id hämtar inte innehållet i det tidigare svaret och fortsätter inte automatiskt en konversation. Inställningen begär bara en kontroll mot basen. Den påverkar inte heller vilken text som cachas.
I ett samtal med flera turer kan utvecklaren spara id-numret från varje svar och skicka det vid nästa tur. Vid felsökning är det bättre att behålla samma felande basanrop tills problemet har försvunnit.
Fyra ändringar som verktyget identifierade
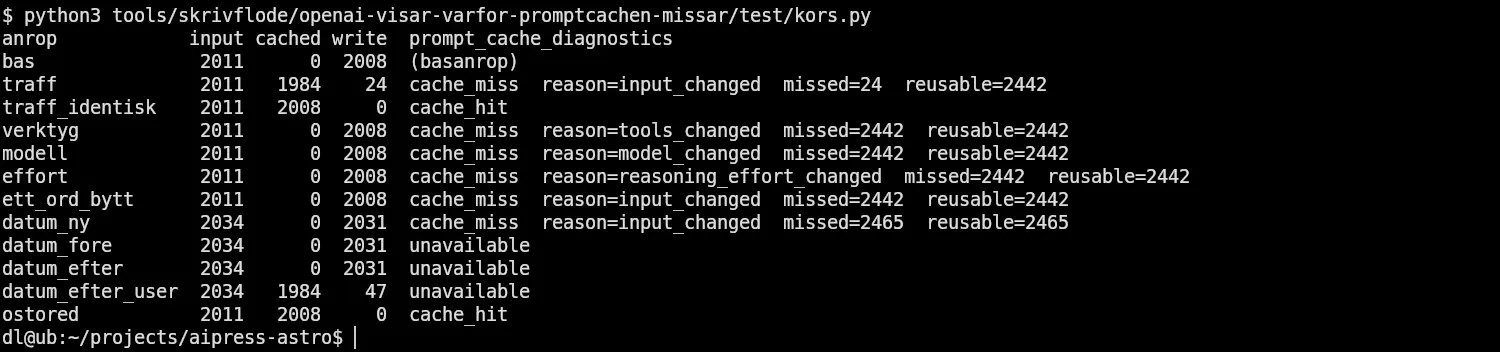
Vi testade funktionen den 10 september med samma upplägg som i vår tidigare granskning av OpenAI:s promptcachning.
Testet använde en cirka 2 000 token lång svensk kundtjänstinstruktion för det påhittade företaget Nordlig Fritid AB. Instruktionen följdes av en kort kundfråga. Modellen var GPT-5.6 Sol, resoneringsnivån var låg och svaret begränsades till 64 token.
Först skickade vi ett basanrop. Därefter ändrade vi en sak i taget och kontrollerade varje nytt svar mot basen.
| Vad vi ändrade | Besked från verktyget | Lästa cachetoken enligt usage |
|---|---|---|
Verktyget get_time döptes om till get_date |
tools_changed |
0 |
| GPT-5.6 Sol ersattes av GPT-6 Astra | model_changed |
0 |
| Resoneringsnivån ändrades från låg till medium | reasoning_effort_changed |
0 |
| Orten Östersund i instruktionen ersattes med Sundsvall | input_changed |
0 |
I samtliga fyra fall uppskattade verktyget att hela det cachningsbara prefixet på 2 442 token hade missats. Ett tidigare osynligt kostnadsproblem fick därmed en konkret förklaring.
Kan en tidsstämpel slå ut hela cachen?
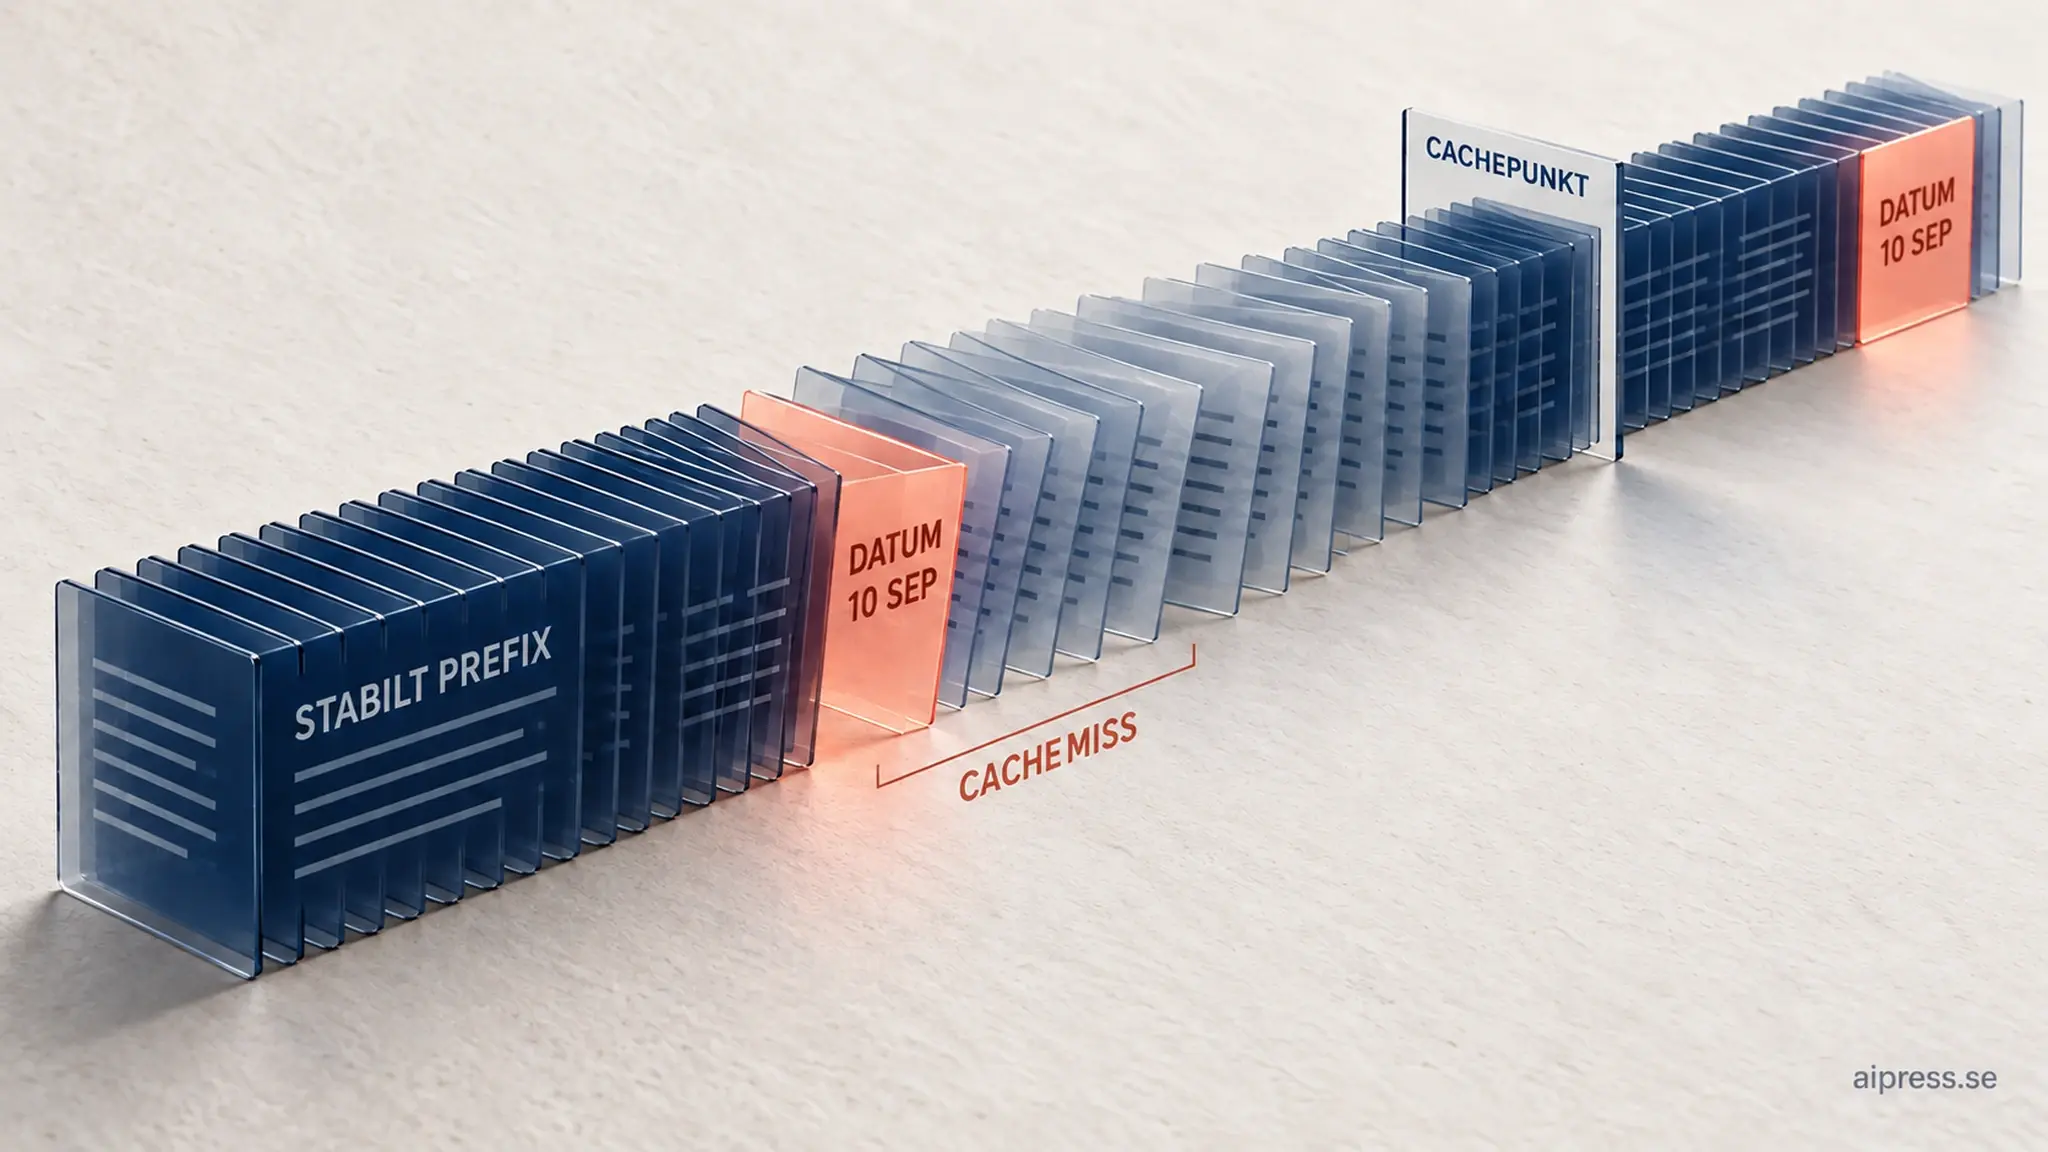
I vår tidigare granskning visade vi hur datum och klockslag kan förstöra cacheträffarna om uppgifterna placeras i den del av prompten som ska vara stabil.
Vi upprepade nu ett mer realistiskt exempel. Både basanropet och det nya anropet innehöll en datumrad på samma plats, men tiden ändrades mellan körningarna.
Verktyget svarade input_changed och angav att samtliga 2 465 cachningsbara token hade missats. API-svarets usage-fält bekräftade resultatet: inga token lästes från cachen och drygt 2 000 skrevs på nytt.
Det ger en tydlig felsökningsväg. Om en applikation placerar aktuellt datum, ett slumpmässigt id-nummer eller en användaruppgift före cachepunkten kan funktionen visa att indata har förändrats. Utvecklaren kan därefter flytta den rörliga informationen efter den stabila delen och göra ett nytt test.
Även avsiktliga ändringar kan räknas som cachemiss
Ett av resultaten kräver mer eftertanke.
När vi behöll hela instruktionen men skickade en ny kundfråga rapporterades cache_miss med orsaken input_changed. Endast 24 token angavs som missade. Samtidigt visade kostnadskvittot att 1 984 av 2 011 indatatoken hade hämtats från cachen.
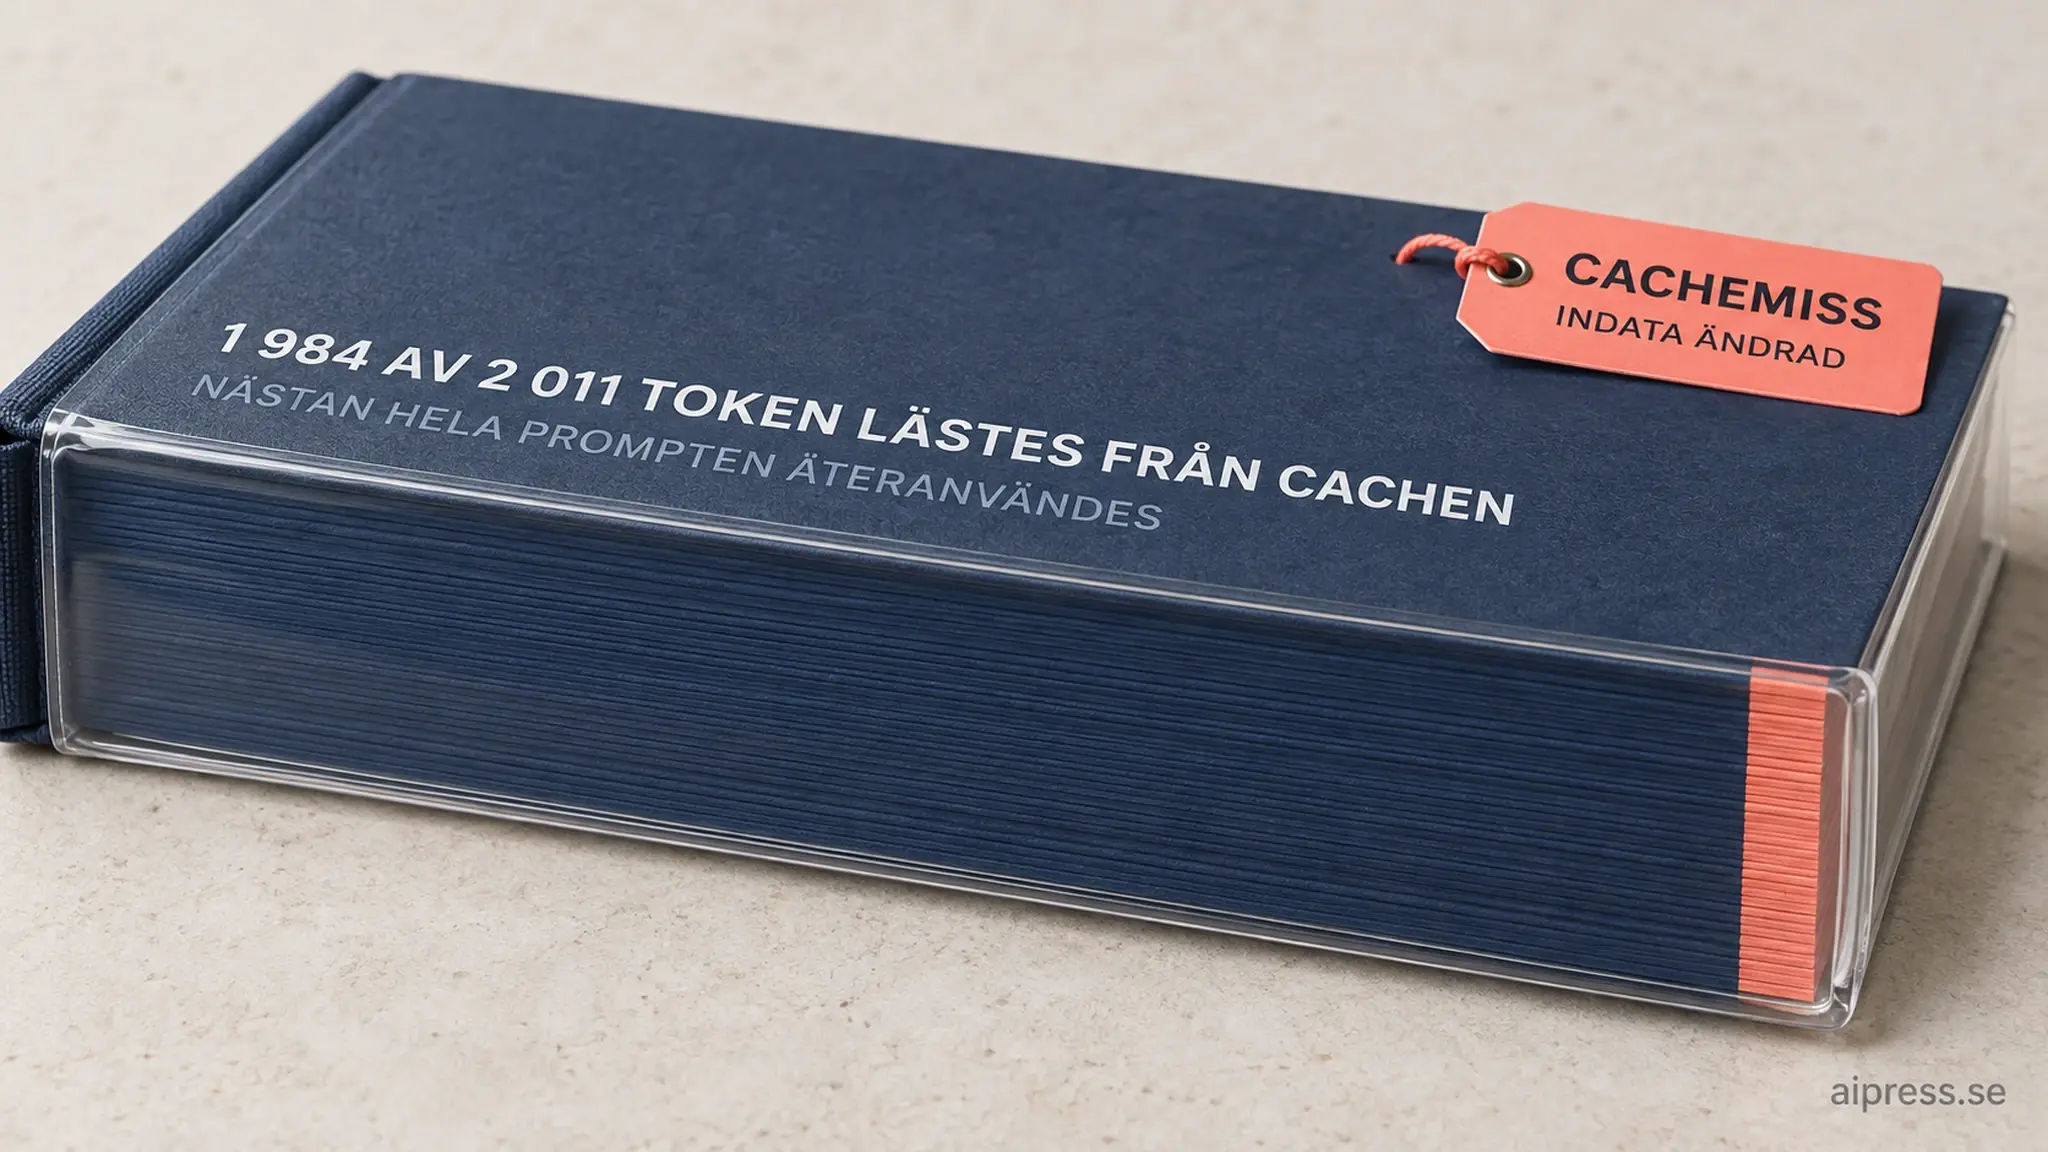
Ekonomiskt fungerade cachningen alltså nästan helt som avsett. Bara den nya frågan behövde behandlas. Resultatet kallades ändå en miss eftersom verktyget hittade en förändring.
Ett cache_hit betyder på motsvarande sätt inte att hela det nya anropet kom från cachen. Beskedet betyder att ingen oväntad skillnad upptäcktes i det granskade prefixet. Ny text därefter måste fortfarande behandlas.
Fälten fyller därför olika funktioner:
prompt_cache_diagnosticsförklarar vad som ändrades.usage.input_tokens_details.cached_tokensvisar hur många token som lästes från cachen.cache_write_tokensvisar hur mycket som skrevs dit på nytt.
Kostnadsberäkningen ska utgå från värdena i usage.
När ger verktyget upp?
Resultaten var tydligast när basanropet och det nya anropet hade samma övergripande struktur.
Vi provade även att lägga till en ny datumrad i ett anrop vars basversion saknade datumet. Raden placerades på flera olika sätt: före instruktionen, efter instruktionen, som ett separat användarmeddelande och sist i själva instruktionstexten.
I fem sådana varianter svarade verktyget enbart:
unavailableTvå av testen kördes om efter flera minuter med samma resultat. Det talar emot att posten bara behövde mer tid för att bli tillgänglig.
OpenAI beskriver funktionen som en kontroll som arbetar efter bästa förmåga och inte alltid kan klassificera en miss. unavailable betyder varken träff eller miss. API-anropet genomförs fortfarande som vanligt, men utvecklaren får ingen säker förklaring.
Våra resultat tyder på att verktyget är bra på att namnge en förändring när anropen har jämförbar form. Om meddelanden läggs till eller promptens struktur byggs om kan beskedet utebli. Det är en observation från vårt begränsade test, inte en dokumenterad regel hos OpenAI.
Varför spelar datumradens placering så stor roll?
Testet visade att det inte räckte att lägga en separat developer-rad med datum efter den långa instruktionen. Resultatet blev ändå noll lästa cachetoken och nästan hela prompten skrevs in på nytt.
När samma datumrad i stället skickades som ett user-meddelande efter instruktionen hämtades 1 984 token från cachen.
En rimlig förklaring är att de inledande developer-meddelandena behandlas som ett sammanhängande block när cachepunkten placeras automatiskt. En föränderlig rad i blocket kan därför slå ut den stabila texten även om raden står sist bland developer-meddelandena.
Stabila instruktioner bör ligga först och föränderligt innehåll skickas senare i konversationen. Med GPT-5.6 går det också att använda en uttrycklig cachepunkt som markerar exakt var den stabila delen slutar.
Fyra besked promptcachens diagnostik kan ge
| Resultat | Innebörd |
|---|---|
cache_hit |
Ingen cachemiss upptäcktes. Kontrollera ändå cached_tokens för att se den faktiska cacheanvändningen. |
cache_miss |
En skillnad hindrade hela eller delar av det förväntade prefixet från att hämtas från cachen. |
comparison_response_not_found |
Den diagnostikpost som hör till det tidigare svaret saknas eller har löpt ut. |
unavailable |
Kontrollen kunde inte ge ett säkert resultat eller modellen stöder inte funktionen. |
Bland orsakerna finns ändrad modell, tjänstenivå, verktygslista, utdataschema, resoneringsnivå, svarslängd och indata. Även komprimering av en lång konversation kan förändra prefixet.
Verktyget visar bara den första orsak som det kan klassificera. När ett fel har rättats kan nästa försök därför avslöja ytterligare en skillnad.
Tokenvärdena går inte alltid att ställa bredvid varandra
I våra svar angavs 2 442 cachningsbara token, trots att samma anrop redovisade 2 011 indatatoken i usage.
Det är inte ett bevis på feldebitering. OpenAI uppger att uppskattningarna i prompt_cache_diagnostics och värdena i usage kan beräknas på olika sätt. Vid fakturering och kostnadskontroll ska utvecklaren använda usage, inte comparison_reusable_tokens eller cache_missed_tokens.
Ett företag bör därför följa både enskilda felbesked och den samlade panelen för promptcachning. Det första hjälper vid felsökning av ett bestämt anrop. Panelen visar om problemet återkommer i den verkliga trafiken.
Vad kostar felsökningen?
Prompt Cache Diagnostics har enligt OpenAI ingen separat kostnad och förbrukar inte någon egen del av API:ts hastighetsgränser. Basanrop, testanrop och omkörningar debiteras däremot som vanliga modellförfrågningar.
I vårt test låg svarstiden mellan 1,4 och 3,2 sekunder per anrop. Samtliga 17 anrop kostade tillsammans mindre än 20 amerikanska cent enligt prislistan den 10 september.
För GPT-5.6 Sol kostade då en miljon vanliga indatatoken 4 dollar och cachad indata 0,40 dollar. En cacheskrivning kostade 5 dollar, medan utdata kostade 20 dollar per miljon token. Cachad indata kostade därmed en tiondel av ordinarie indata, medan skrivningen var 25 procent dyrare.
Priset på GPT-5.6 Sol var ett kampanjpris som enligt OpenAI skulle gälla åtminstone till den 21 november 2026.
Diagnostiken fungerar även utan lagrade svar
Inställningen store: false användes i både basanropet och det efterföljande anropet. Det andra svaret gav cache_hit och hämtade 2 008 token från cachen.
Inställningen hindrade alltså inte kontrollen. OpenAI uppger även att funktionen är förenlig med Zero Data Retention. Enligt dokumentationen sparas inga råa promptar eller modellsvar för själva analysen. I stället används organisationsbundna poster med inställningsuppgifter, tokenuppskattningar och hashvärden. Posterna löper ut efter en kort tid.
Vårt omdöme
Prompt Cache Diagnostics gör felsökningen betydligt mer konkret. I stället för att bara se noll cachade token kan utvecklaren få reda på att modellen ändrades, att ett verktyg döptes om eller att en tidsstämpel hamnade i den stabila delen av prompten.
Funktionen är däremot inget fullständigt facit. cache_miss kan avse några få avsiktligt ändrade token trots att nästan hela prompten hämtades från cachen. unavailable kan visas även när usage tydligt avslöjar att cacheträffen uteblev.
Det praktiska arbetssättet är att först läsa felorsaken och sedan kontrollera cached_tokens, cache_write_tokens och den verkliga kostnaden. Om verktyget inte kan klassificera problemet gäller samma grundregel som tidigare: behåll modell, verktyg och inställningar stabila, placera gemensamma instruktioner först och flytta datum, användaruppgifter och andra föränderliga delar efter cachepunkten.
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.