Den 20 augusti 2026 lade OpenAI till en särskild flik för promptcachning på API-plattformens sida Usage. Fliken heter ”Prompt caching” och ligger bredvid de äldre flikarna för bland annat API-funktioner, kostnadskategorier och säkerhet. Där visas hur stor andel av den återanvändbara texten som hämtas från cacheminnet, hur många cacheläsningar som görs per skrivning och hur många token som läses, skrivs eller behandlas utan cache. Statistiken kan filtreras efter modell och tjänstenivå.
Nyheten gäller OpenAI API, alltså den tjänst som utvecklare och företag betalar för utifrån användning. Inget av detta gäller den som använder ChatGPT i appen eller webbläsaren. Ett ChatGPT-abonnemang har ett fast månadspris.
Vi körde testet från en dator i Sverige. Både API:t och den nya panelen fungerade som vanligt härifrån. Panelen kräver inloggning till en API-organisation.
Vad är promptcachning?
När ett företag använder en AI-modell för kundtjänst skickas vanligen betydligt mer än kundens fråga. Före frågan kan det ligga en lång instruktion med leveransvillkor, returregler, prisuppgifter, skrivregler och information om hur svaret ska utformas.
Instruktionen är ofta likadan i varje anrop, medan själva kundfrågan bara består av några få meningar. Utan återanvändning behöver modellen behandla hela texten varje gång.
Promptcachning innebär att OpenAI under en begränsad tid sparar bearbetningen av början på en prompt. Om ett senare API-anrop börjar med exakt samma innehåll kan modellen återanvända det tidigare arbetet. Dessa token debiteras då som cachad indata till en lägre kostnad.
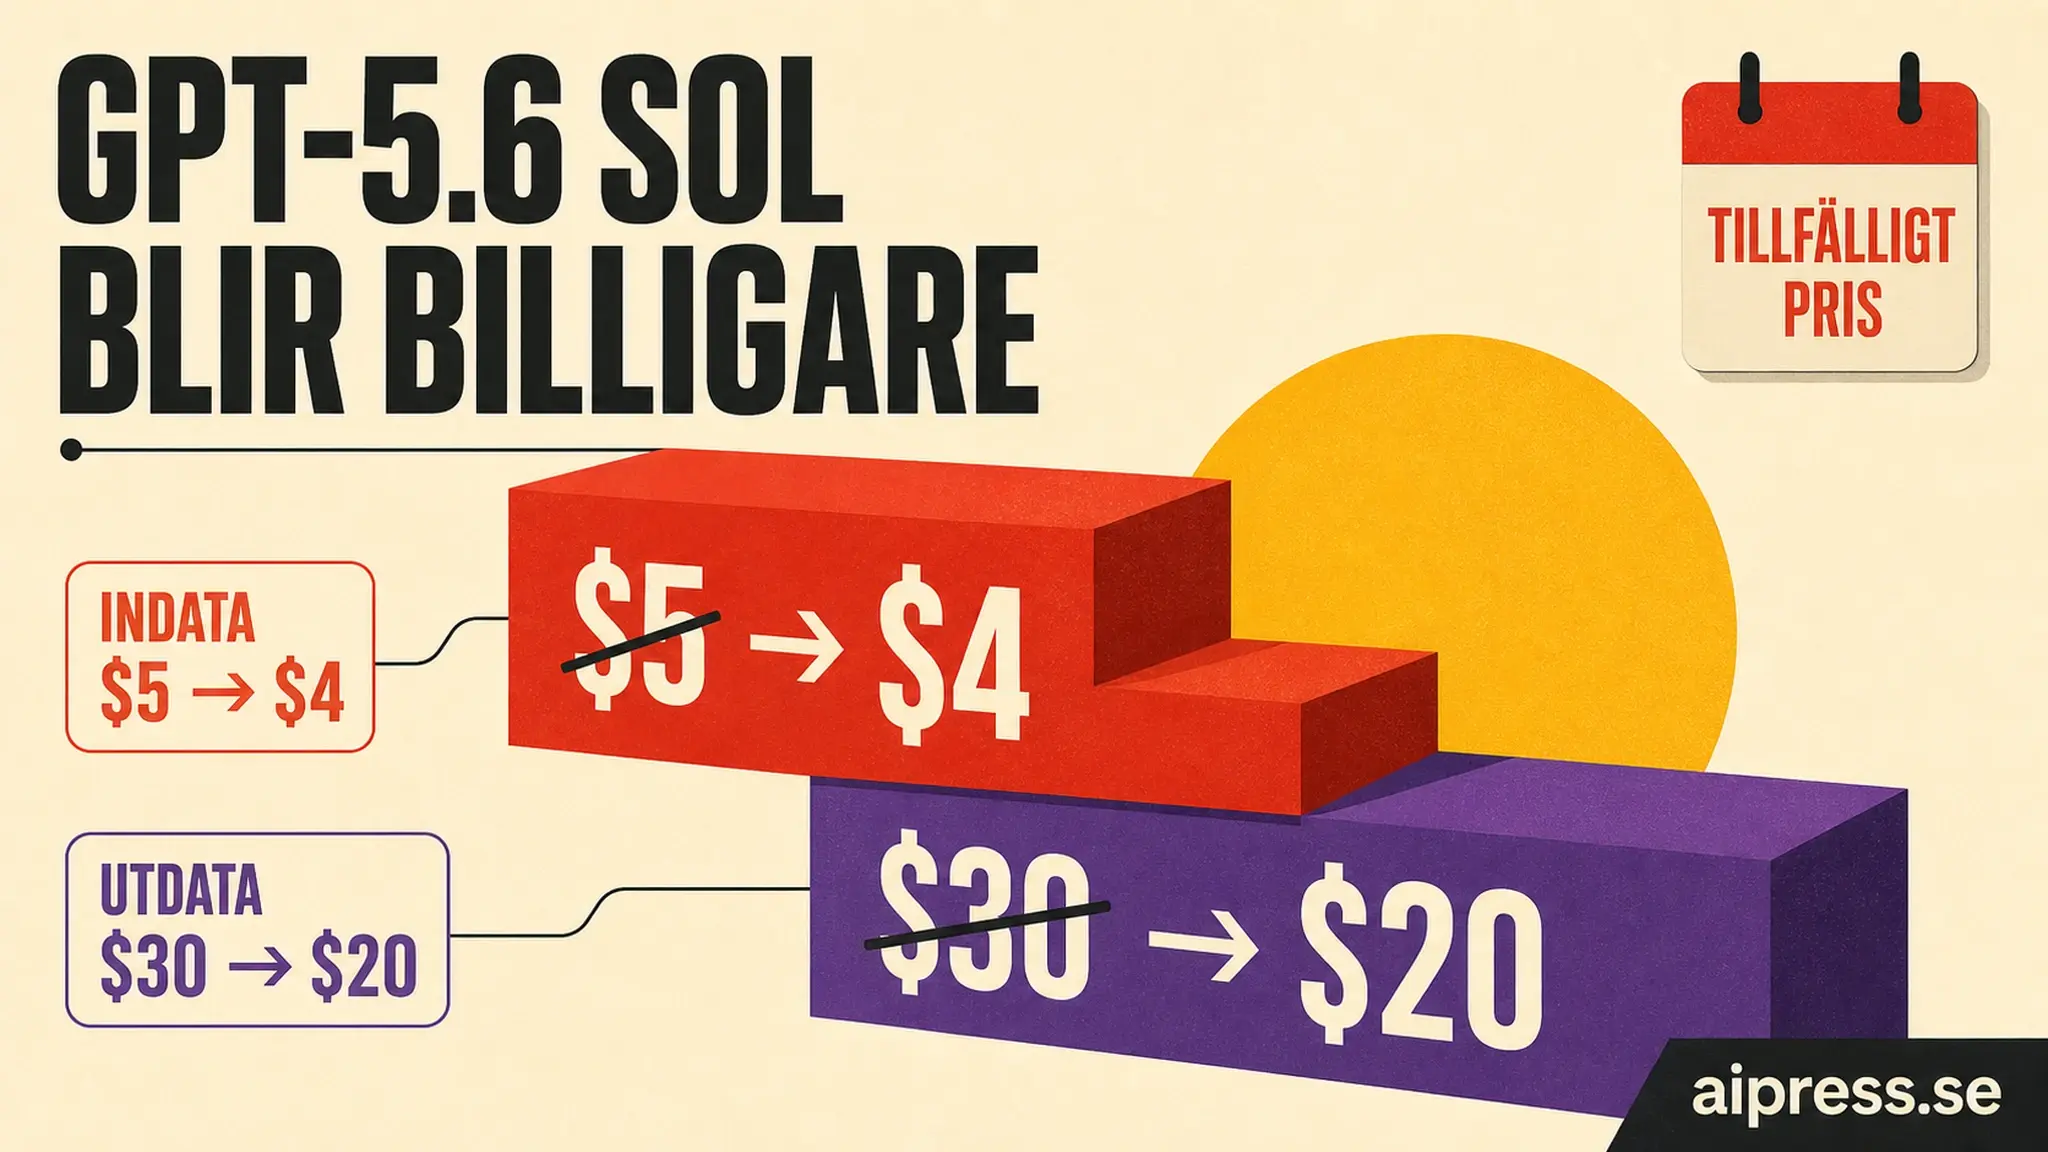
För GPT-5.6 Sol kostar vanlig indata 5 dollar per miljon token och cachad indata 0,50 dollar. Att läsa från cacheminnet kostar alltså en tiondel av det vanliga priset.
GPT-5.6 har samtidigt infört en kostnad för att skriva till cacheminnet. En cacheskrivning debiteras med 1,25 gånger det vanliga indatapriset, vilket för GPT-5.6 Sol motsvarar 6,25 dollar per miljon token. En cachad text som aldrig används igen blir därför dyrare än om den hade behandlats som vanlig indata.
Så ska prompten byggas för att cachningen ska fungera
För GPT-5.6 gäller några regler som får stor betydelse för kostnaden:
- Den återanvändbara början av prompten måste vara minst 1 024 token lång.
- Allt fram till cachepunkten måste överensstämma exakt mellan anropen.
- Stabil text bör ligga först och sådant som förändras, exempelvis datum, kunduppgifter och den aktuella frågan, sist.
- Cacheminnet gäller i 30 minuter från den senaste skrivningen eller användningen. Varje träff förlänger tiden utan att utlösa en ny skrivavgift.
- Ett gemensamt
prompt_cache_keyhjälper OpenAI att styra anrop med samma instruktion till rätt cache. OpenAI rekommenderar ungefär högst 15 anrop per minut och nyckel. - Med en explicit cachepunkt kan utvecklaren själv markera var den stabila delen slutar.
Promptcachningen aktiveras automatiskt för tillräckligt långa anrop, men det betyder inte att den alltid ger en besparing. Hur prompten är sammansatt avgör om OpenAI kan återanvända texten eller skriver en ny kopia vid varje anrop.
Så testade vi en instruktion för svensk kundtjänst
För testet skrev vi instruktionen till en kundtjänstfunktion åt det fiktiva företaget Nordlig Fritid AB. Den innehöll information om leveranstider, fraktavgifter, returer, garantier, betalningssätt, storleksråd och hur svaren skulle formuleras.
Texten bestod av omkring 1 100 svenska ord. API:t räknade den till cirka 1 950 token. Token är de mindre textenheter som AI-modellen arbetar med, och förhållandet mellan ord och token varierar mellan språk och texter.
Till instruktionen fogade vi fem olika kundfrågor, bland annat vad frakten kostar för en beställning till Umeå och vad kunden bör göra när ett tält inte har kommit efter nio arbetsdagar. Frågorna var omkring 20 token långa.
Vi körde fem varianter:
- Den långa instruktionen följd av kundfrågan, utan cachepunkt eller särskild cachenyckel.
- Samma upplägg, men med
prompt_cache_key. - Instruktionen följd av aktuellt datum och klockslag och därefter frågan.
- Samma datumrad, men med en explicit cachepunkt direkt efter den stabila instruktionen.
- En förkortad instruktion på omkring 490 token, alltså under minimigränsen.
Varje variant kördes med GPT-5.6 Sol genom Responses API. Vi skickade fem frågor per scenario med tre sekunders mellanrum.
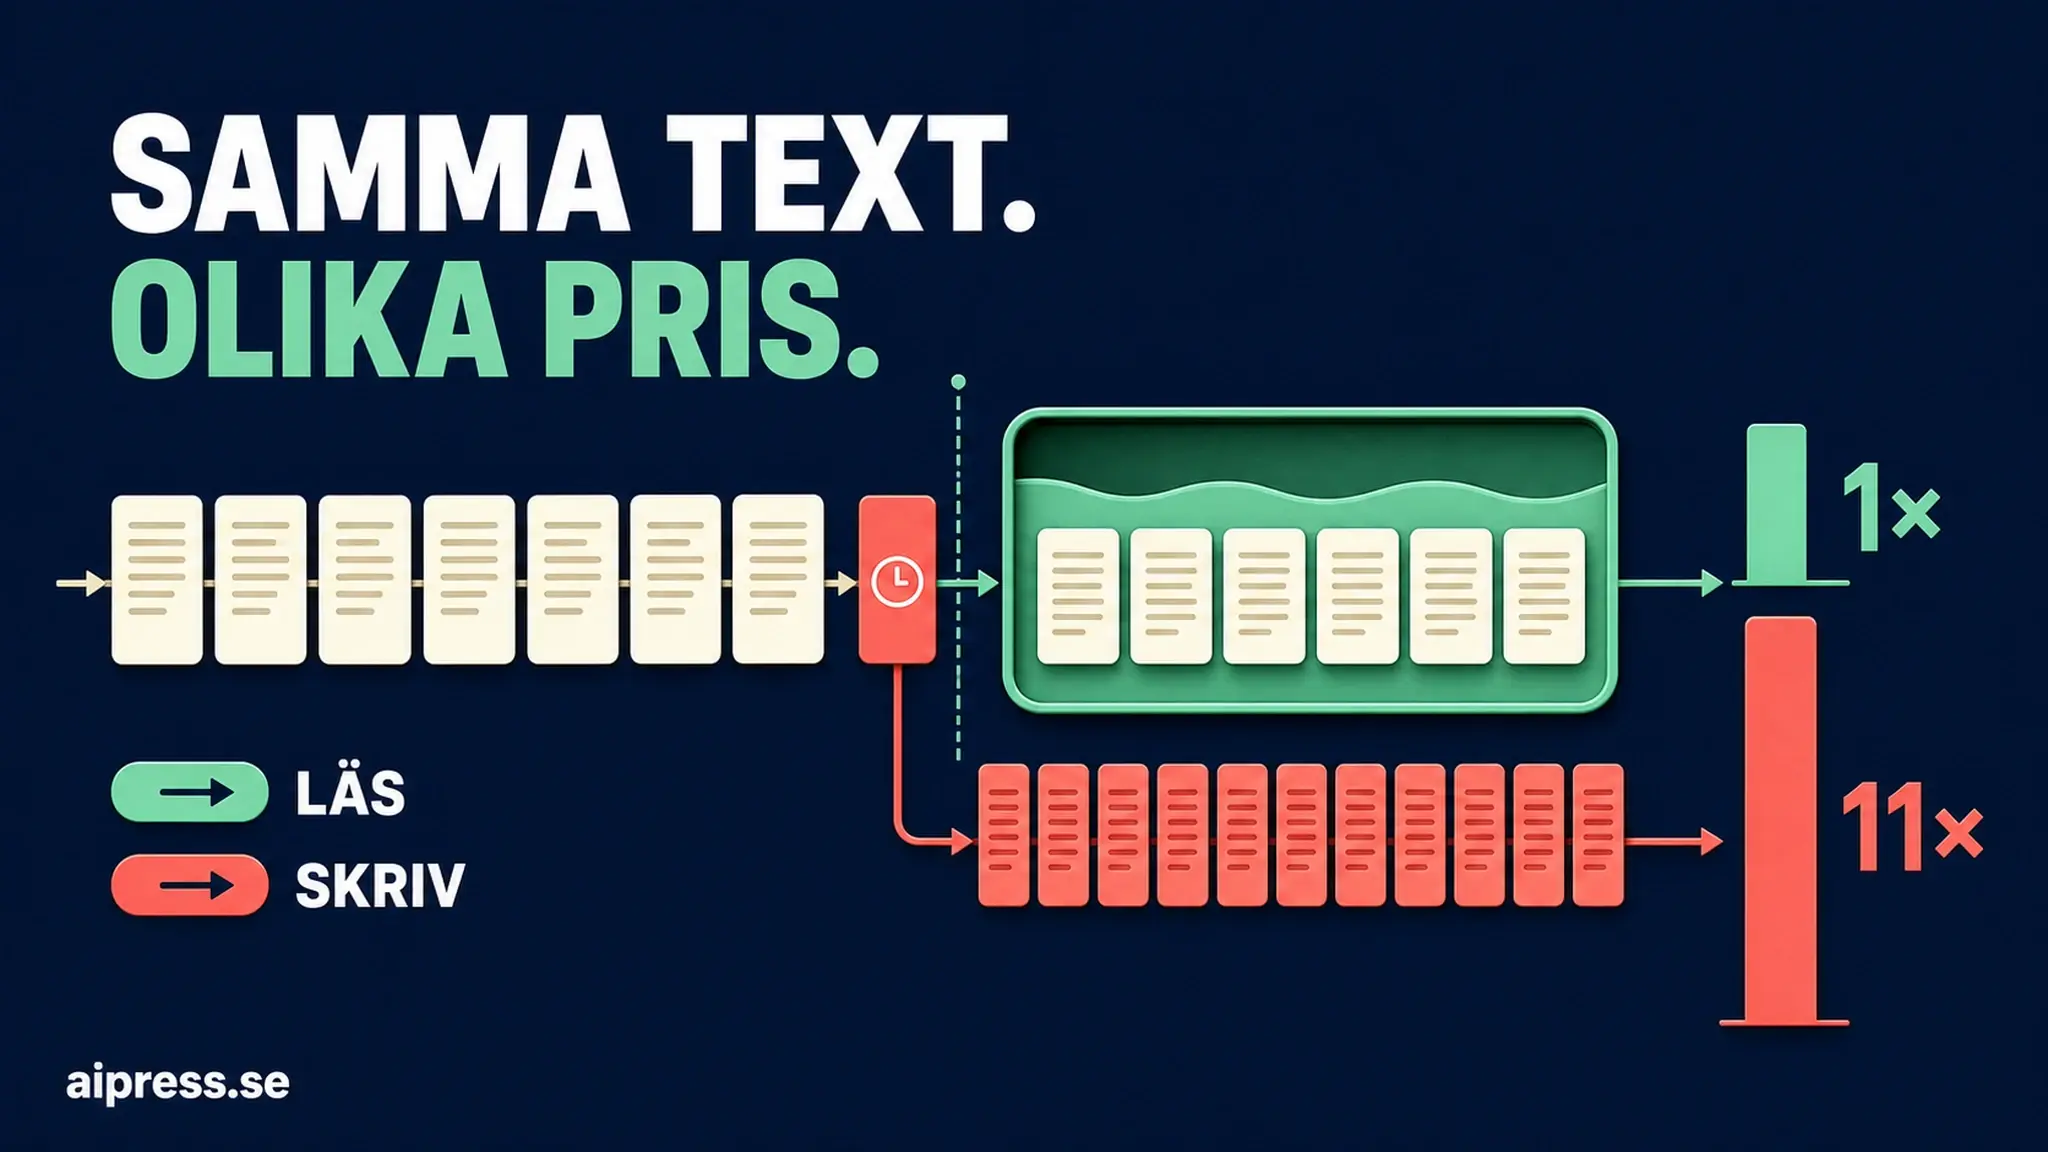
En datumrad gjorde anropen elva gånger dyrare
Resultatet visar varför den nya panelen behövs.
| Upplägg | Kostnad för fem anrop | Samma indata utan cache | Skillnad | Kostnad per 1 000 varma anrop |
|---|---|---|---|---|
| Lång instruktion, automatiskt | 0,0169 dollar | 0,0496 dollar | 66 procent lägre | 1,13 dollar |
| Samma med cachenyckel | 0,0169 dollar | 0,0496 dollar | 66 procent lägre | 1,13 dollar |
| Föränderlig datumrad före frågan | 0,0626 dollar | 0,0501 dollar | 25 procent högre | 12,53 dollar |
| Datumrad och explicit cachepunkt | 0,0174 dollar | 0,0501 dollar | 65 procent lägre | 1,22 dollar |
| Kort instruktion under gränsen | 0,0098 dollar | 0,0098 dollar | Ingen skillnad | 2,45 dollar |
Tabellen omfattar bara kostnaden för indata. Svaren utelämnades eftersom utdatakostnaden var jämförbar mellan scenarierna. Beloppen bygger på OpenAI:s standardpris för kort kontext och inkluderar inte eventuella tillägg för exempelvis regional databehandling.
I de två första scenarierna skrevs nästan hela instruktionen till cacheminnet vid det första anropet. De fyra följande anropen läste tillbaka 1 957 token och betalade i huvudsak fullt pris endast för den korta kundfrågan.
Cachenyckeln gjorde ingen mätbar skillnad i vårt lilla test. Det var väntat: fem anrop från samma dator under några sekunder utsätter inte systemets dirigering för någon större belastning. Vid högre trafik ska nyckeln göra matchningen mer tillförlitlig, så vi skulle ändå använda den i en riktig tjänst.
Varför gav datumraden fem nya cacheskrivningar?
Det tredje scenariot skilde sig bara genom en rad med aktuellt datum och klockslag mellan instruktionen och kundfrågan. Tidsuppgiften förändrades inför varje anrop.
Eftersom GPT-5.6 normalt sätter sin automatiska cachepunkt vid det senaste användarmeddelandet försökte systemet även cacha den föränderliga raden. Ingen av de fem förfrågningarna kunde återanvända en tidigare kopia. I stället skrevs omkring 2 000 nya token till cacheminnet varje gång.
Resultatet blev noll cacheläsningar och fem cacheskrivningar till 1,25 gånger ordinarie pris. Scenario 3 kostade därmed 25 procent mer än om texten inte hade cachats alls. Efter uppvärmningen blev kostnaden drygt elva gånger så hög som i det bäst fungerande upplägget.
API:t gav inget felmeddelande. Problemet syntes bara i användningsuppgifterna: cached_tokens låg kvar på noll samtidigt som cache_write_tokens fylldes på vid varje anrop.
Just det mönstret är nu enkelt att upptäcka i den nya panelen. En stor andel cacheskrivningar i kombination med få läsningar tyder på att någon föränderlig uppgift ligger före cachepunkten.
Den explicita cachepunkten stoppade de onödiga skrivningarna
I det fjärde scenariot behöll vi datumraden på samma plats men satte en explicit cachepunkt efter den stabila instruktionen. Datumet och kundfrågan låg alltså efter det innehåll som skulle återanvändas.
I Responses API markeras den sista stabila textdelen med:
"prompt_cache_breakpoint": {
  "mode": "explicit"
}
På själva anropet använde vi dessutom:
"prompt_cache_options": {
  "mode": "explicit"
}
Den första förfrågningen skrev 1 957 token till cacheminnet. Varje senare förfrågan läste samma 1 957 token utan att skriva någon ny kopia. Datumraden behandlades som vanlig, kort indata.
OpenAI rekommenderar samma åtgärd i sin guide om promptcachning. Om en tidsstämpel, användaruppgift eller annan föränderlig text orsakar upprepade skrivningar bör cachepunkten flyttas till slutet av den stabila delen.
Kan en kortare instruktion ändå kosta mer?
Den förkortade instruktionen i vårt femte scenario låg på omkring 490 token. Den var för kort för att skrivas till cacheminnet, så både läs- och skrivräknaren stannade på noll. Något meddelande om detta visades inte.
En kort instruktion är billig per enskilt anrop. Vid upprepad användning kan en längre, väl cachad instruktion ändå kosta mindre. I vårt test kostade den korta instruktionen cirka 2,45 dollar per 1 000 anrop, medan den ungefär fyra gånger längre instruktionen kostade omkring 1,13 dollar när cacheminnet var varmt.
Att korta en prompt kan alltså sänka kostnaden, men resultatet blir det motsatta om förändringen gör att man går miste om en större cacherabatt.
Prompt Caching-panelen samlar användningsuppgifterna på ett ställe
Varje svar från Responses API innehåller ett usage-block. Där visar usage.input_tokens_details.cached_tokens hur många token som lästes från cacheminnet och cache_write_tokens hur många som skrevs. I Chat Completions API ligger motsvarande uppgifter under usage.prompt_tokens_details.
Tidigare behövde utvecklaren spara dessa värden från varje enskilt svar och själv räkna ihop dem. I API-changeloggen den 20 augusti beskriver OpenAI den nya panelen som ett sätt att följa träffgraden över tid, se cacheläsningar per skrivning och skilja mellan lästa, skrivna och vanliga indatatoken.
När vi öppnade fliken några minuter efter testet fanns anropen redan med.
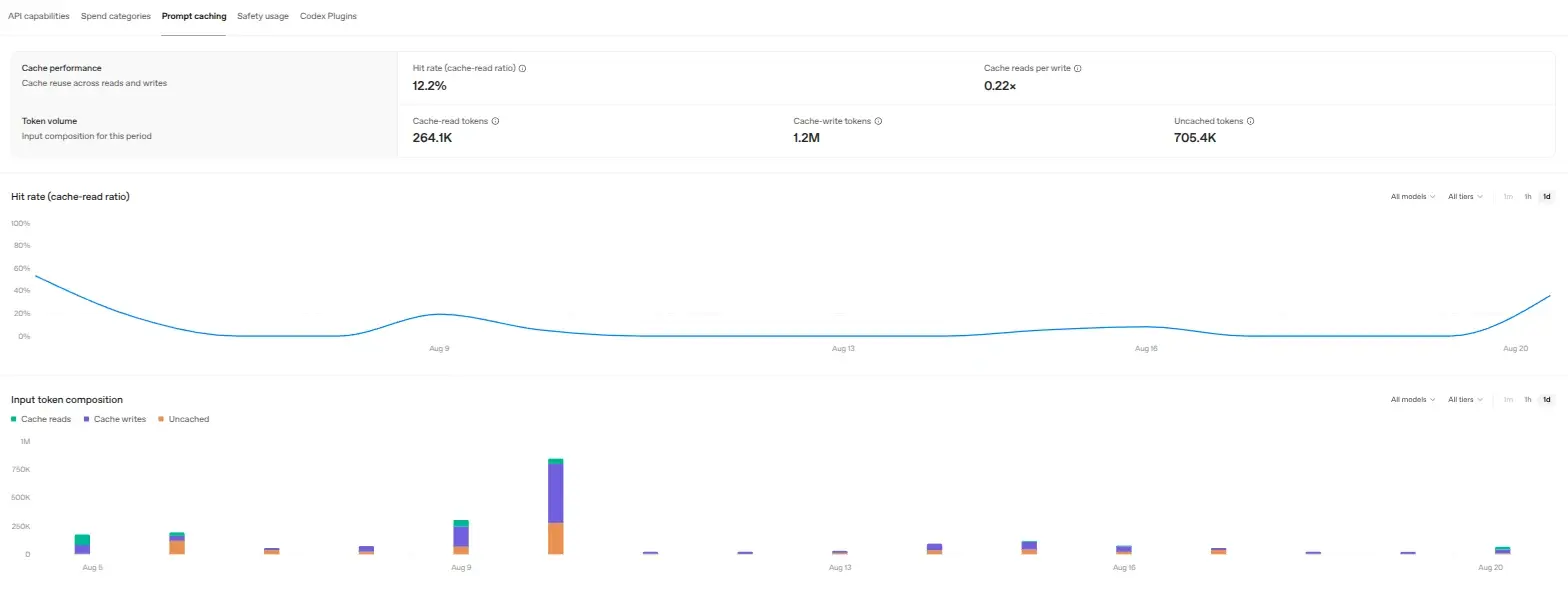
För perioden 5 till 20 augusti visade vår organisation:
- 12,2 procents träffgrad
- 0,22 cacheläsningar per skrivning
- 264 100 lästa cachetoken
- omkring 1,2 miljoner skrivna cachetoken
- 705 400 token utan cache
Det är ett svagt resultat, men också rimligt för vår användning. Många av våra API-anrop gäller enstaka skriv- och testuppgifter där en lång instruktion inte hinner användas igen inom 30 minuter.
Den 20 augusti, då testet kördes, såg siffrorna bättre ut: 35,8 procents träffgrad och 0,7 läsningar per skrivning. Panelen registrerade 23 500 lästa cachetoken, vilket stämmer med våra sparade API-svar efter avrundning. Tolv varma testanrop läste sammanlagt 23 484 token.
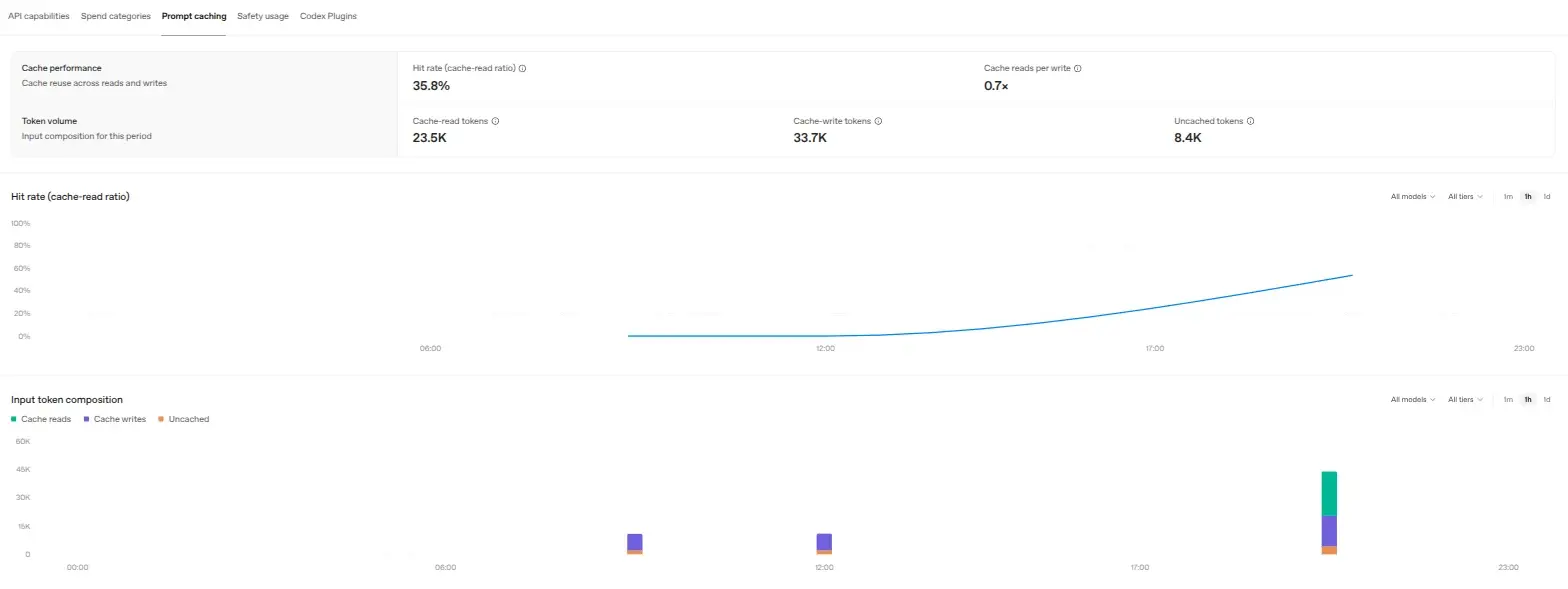
Diagrammet kunde visas per minut, timme eller dag och filtreras efter modell och tjänstenivå. Tiderna angavs i UTC, vilket innebar att testet som kördes omkring klockan 22.30 svensk sommartid syntes under klockan 20 i diagrammet.
När börjar cachningen löna sig?
För GPT-5.6 kostar en cacheskrivning 25 procent mer än vanlig indata, medan en cacheläsning ger 90 procents rabatt. Den matematiska brytpunkten ligger därför vid ungefär 0,28 lästa token per skriven token, förutsatt att samma grundpris gäller för båda.
Värdet i panelen behöver alltså inte nå 1 för att cachningen ska löna sig. En läsning kan mer än väl betala merkostnaden för flera skrivningar. Under cirka 0,28 blir cachningen däremot en nettokostnad.
Vår kvot på 0,22 under perioden 5 till 20 augusti innebar att promptcachningen kostade omkring 2 till 3,5 procent mer än vanlig behandling skulle ha gjort. OpenAI avrundar antalet skrivna token i panelen, så en exakt procentsats går inte att räkna fram från översikten.
Under själva testdagen sparade vi däremot omkring 19 procent. I de tre välbyggda testscenarierna blev besparingen 66 procent när även det första, kalla anropet räknades med. Från och med det andra anropet låg den på omkring 88 procent.
Scenario 3, med datumraden på fel sida om cachepunkten, gav i stället en förlust på 25 procent. När kostnaden för samtliga fem scenarier räknades ihop blev besparingen 41 procent. Det enda felbyggda scenariot åt upp mer än hälften av vad de övriga fyra scenarierna sparade.
Claude använder samma princip med andra gränser
Anthropic erbjuder motsvarande funktion för Claude API. Där kan utvecklaren lägga cache_control på hela anropet för automatisk hantering eller markera enskilda innehållsblock med explicita cachepunkter.
Den normala lagringstiden är fem minuter. En skrivning kostar 1,25 gånger grundpriset och en träff en tiondel. Det finns även ett entimmesalternativ där skrivningen kostar dubbelt så mycket som vanlig indata.
Minimilängden är 1 024 token för Claude Opus 4.8, Sonnet 5 och Sonnet 4.6. För Claude Haiku 4.5 och Opus 4.6 krävs minst 4 096 token. I API-svaret redovisas läsningar i cache_read_input_tokens och skrivningar i cache_creation_input_tokens.
Även hos Anthropic kan en tidsstämpel före cachepunkten orsaka nya skrivningar utan efterföljande träffar. Gemensamma instruktioner bör därför ligga först och föränderligt innehåll efter den markerade gränsen.
Vårt omdöme
OpenAI:s nya panel gör ett tidigare svåröverskådligt kostnadsproblem synligt. I en tjänst som skickar samma långa instruktion många gånger kan promptcachning minska indatakostnaden med närmare 90 procent när cacheminnet väl är varmt.
Samma funktion kan också höja kostnaden utan att ge något felmeddelande. I vårt test räckte en föränderlig datumrad på fel plats för att göra anropen dyrare än vanlig behandling och omkring elva gånger dyrare än det bästa upplägget.
Den mest användbara siffran i panelen är förhållandet mellan lästa och skrivna cachetoken. Ligger det under ungefär 0,28 på GPT-5.6 kostar skrivningarna mer än läsningarna sparar. Kontrollera då om datum, kunduppgifter, verktygsresultat eller andra föränderliga delar ligger före cachepunkten. Flytta dem till slutet, markera var den stabila texten upphör och jämför statistiken igen.
Så genomförde vi testet
Testet kördes den 20 augusti 2026 från en dator i Sverige med OpenAI Responses API och modellen GPT-5.6 Sol. Vi använde låg resoneringsnivå, satte store till av och begränsade svaret till 64 token. Mellan anropen väntade vi tre sekunder.
Scenarierna fick separata inledningar så att de inte kunde använda varandras cache. Cachenycklar användes i de scenarier där de ingick i upplägget. Vi sparade instruktionen, testskriptet och samtliga usage-block.
Två av 30 anrop i scenariot med den korta instruktionen gav tomma svar och användningsvärden på noll. Modellens interna resonemang hade då förbrukat gränsen på 64 utdatatoken innan något synligt svar hann skrivas. Vi körde om det scenariot och tog bort de två misslyckade anropen ur tabellerna. Därför bygger resultatet för den korta instruktionen på fyra giltiga förfrågningar.
Kostnaderna är beräknade från sparade användningsvärden och OpenAI:s priser den 20 augusti 2026, inte från en avrundad fakturaöversikt. Vi testade inte GPT-5.5 eller äldre modeller, som har andra cacheregler och ingen separat avgift för cacheskrivningar.
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.