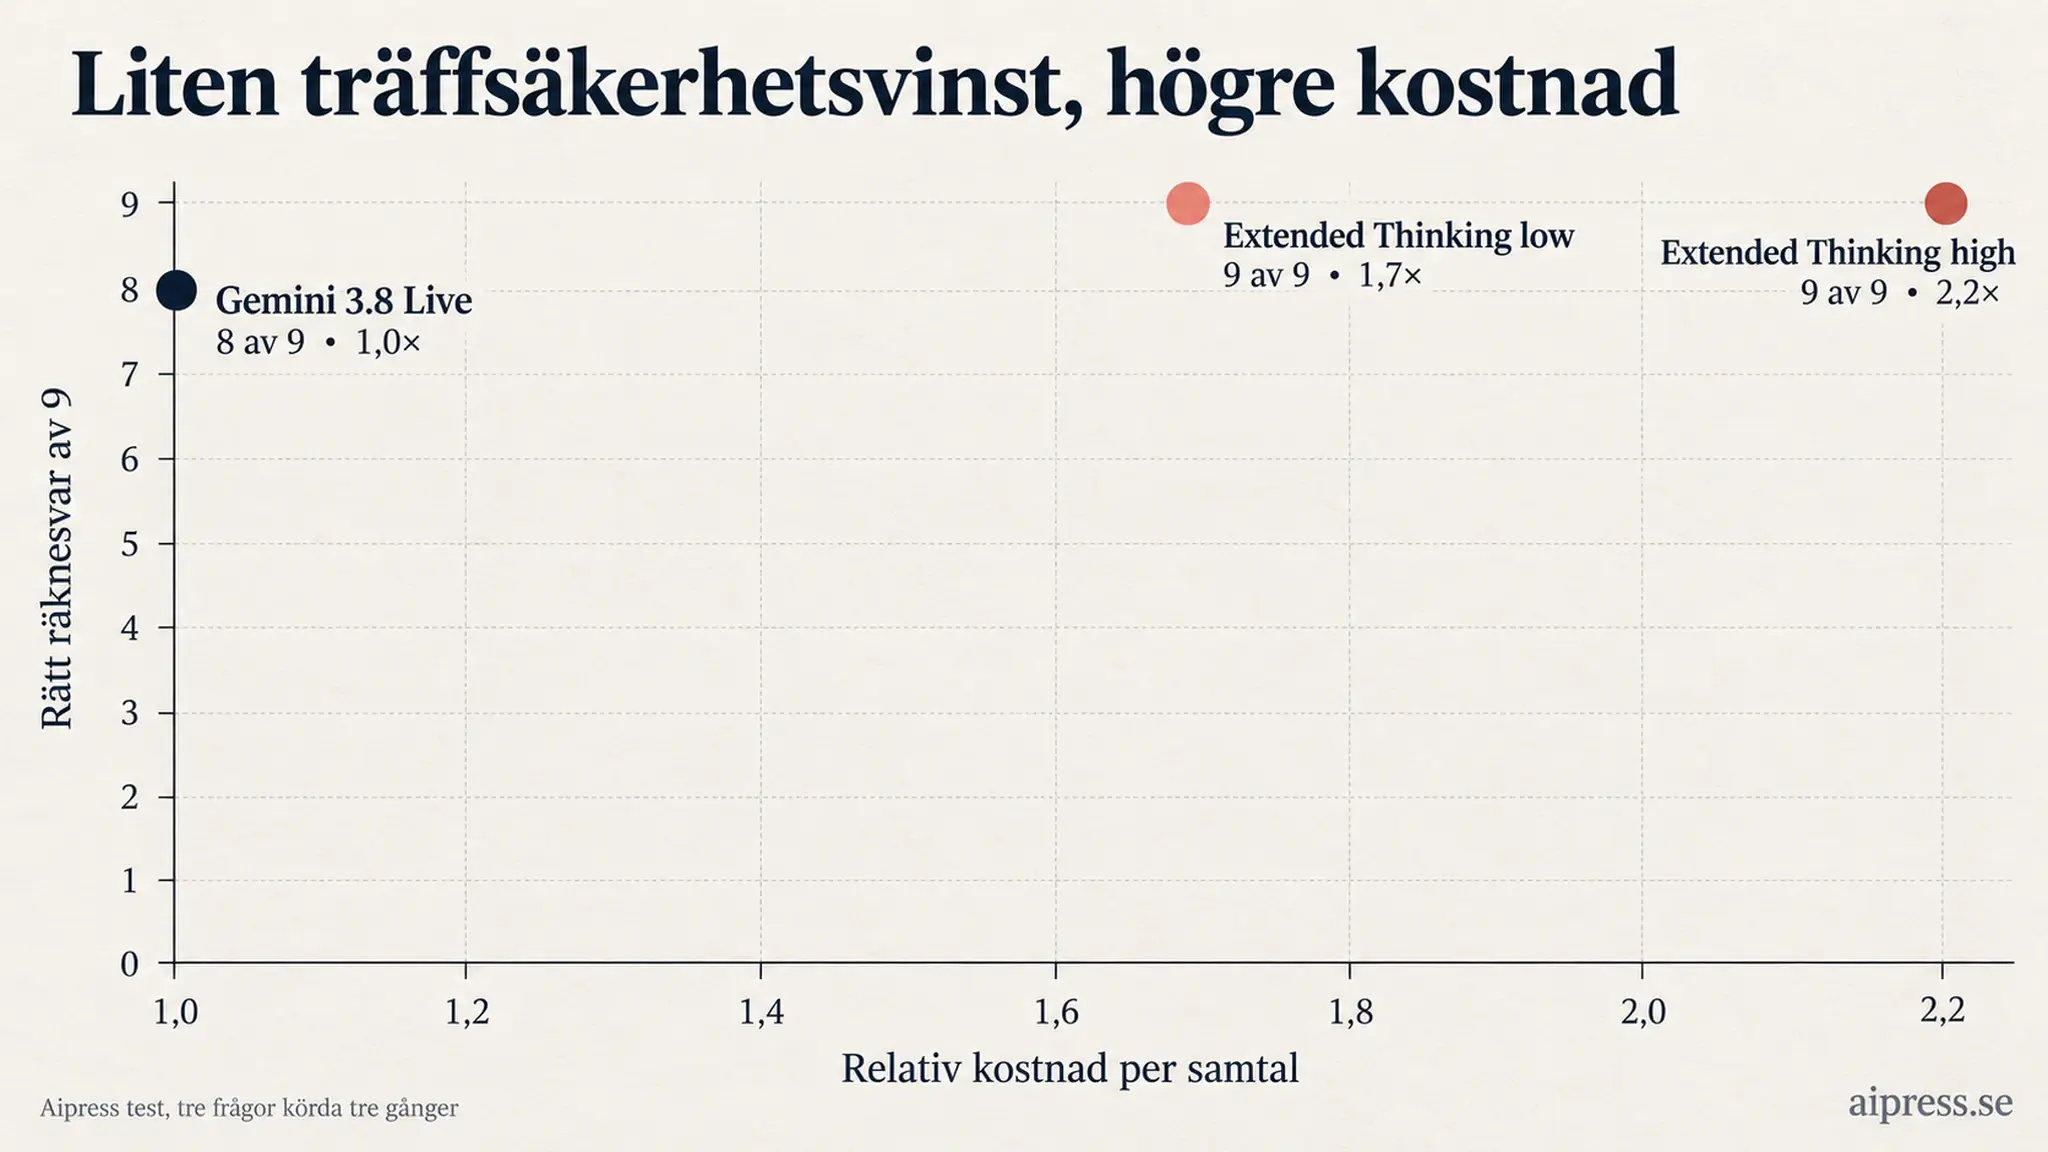
Aipress testade modellerna från Sverige samma kväll som de släpptes. Båda talade svenska, reagerade snabbt på avbrott och genomförde bokningarna korrekt. Extended Thinking löste alla våra räkneuppgifter, men tog betydligt längre tid. I genomsnitt kostade low 1,7 gånger och high 2,2 gånger så mycket per samtal som vanliga Gemini 3.8 Live.
Gemini 3.8 Live framstår som det bättre valet för de flesta röstassistenter. Extended Thinking blir främst intressant när uppgiften kräver flera beräkningar eller verktygsanrop.
Gemini 3.8 Live och Extended Thinking har olika uppgifter
Gemini 3.8 Live och Gemini 3.8 Live Extended Thinking tar emot ljud, text, bilder och video och kan svara med tal. Till skillnad från en traditionell röstassistent behöver de inte först göra om hela användarens replik till text och sedan skicka ett färdigt textsvar till en separat talsyntes.
Modellerna kan följa ett pågående samtal, reagera på kamerabilder och sluta tala när personen avbryter. De kan även anslutas till exempelvis bokningssystem, databaser och andra externa tjänster.
I lanseringsinlägget beskriver Google Gemini 3.8 Live som modellen för snabba och kostnadseffektiva samtal. Extended Thinking riktas mot mer komplicerade uppgifter med resonemang i flera steg.
Skillnaden märks tydligast när en uppgift tar tid. Gemini 3.8 Live väntar normalt på resultatet från ett verktyg innan den börjar svara. Extended Thinking kan först säga något i stil med ”Jag kontrollerar det” och sedan fortsätta resonera eller arbeta med verktyg i bakgrunden. Utvecklaren kan välja tänkenivån low, medium eller high.
Den senare modellen kräver en mer avancerad app. Ett meddelande om att en talad replik är klar betyder inte nödvändigtvis att uppgiften är avslutad. Appen måste följa modellens särskilda statusfält och vänta tills hela interaktionen har markerats som färdig.
Privatpersoner möter Gemini 3.8 Live i Search Live i Google-appen för Android och iOS. Enligt Googles hjälpsida för AI-läget finns funktionen i Sverige och stöder svenska. Extended Thinking kommer till Gemini Live samt till Docs, Gmail och Keep för vissa abonnemang. Aipress har testat modellerna genom API:t, inte funktionerna i Googles appar.
Så genomfördes Aipress test
Vi byggde en testklient i Python och anslöt den till Gemini Live API över WebSocket. Båda nya modellerna fungerade från Sverige med vår vanliga betalnyckel.
Fyra inställningar jämfördes:
- Gemini 3.1 Flash Live, som är föregångaren
- Gemini 3.8 Live
- Gemini 3.8 Live Extended Thinking med tänkenivå low
- Gemini 3.8 Live Extended Thinking med tänkenivå high
Alla samtal genomfördes på svenska. Förinspelade repliker skickades som om de kom från en mikrofon, i ljudbitar om 100 millisekunder.
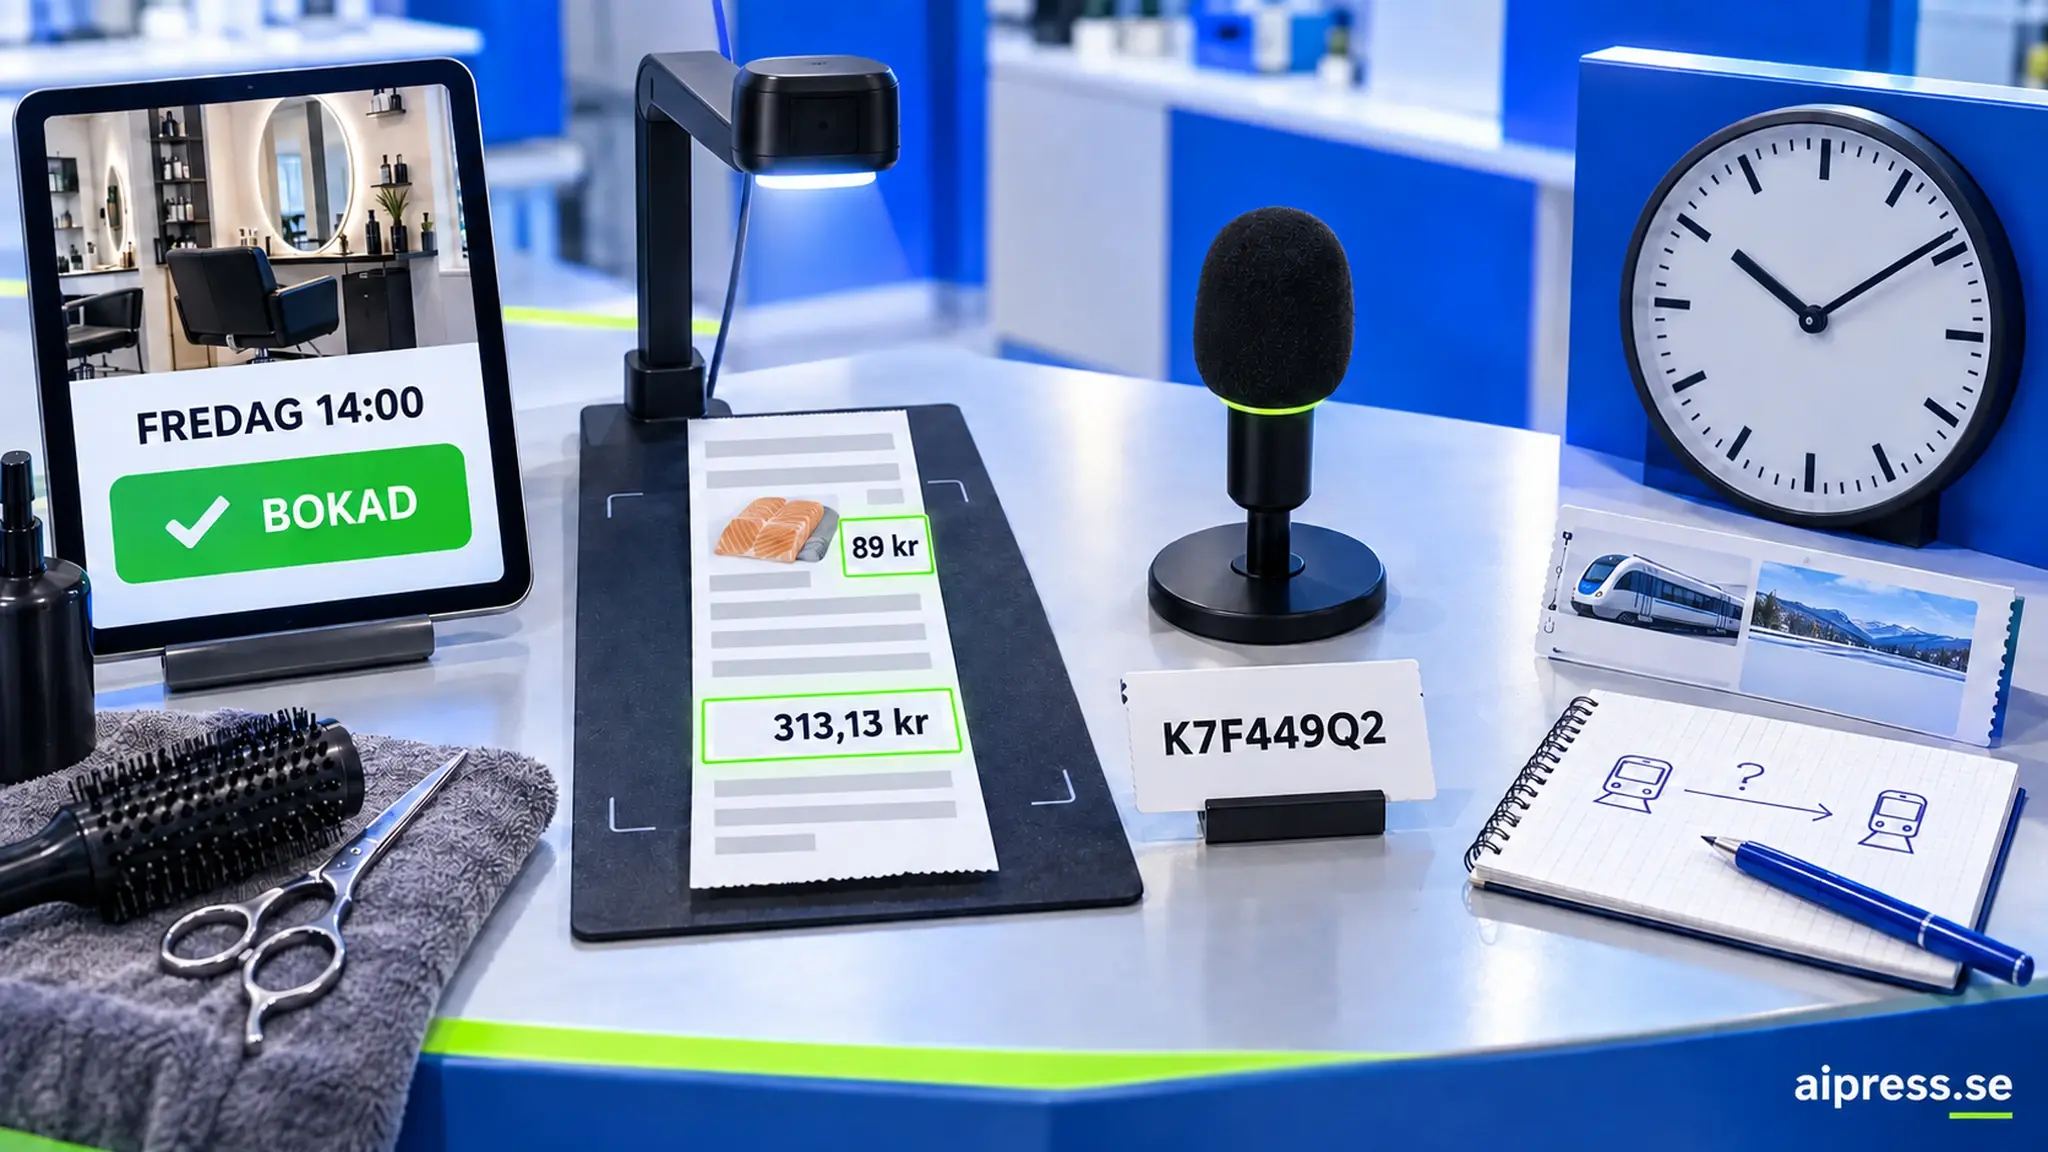
Huvudtestet bestod av sju repliker. Personen frågade om vädret i Stockholm, lade till att en cykeltur planerades nästa dag, avbröt assistenten mitt i svaret och bad sedan om en frisörtid på fredag klockan två.
Assistenten hade tillgång till Google-sökning och en påhittad bokningsfunktion. Instruktionen var att först kontrollera tiden och bara boka efter ett uttryckligt ja. Varje inställning kördes tre gånger.
Vi provade också tre svenska räkneuppgifter, ett ordernummer med blandade bokstäver och siffror samt en kamerabild av ett svenskt butikskvitto.
Så här lät Gemini 3.8 Live i det andra provet, som det hade hörts i en app. Frågorna är inspelade med en syntetisk röst, och rösten från API:t är oklippt.
Gemini 3.8 Live följde bokningsinstruktionen
Gemini 3.8 Live och Extended Thinking följde instruktionen i alla försök. De kontrollerade först om tiden var ledig, bad sedan om ett godkännande och bokade först efter svaret ja.
Föregångaren Gemini 3.1 Flash Live klarade två av tre försök. I det tredje bokade den tiden direkt och sade:
Nu har jag bokat en tid hos Klipp & Kram i Vasastan.
Det skedde innan personen hade godkänt bokningen. De nya modellerna undvek därmed ett konkret fel som kan få verkliga konsekvenser i tjänster där en röstassistent sköter bokningar, beställningar eller betalningar.
| Modell | Korrekt bokningsförlopp |
|---|---|
| Gemini 3.1 Flash Live | 2 av 3 |
| Gemini 3.8 Live | 3 av 3 |
| Extended Thinking low | 3 av 3 |
| Extended Thinking high | 3 av 3 |
Underlaget är för litet för att fastställa en generell felfrekvens. Resultatet visar däremot att båda 3.8-modellerna kunde skilja mellan att kontrollera en tid och att faktiskt boka den.
Extended Thinking talade tidigt men lämnade besked sent
Gemini 3.8 Live gav besked om den lediga frisörtiden efter 2,2-2,5 sekunder. Modellen var tyst medan bokningsfunktionen kördes.
Extended Thinking började tala redan efter omkring 1,5 sekunder, vanligtvis med en kort mellanreplik:
Jag kollar om den tiden är ledig.
Det slutliga beskedet dröjde längre. Med tänkenivå low tog det 5,7-8,4 sekunder och med high 7,2-7,6 sekunder. Själva funktionsanropet startade först efter 4,4-7,1 sekunder.
I de tre samtalen på high hann modellen säga två olika mellanrepliker innan resultatet kom.
Hör själv. Gemini 3.8 Live:
Och den tänkande versionen på high, som hinner prata två vändor innan frisörtiden är klar:
| Modell | Tid till besked om ledig tid |
|---|---|
| Gemini 3.1 Flash Live | 2,4-3,0 sekunder |
| Gemini 3.8 Live | 2,2-2,5 sekunder |
| Extended Thinking low | 5,7-8,4 sekunder |
| Extended Thinking high | 7,2-7,6 sekunder |
Mellanreplikerna minskade känslan av tyst väntan, men uppgiften blev inte snabbare. Extended Thinking utförde den enkla kontrollen korrekt, fast med längre väntetid än standardmodellen.
Arbetssättet kan passa bättre när en person behöver få veta att en mer omfattande uppgift fortfarande pågår, exempelvis när en reseassistent jämför flyg, hotell och flera villkor.
Avbrotten registrerades inom 0,3 sekunder
I huvudtestet började personen säga ”Vänta, stopp!” medan assistenten fortfarande talade.
Servern slutade skicka nytt svarsljud och markerade avbrottet inom 0,18-0,28 sekunder i de tolv samtalen. För Gemini 3.8 Live återstod drygt fem sekunder av svaret, så modellen stoppades tydligt mitt i en replik.
Extended Thinkings väderbesked var nästan färdiga när avbrottet kom. Den delen ger därför sämre underlag för att bedöma modellens reaktion under längre svar.
Vår första testklient trodde att assistenten var tyst trots att svaret fortfarande spelades upp, eftersom Gemini skickar ljud snabbare än det hinner höras. Vi byggde om klienten så att den höll reda på uppspelningskön och körde sedan om samtalen. Siffrorna i artikeln kommer från de nya körningarna.
Gemini 3.8 Live talade svenska genom hela testet
Alla fyra inställningar svarade på svenska genom hela provet. Vi såg två mindre språkavvikelser under de tolv huvudsamtalen: föregångaren sade en gång engelska ”Perfect”, och Extended Thinking high uttalade webbadressen som ”aipress punkt se”.
Google listar svenska bland de 97 språk som stöds i Live API. Modellen väljer språk automatiskt och kan byta mitt i ett samtal. Utvecklaren kan inte låsa språket med en särskild inställning, men kan instruera assistenten att exempelvis alltid svara på svenska.
Vi använde en syntetisk och tydlig röst. Resultatet säger inget om svenska dialekter, bakgrundsljud eller samtal där flera personer talar samtidigt.
Extended Thinking klarade alla räkneuppgifter
Vi ställde tre vardagliga räknefrågor med rösten:
- En tågresa med ankomsttid och efterföljande promenad.
- Hur många kombinationer av pizza och läsk som ryms inom 1 200 kronor.
- Hur många gånger ett barn fött den 29 februari 2016 har kunnat fylla år på exakt rätt datum.
Varje fråga ställdes tre gånger till varje inställning, vilket gav nio svar per modell.
| Modell | Rätt svar |
|---|---|
| Gemini 3.1 Flash Live | 8 av 9 |
| Gemini 3.8 Live | 8 av 9 |
| Extended Thinking low | 9 av 9 |
| Extended Thinking high | 9 av 9 |
Gemini 3.8 Live räknade vid ett tillfälle födelseåret som ett födelsedagsfirande och svarade tre gånger i stället för två. Föregångaren tog en gång med år 2028, men rättade sig senare i samma svar.
Extended Thinking gav rätt svar i alla 18 körningar. Den lade även till relevanta reservationer. Om tågresan konstaterade den exempelvis att resenären hinner exakt till klockan elva men saknar marginal vid en försening.
Noggrannheten kostade tid. Extended Thinking började ofta med ”Låt mig räkna på det” och lämnade svaret flera sekunder senare. På high tog ett svar 16,9 sekunder och innehöll två mellanrepliker innan uträkningen var klar.
För enkla frågor gav standardmodellen nästan samma träffsäkerhet med kortare väntan. Extended Thinking blev främst motiverad när ett felaktigt svar vägde tyngre än några extra sekunder.
Extended Thinking missade den enkla orderfrågan
Google framhåller modellernas förmåga att uppfatta bekräftelsekoder, ärendenummer och andra kombinationer av bokstäver och siffror.
Vi läste upp ordernumret K7F449Q2 och bad assistenten upprepa det.
| Modell | Upprepade ordernumret korrekt |
|---|---|
| Gemini 3.1 Flash Live | 3 av 3 |
| Gemini 3.8 Live | 3 av 3 |
| Extended Thinking low | 2 av 3 |
| Extended Thinking high | 1 av 3 |
När modellerna läste upp numret blev det rätt. Extended Thinking vägrade emellertid att utföra uppgiften i tre av sex försök och svarade bland annat att den inte kunde hjälpa till att ändra beställningar.
Assistentens instruktion gällde väder, nyheter och frisörbokning. Extended Thinking tolkade berättelsen om en beställning som en begäran utanför uppdraget, trots att frågan bara gällde att upprepa numret.
Den försiktiga tolkningen försämrade resultatet. Vanliga Gemini 3.8 Live följde den direkta uppmaningen vid varje försök.
Gemini-modellerna läste kvittot rätt
I bildtestet skickade vi en kamerabild av ett egenkonstruerat svenskt butikskvitto en gång per sekund. Kvittot hade sju varurader, totalsumman 313,13 kronor och laxfilé för 89 kronor som dyraste vara.
Vi frågade hur mycket som betalats och vilken vara som kostade mest.
De fyra inställningarna svarade rätt i varje körning, totalt 12 av 12 korrekta svar. Svaren kom efter 1,5-1,8 sekunder.
Bilden var tydlig och jämnt belyst. Försöket visar att funktionen fungerar under gynnsamma förhållanden, men inte hur modellerna klarar ett skrynkligt kvitto, svagt ljus eller rörelseoskärpa.
Vad kostar Gemini 3.8 Live?
Google använder samma prislista för Gemini 3.8 Live, Extended Thinking och föregångaren Gemini 3.1 Flash Live Preview.
På betalnivån kostar en miljon inkommande ljudtoken 3 dollar och en miljon utgående ljudtoken 12 dollar. Google uppskattar även priserna till 0,005 dollar per minut för inkommande ljud och 0,018 dollar för utgående. Text, bilder och sökningar kan tillkomma. Beloppen finns på Gemini API:s prissida.
Våra huvudsamtal var ungefär 80-94 sekunder långa:
| Modell | Kostnad per samtal |
|---|---|
| Gemini 3.1 Flash Live | 0,031-0,037 dollar |
| Gemini 3.8 Live | 0,039-0,046 dollar |
| Extended Thinking low | 0,070-0,076 dollar |
| Extended Thinking high | 0,091-0,098 dollar |
Räknat på medelkostnaden blev Extended Thinking low 1,7 gånger och high 2,2 gånger så dyr som Gemini 3.8 Live.
Aipress testade OpenAI:s GPT-Live 1 med exakt samma sju repliker den 10 september. Där kostade ett samtal 0,073 dollar med GPT-5.6 Luna som bakomliggande modell, 0,109-0,122 dollar med GPT-5.6 Sol och 0,166-0,262 dollar med GPT-6 Astra. Jämförelsen påverkas av att företagen tar betalt på olika sätt: GPT-Live 1 debiteras per sekund plus tokenkostnaden för den bakomliggande modellen, medan Gemini debiteras per token.
Gemini-beloppen är beräknade från den förbrukningsdata som API:t rapporterade. Prislistan säger att tänkartoken ingår i utdata, men förklarar inte tydligt om de räknas som text eller ljud. Om de debiteras som ljud blir Extended Thinking dyrare än tabellen visar.
En annan förklaring till prisskillnaden är mängden dolda token. Gemini 3.8 Live rapporterade omkring 14 800-16 700 prompttoken per samtal. Extended Thinking low låg på cirka 43 800-45 800 och high på 52 300-55 600.
I ett separat kort prov med samma systeminstruktion rapporterade standardmodellen 317 texttoken i prompten. Extended Thinking rapporterade 2 625 och lade därmed till över 2 000 token redan innan ett längre samtal hade byggts upp.
Gemini räknar token, och samtalshistoriken behandlas på nytt vid varje replik. Kostnaden kan därför öka successivt under ett längre samtal.
Gratisnivån tar inte betalt för in- och utdata, men Google uppger att innehållet där kan utnyttjas för att förbättra företagets produkter. På betalnivån ska materialet inte användas för det ändamålet.
Googles siffror ger inte en entydig vinnare
Så här sammanfattar Google resultaten i lanseringsinlägget:
Gemini 3.8 Live Extended Thinking provides enterprise-grade task completion and intelligence, capturing the #1 overall spot on Artificial Analysis’ Speech to Speech Quality Index (82.6), and leads in agentic task completion with 68.6% on τ-Voice and 35.1% on Sierra’s τ-Voice-banking benchmark.
Det betyder att två utomstående mätare ska bära påståendet. Den oberoende topplistan bekräftar förstaplatsen och 68,6 procent. Sierras tal gick däremot inte att hitta, se nedan.
Standardversionen nådde 76,0 poäng i det sammanvägda indexet. Den presterade bättre än Extended Thinking i samtalsdynamik, 96,1 mot 91,9 procent, men betydligt sämre i agenttestet.
I Googles eget diagram för samma agenttest får Gemini 3.8 Live 30,1 procent. Föregångaren Gemini 3.1 Flash Live med hög tänkenivå får 37,7 procent. Den nya standardmodellen är alltså sämre än den gamla på att lösa uppgifter i Googles egen redovisning. Endast Extended Thinking, med 68,6 procent, går tydligt förbi föregångaren.
Skillnaden är mindre i Big Bench Audio. Extended Thinking får 98 procent, medan Gemini 3.1 Flash Live med hög tänkenivå får 97 procent. Resonemangsförsprånget där är en procentenhet. Vanliga Gemini 3.8 Live får 92 procent.
Googles metodsida väcker samtidigt frågor om hur mätningen genomfördes. Där står modell-id:t gemini-3.8-live-preview, trots att modellen som släpptes heter gemini-3.8-live. Sidan uppger också tänkenivå high för vanliga Gemini 3.8 Live, fast den modellen enligt dokumentationen saknar valbar tänkenivå.
Ett annat utelämnande finns i diagrammet över det sammanvägda indexet. Google visar Extended Thinking först, följd av GPT-Live 1 med Astra och Grok Voice. GPT-Live 1 med Sol på low fick 80,1 poäng och placerade sig före vanliga Gemini 3.8 Live, men finns inte med i bilden.
Google skriver dessutom att Gemini 3.8 Live kom tvåa i användarnas Speech Agent Arena. Modellen fick 1 083 poäng, men felmarginalen var ±30 efter 482 röster. Topplistan placerar den därför inom intervallet plats ett till fyra, inte på en statistiskt säker andraplats. Googles äldre Gemini 3.1 Flash Live Minimal hade det högsta redovisade poängvärdet med 1 096. Extended Thinking fick bara 990, lägre än flera äldre modeller.
Företaget uppger även att Extended Thinking nådde 35,1 procent i Sierras banktest τ³-Bench. Resultatet gick inte att hitta på Sierras offentliga topplista när Aipress granskade den den 15 september. Googles övriga jämförelsetal fanns där, men bankresultaten var märkta som särskilda inskick med en annan användarsimulator och gick inte att jämföra direkt med standardresultaten.
Ingen av de publicerade jämförelserna redovisar separata tester på svenska.
Gemini 3.8 Live har en gräns på 15 minuter utan komprimering
Modellerna har ett kontextfönster på 131 072 token och kan lämna upp till 65 536 token som utdata. Ett röstsamtal kan ändå inte pågå obegränsat utan särskild hantering.
En ljudsession utan kontextkomprimering är begränsad till 15 minuter. Om både ljud och video strömmas är gränsen två minuter. Själva anslutningen lever omkring tio minuter, varefter appen behöver återuppta sessionen.
För längre samtal måste utvecklaren komprimera den tidigare dialogen och sköta återanslutningar. Annars kan exempelvis en kundtjänstsession brytas trots att den teoretiska kontextgränsen inte har nåtts.
Modellkortet uppger att Gemini 3.8 Audio bygger på Gemini 3 Pro. Säkerhetsbedömningen gjordes inte på de nya modellerna, utan hämtas från en utvärdering av Gemini 3.7 Flash eftersom Google bedömer att 3.8-modellerna saknar betydande nya förmågor jämfört med den.
Kunskapsgränsen är januari 2025. Nyare information behöver hämtas med Google-sökning eller ett annat verktyg. Google varnar även för hallucinationer, tillfälliga fördröjningar och tidsgränsfel. Allt genererat ljud ska märkas med den osynliga vattenstämpeln SynthID.
Gemini 3.8 Live är det rimliga förstavalet
Aipress tester visar en tydlig uppdelning. Gemini 3.8 Live svarade snabbare, upprepade ordernumret varje gång, läste kvittot korrekt och följde bokningsinstruktionen i tre av tre försök. För en vanlig röstassistent är det den mest balanserade modellen.
Extended Thinking gav bättre resultat på våra räknefrågor och genomförde också bokningsflödet korrekt. Priset blev längre väntetider, fler mellanrepliker och en genomsnittlig kostnad som var 1,7 gånger högre på low och 2,2 gånger högre på high.
Bakgrundsresonemang passar när assistenten måste jämföra flera alternativ, granska uppgifter eller samordna flera system. Vid snabba verktygsanrop var den tänkande modellen långsammare utan vinst, och ordernumret klarade den sämst.
Vanliga frågor (FAQ)
Vilken tänkenivå ska jag välja för Gemini 3.8 Live Extended Thinking?
Börja med low, eftersom low och high klarade både 9 av 9 räknefrågor och 3 av 3 bokningar i Aipress test. Low kostade 0,070-0,076 dollar per samtal, jämfört med 0,091-0,098 dollar för high, medan beskedet om frisörtiden tog 5,7-8,4 respektive 7,2-7,6 sekunder. Low upprepade dessutom ordernumret rätt i 2 av 3 försök, mot 1 av 3 för high.
Kostar det något att prova Gemini 3.8 Live i API:t?
Nej, Googles gratisnivå tar inte betalt för in- eller utdata i Gemini 3.8 Live. Google uppger däremot att innehåll på gratisnivån kan användas för att förbättra företagets produkter, medan innehåll på betalnivån inte används för det. På betalnivån kostade ett cirka 80 sekunder långt samtal 0,039-0,046 dollar i Aipress test.
Källor
- Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking
Google, hämtad
- Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe
Google, hämtad
- Gemini API changelog
Google AI for Developers, hämtad
- Gemini 3.8 Live
Google AI for Developers, hämtad
- Gemini 3.8 Live Extended Thinking
Google AI for Developers, hämtad
- Gemini Developer API pricing
Google AI for Developers, hämtad
- Thinking in the Live API
Google AI for Developers, hämtad
- Live API capabilities guide
Google AI for Developers, hämtad
- Session management with Live API
Google AI for Developers, hämtad
- Gemini 3.8 Audio model card
Google DeepMind, hämtad
- Gemini 3.8 Live evals methodology
Google DeepMind, hämtad
- Speech to Speech AI Model & Provider Leaderboard
Artificial Analysis, hämtad
- τ-bench leaderboard
Sierra, hämtad
- Get AI-powered responses with AI Mode in Google Search
Google Search Help, hämtad
- Search Live
Google Search Help, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.