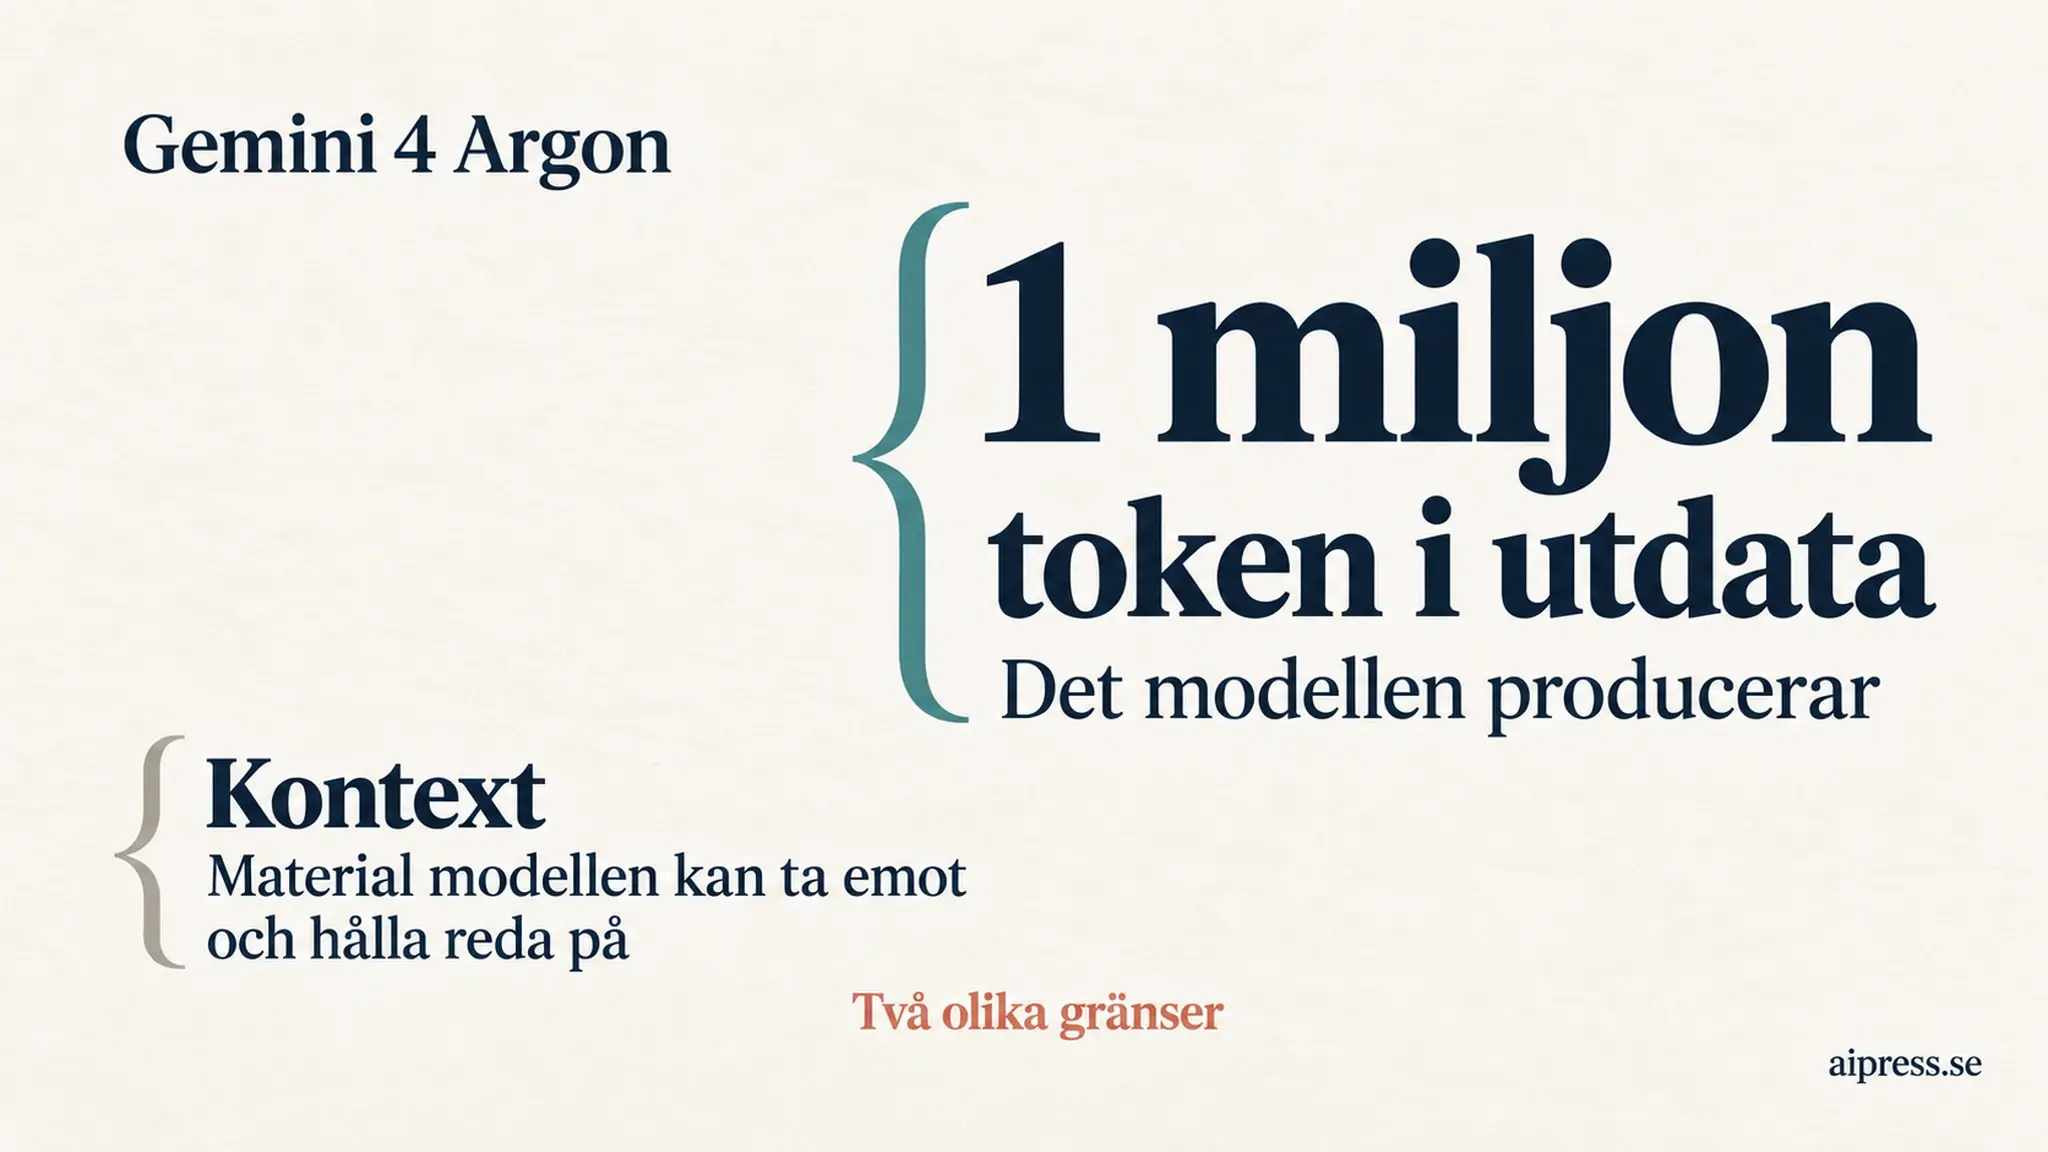
En stor förändring är att gränsen för modellens utdata höjs från 64 000 till en miljon token. Google vill ge Argon utrymme att arbeta igenom långa problem i flera steg. Företaget använder redan modellen internt och redovisar bland annat minskad minnesanvändning i datacenter och omfattande omskrivningar av programkod.
I Googles presentation av Gemini 4 Argon finns företagets lanseringsbesked, användningsexempel och plan för att släppa modellen till fler.
När får man tillgång till Gemini 4 Argon?
Argon börjar distribueras genom Googles Fairwind Program till en grupp betrodda aktörer som arbetar med cybersäkerhet. Google samlar in deras erfarenheter och vidareutvecklar skydden innan modellen blir allmänt tillgänglig. Företaget deltar också i den amerikanska regeringens frivilliga process för tillgång till modeller före bred lansering.
Nästa steg ska börja med betalande API-kunder och abonnenter på Google AI Ultra. Ett API låter utvecklare använda modellen från egna program. Google anger inget datum för när den bredare tillgången öppnar och presenterar ingen öppen provversion i lanseringsmaterialet.
På modellsidan för Gemini samlar Google information om modellen och dess prestanda. Den första tillgången till Argon sker genom det begränsade programmet, så lanseringsbeskedet innebär ännu inte att alla kan prova modellen.
Vad kostar Gemini 4 Argon?
Google anger ett introduktionspris på 2 dollar per miljon token som skickas in och 10 dollar per miljon token som modellen producerar. Token är de textdelar modellen bearbetar, ofta ord eller delar av ord. Priset beror alltså på mängden material och utdata, inte bara på hur många frågor man ställer.
Cachelagrad indata får 95 procents rabatt på inmatningspriset. Det gäller återanvänt material som har sparats för att kunna behandlas igen till lägre kostnad.
Efter introduktionsperioden blir priset 4 dollar per miljon inmatade token och 20 dollar per miljon producerade token. Google anger inte hur länge introduktionspriset gäller. Tokenpriserna gäller användning genom API och ska inte förväxlas med kostnaden för ett abonnemang på Google AI Ultra.
Vad innebär Gemini 4 Argons gräns på en miljon token?
Google höjer gränsen för utdata från tidigare 64 000 till en miljon token. Företaget beskriver det som utrymme för djupare resonemang och för att producera hundratusentals token under ett sammanhängande arbete. Avsikten är att modellen ska kunna lösa svåra problem utan att behöva avsluta för tidigt.
Gränsen för utdata gäller det modellen producerar. Den ska hållas isär från hur mycket material modellen kan ta emot och hålla reda på, vilket brukar kallas dess kontext. En högre gräns för utdata ger större utrymme för långa lösningar, men säger i sig inget om hur korrekta de blir.
Så använder Google Gemini 4 Argon internt
Tusentals anställda har enligt Google använt Argon och lyft fram specialiserad programmering, fördjupad research och skrivkvalitet. De konkreta exemplen gäller framför allt tekniskt arbete där AI-agenter kan pröva lösningar och använda verktyg över många steg.
Inom kvantdatorforskning har Argon hjälpt till att optimera delberäkningar som begränsar större tillämpningar. Google redovisar ett exempel där modellen på några minuter förbättrade en publicerad referenslösning med 40 procent i ett resursmått som kombinerar kvantbitar och beräkningsoperationer. Uppgiften gäller det specifika exemplet, inte en generell förbättring av alla kvantberäkningar.
En grupp Argon-agenter har också analyserat mätdata från Googles datacenter och identifierat och genomfört minnesoptimeringar. Google uppger att införda ändringar har frigjort över 300 TiB minne och uppskattar den sammanlagda möjliga besparingen till mellan 500 TiB och 1 PiB. TiB står för tebibyte och PiB för pebibyte. De är binära mått på datamängd och avser här minneskapacitet, inte modellens kontext.
Argon används dessutom för att flytta kod från C och C++ till Rust, ett språk som kan förebygga vissa typer av minnesfel. Projekten sträcker sig från tiotusentals kodrader i bibliotek som re2 och libgav1 till över 800 000 rader i Fuchsias Zircon-kärna. Google säger att omskrivningarna genomgår automatiska och manuella granskningar samt tester som efterliknar driftmiljön innan de tas i bruk.
För videodekodern libgav1 utgick agenterna från en befintlig Rust-version och ersatte 32 000 rader SIMD-kod, som bearbetar flera dataelement samtidigt. Genom upprepade experiment och analys av kompilatorns resultat skapade de minnessäker Rust-kod som kompilatorn själv kunde optimera för sådan parallell bearbetning. Enligt Google blev avkodningen 2,7 gånger snabbare än i den tidigare Rust-versionen, med identiskt videoinnehåll som resultat. Förbättringen förde Rust-versionen närmare den optimerade C++-versionen.
Hur står sig Gemini 4 Argon mot konkurrenterna?
Argon ligger högst i Googles jämförelse på flera tester av kvalificerat kontorsarbete, bland annat Vals Index, AutomationBench och testerna för finans och juridik. I DeepSWE v1.1 får den också högst resultat. Bilden varierar däremot mellan programmeringstesterna: GPT-6 Astra leder FrontierSWE v2, medan Claude Opus 5.5 leder Terminal-Bench 4.0 och PostTrainBench.
Enligt Google leder Argon Vals Index, som företaget beskriver som ett mått på ekonomisk betydelse inom områden som finans och juridik.
Aipress.se återger här Googles fullständiga jämförelse. Underlaget innehåller inga egna tester från Aipress. Google har i huvudsak hämtat konkurrenternas siffror från respektive tillverkares publicerade resultat, så tabellen sammanför mätningar från flera avsändare.
| Test | Anmärkningar | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Vals Index (kvalificerat kontorsarbete) | 68,9 % | 63,1 % | 65,8 % | 67,0 % | |
| AutomationBench (kvalificerat kontorsarbete) | Poäng | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Vals Finance Agent v2 (kvalificerat kontorsarbete) | 65,4 % | 53,5 % | 58,9 % | 58,6 % | |
| Harvey’s Legal Agent Benchmark (kvalificerat kontorsarbete) | 19,6 % | 5,4 % | 6,7 % | 3,8 % | |
| DeepSWE v1.1 (programmering med agenter) | 77,9 % | 74,1 % | 67,4 % | 74,2 % | |
| FrontierSWE v2 (programmering med agenter) | 55,0 % | 65,5 % | 56,3 % | 62,3 % | |
| Vibe Code Bench (programmering med agenter) | 91,9 % | 89,6 % | 90,3 % | 90,3 % | |
| Terminal-bench 4.0 (programmering med agenter) | 57,4 % | 58,2 % | 57,9 % | 66,4 % | |
| PostTrainBench (maskininlärning (ML)) | 45,3 % | 44,3 % | 40,2 % | 49,3 % | |
| Terminal-Bench Science 0.1 (vetenskap och matematik) | 57,6 % | 68,1 % | 52,6 % | 63,3 % | |
| LABBench 2 (vetenskap och matematik) | 88,8 % | 85,4 % | 68,6 % | 73,1 % | |
| RiemannBench (vetenskap och matematik) | 76,0 % | 72,0 % | 65,6 % | 69,6 % | |
| GraphWalks (lång kontext) | Upp till 128k, BFS (F1) | 99,7 % | 98,7 % | 91,4 % | 90,6 % |
| 256k till 1M, BFS (F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % | |
| Agent’s Last Exam (datoranvändning) | Andel godkända | 39,5 % | 34,2 % | - | 38,2 % |
| OSWorld-2.0 (datoranvändning) | Delmängd utan internet, delpoäng | 69,2 % | 72,6 % | - | - |
| Chartography (förståelse av flera medietyper) | 71,6 % | 71,0 % | 46,2 % | 66,3 % | |
| LVBench (förståelse av flera medietyper) | 91,7 % | 87,5 % | 79,7 % | 83,7 % | |
| CWE-bench v1 (cybersäkerhet) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
Alla resultat anges i procent, men testerna har olika sätt att bedöma svaren. En procentandel i ett test kan därför inte jämföras direkt med samma procentandel i ett annat. Streck betyder att jämförelsen saknar ett redovisat resultat för modellen.
Googles Argon-resultat avser ett försök per uppgift om inget annat anges. Företaget använder Gemini API med högsta inställningen för resonemang, med angivna undantag. Ett enskilt försök får inte bygga på omröstning mellan flera svar eller parallella försök. För mindre tester har Google beräknat genomsnitt över flera omgångar för att minska variationen. För konkurrenterna används högsta tillgängliga resonemangsnivå när resultat finns, annars bästa tillgängliga redovisning.
För DeepSWE v1.1 har Google gjort sin egen mätning med agentmiljön mini-swe, alltså verktygen och arbetsmiljön runt modellen. Astra-resultatet kommer från den offentliga resultatlistan, medan Fable- och Opus-resultaten kommer från deras systemkort. Google anger att den bäst presterande resonemangsnivån för varje modell används enligt Datacurves huvudlista.
Gemini 4 Argon söker och åtgärdar säkerhetsbrister
Google har tränat Argon för att självständigt hitta, kontrollera och åtgärda allvarliga sårbarheter i programvara. Betrodda säkerhetsaktörer och Googles egna team ska få tillgång utan de cyberspecifika skyddsspärrarna, så att de kan använda modellens fulla kapacitet inom försvar. Den tillgången gäller den utvalda gruppen, inte en allmän lansering utan skydd.
Säkerhetsföretaget Wiz använder redan Argon genom Scan for Good, ett initiativ som utan kostnad hjälper till att skydda kritisk offentlig infrastruktur. Enligt Google hittade modellen en kritisk sårbarhet som exponerade känsliga personuppgifter i vårdprogramvara som används av sjukhus världen över. Tidigare toppmodeller hade missat risken. Materialet anger inte vilken produkt det gällde eller någon oberoende verifiering av fyndet.
Enligt Google delar Argon förstaplatsen på CWE-bench v1, som företaget beskriver som ett test av förmågan att åtgärda säkerhetsbrister i programvara.
Google beskriver också förbättringar jämfört med Gemini 3.8 Flash Cyber i två interna tester. Googles eget sårbarhetstest omfattar komplexa kodbaser i 20 programmeringsspråk. Wiz’ test prövar intrångstestning av fungerande webbsystem utan tillgång till källkoden. Där uppges Argon vara bättre på att kartlägga möjliga angreppsvägar, hitta sårbarheter och ta fram konkreta bevis för att de kan utnyttjas. Några jämförbara procentsiffror för dessa interna tester finns inte i underlaget.
Googles skydd inför en bredare Argon-lansering
Google lyfter fram fyra områden som ska stärkas: skydd mot missbruk, skydd mot fientliga instruktioner i inläst material, övervakning av oönskat beteende och säkrare tekniska miljöer runt modellen.
Argon ska avvisa skadliga förfrågningar om cyberattacker och kemiska, biologiska, radiologiska eller nukleära angrepp, samtidigt som legitim forskning som också kan missbrukas ska vara möjlig. Google uppger att interna och externa säkerhetsgrupper har försökt kringgå skydden med både manuella och automatiserade angrepp. Företaget utvecklar också metoder för att upptäcka missbruk genom att övervaka signaler inne i modellen.
Ramarna kommer från Googles Frontier Safety Framework. Där kopplas skyddsåtgärder till nivåer av kapacitet som kan medföra allvarlig skada om riskerna inte begränsas. Ramverket omfattar även nivåer för att upptäcka mindre extrema risker tidigare. Riskbedömningar inför relevanta externa lanseringar, och vissa stora interna införanden, ska visa hur riskerna har begränsats.
Ett annat problem är indirekt promptinjektion. Det innebär att instruktioner göms i exempelvis material som modellen läser för att få den att avvika från användarens uppdrag. Google beskriver Argon som sin hittills mest motståndskraftiga modell mot sådana angrepp och uppger att den leder i Gray Swans Indirect Prompt Injection (IPI) benchmark. Företaget betonar samtidigt att angreppen kräver flera lager av skydd.
Google övervakar också Argons skrivna resonemang och handlingar för att kunna stoppa arbete som går utanför användarens avsikt. Under träningen har liknande övervakning skickat larm till en särskild incidentgrupp. Google säger att fynden hanteras försiktigt för att undvika att träna modellen att dölja sådant som övervakningen letar efter.
Den bredare planen för kontroll av AI-agenter använder betrodda system som granskar andra agenters resonemang, planer och handlingar och kan blockera skadliga åtgärder. Skydden ska skärpas med risken, från granskning i efterhand av mindre farliga handlingar till ingripanden i realtid vid allvarliga hot. Google framhåller även att synliga resonemang kan bli mindre tillförlitliga som övervakningsunderlag om modeller lär sig dölja sina avsikter.
Slutligen ska de isolerade miljöer där avancerade agenter tränas och testas förstärkas och stängas mot omgivningen inför aktiviteter med hög risk. Den stegvisa tillgången till Argon ska ge Google erfarenheter från säkerhetsaktörer och tidiga testare innan modellen släpps till den bredare grupp som företaget har aviserat.
Vanliga frågor om Gemini 4 Argon
Varför är tillgången till Gemini 4 Argon begränsad?
Google begränsar inledningsvis tillgången till Gemini 4 Argon för att samla erfarenheter från utvalda säkerhetsaktörer och vidareutveckla skydden inför en bredare lansering. Betrodda säkerhetsaktörer och Googles egna team ska få använda modellen utan de cyberspecifika skyddsspärrarna. Den stegvisa tillgången ger Google möjlighet att lära av säkerhetsaktörer och tidiga testare innan fler får tillgång.
Vad är Googles Fairwind Program?
Googles Fairwind Program är programmet genom vilket Gemini 4 Argon först görs tillgänglig för en utvald grupp betrodda aktörer inom cybersäkerhet. Google samlar in deras erfarenheter och vidareutvecklar skydden innan modellen blir allmänt tillgänglig.
Blir Gemini 4 Argon dyrare efter introduktionspriset?
Ja, API-priset för Gemini 4 Argon fördubblas efter introduktionsperioden, från 2 till 4 dollar per miljon inmatade token och från 10 till 20 dollar per miljon token som modellen producerar. Google anger inte hur länge introduktionspriset gäller. Priserna gäller användning genom API och är inte kostnaden för ett abonnemang på Google AI Ultra.
När får abonnenter på Google AI Ultra tillgång till Gemini 4 Argon?
Google har inte angett något datum för när abonnenter på Google AI Ultra får tillgång till Gemini 4 Argon. Efter det begränsade programmet ska den bredare tillgången börja med betalande API-kunder och Google AI Ultra-abonnenter. Google presenterar ingen öppen provversion i lanseringsmaterialet.
Källor
- Gemini 4 Argon: our next era of frontier intelligence
Google, hämtad
- Gemini models
Google, hämtad
- Gemini Developer API pricing
Google, hämtad
- Gemini Apps limits & upgrades for Google AI subscribers
Google, hämtad
- Google AI Pro & Ultra
Google, hämtad
- Gemini Apps release notes
Google, hämtad
- Gemini Enterprise release notes
Google, hämtad
- Gemini Enterprise - Business edition release notes
Google, hämtad
- Gemini API release notes
Google, hämtad
- Gemini CLI changelogs
Google, hämtad
- Gemini CLI releases
Google, hämtad
- Antigravity CLI releases
Google, hämtad
- Antigravity CLI changelog
Google, hämtad
- Strengthening our Frontier Safety Framework
Google DeepMind, hämtad
- Securing the future of AI agents
Google DeepMind, hämtad
- The case for reasoning transparency
Deepmind, hämtad
- Gemini 4 Argon
Googleapis, hämtad
- Gemini 4 Argon
Google DeepMind, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.