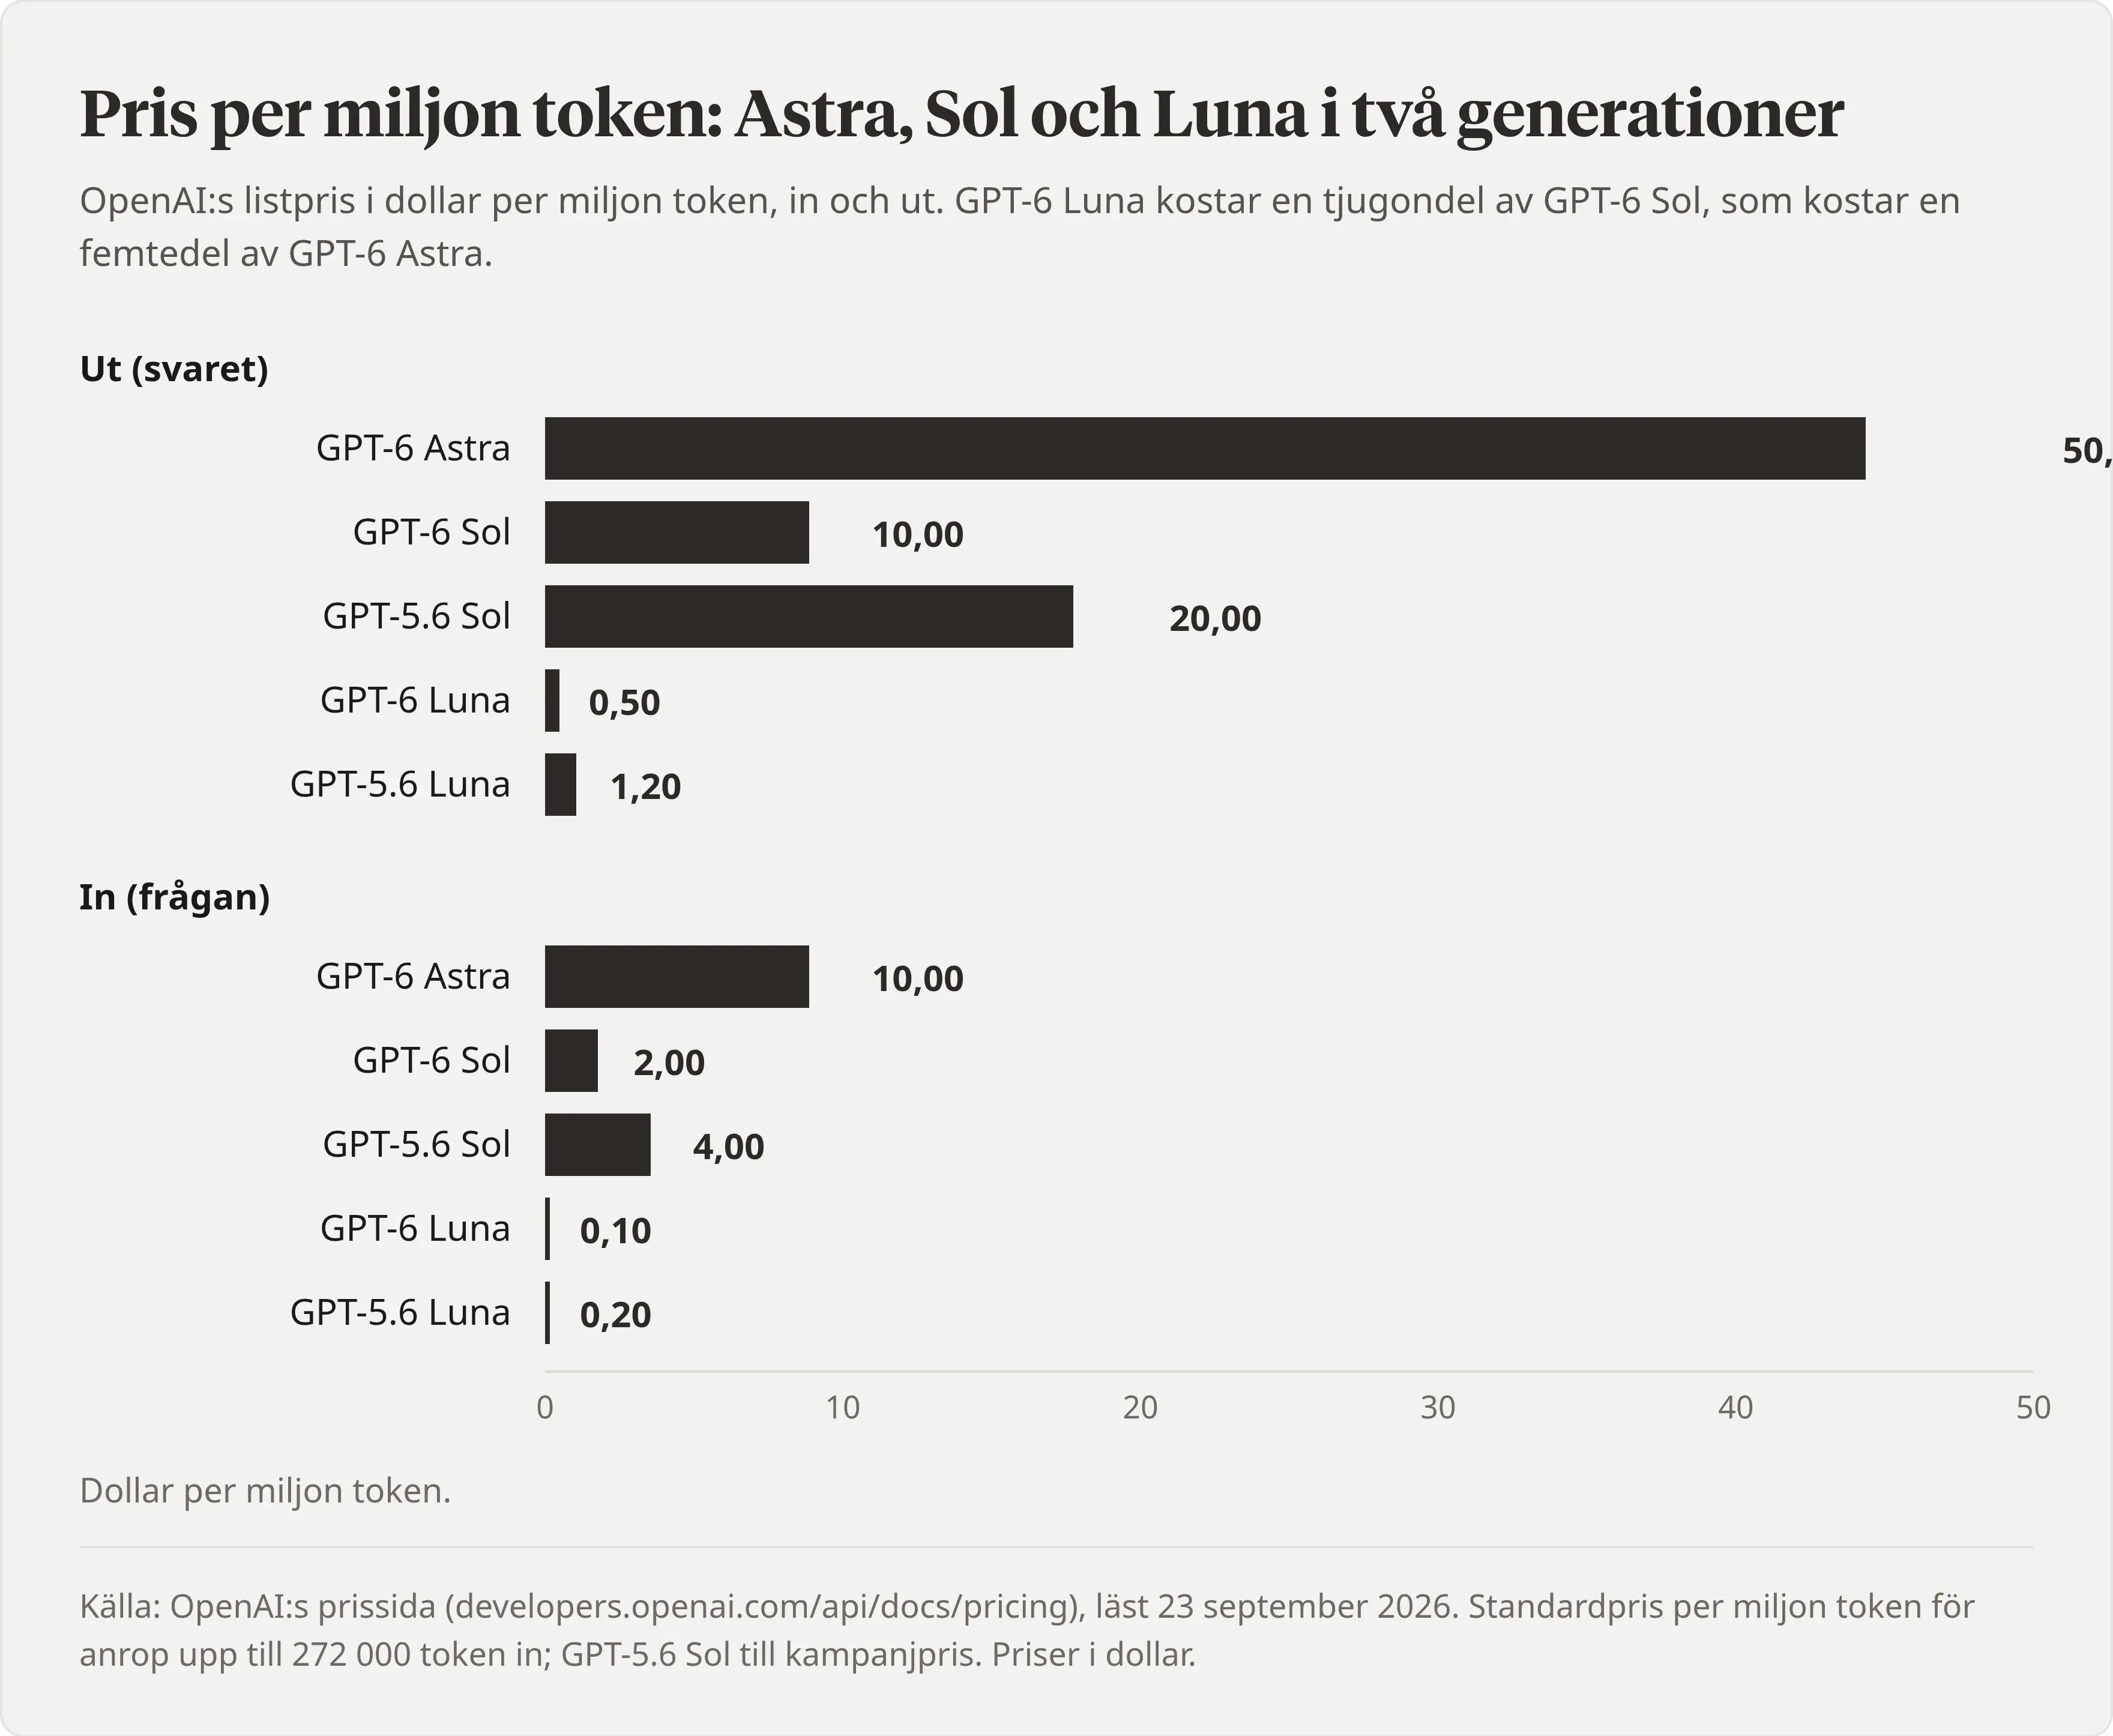
GPT-6 Sol och Luna lanserades den 22 september och bygger enligt OpenAI på samma typer av data och träning som GPT-6 Astra. Astra ska ge högsta möjliga kvalitet, Sol är ett billigare alternativ för avancerat arbete och Luna är avsedd för snabba uppgifter i stora volymer.
OpenAI förklarar inte varför nivåerna heter Sol, Terra och Luna. Företaget har tidigare sagt att siffran anger modellgenerationen, medan namnen står för varaktiga kapacitetsnivåer som kan utvecklas i olika takt. I GPT-5.6 var Sol toppmodellen. I GPT-6 har Astra tagit den rollen. Någon GPT-6 Terra finns inte, och OpenAI har inte sagt vad som ska hända med Terra framöver.
Skillnaderna syns tydligt i prislistan. Sol kostar en femtedel av Astra. Luna kostar i sin tur en tjugondel av Sol och blev i flera av Aipress tester så billig att kostnaden avrundades till en bråkdel av ett cent.
Luna var inte lika noggrann som Sol i alla uppgifter, men skillnaden var mindre än priset antyder. Den hittade kodfel, läste bilder, skapade fungerande Excel- och PowerPoint-filer och byggde det enda klassiska Asteroids-spelet i testet, med ett roterande skepp och stenar som delades när de träffades. Spelet var samtidigt långsammare än de andra versionerna.
Sol och Luna finns i ChatGPT Work och Codex, inte i Chat
GPT-6 Sol och Luna finns i ChatGPT Work och Codex för användare med Plus, Pro, Business, Enterprise och Edu. Free- och Go-användare får enligt OpenAI:s lanseringsinlägg tillgång till Luna i datorappen.
De finns däremot inte i vanliga ChatGPT-samtal, som OpenAI nu kallar Chat. Work är den del av ChatGPT som är avsedd för längre uppgifter där AI:n kan använda verktyg och leverera färdiga filer eller annat arbetsmaterial.
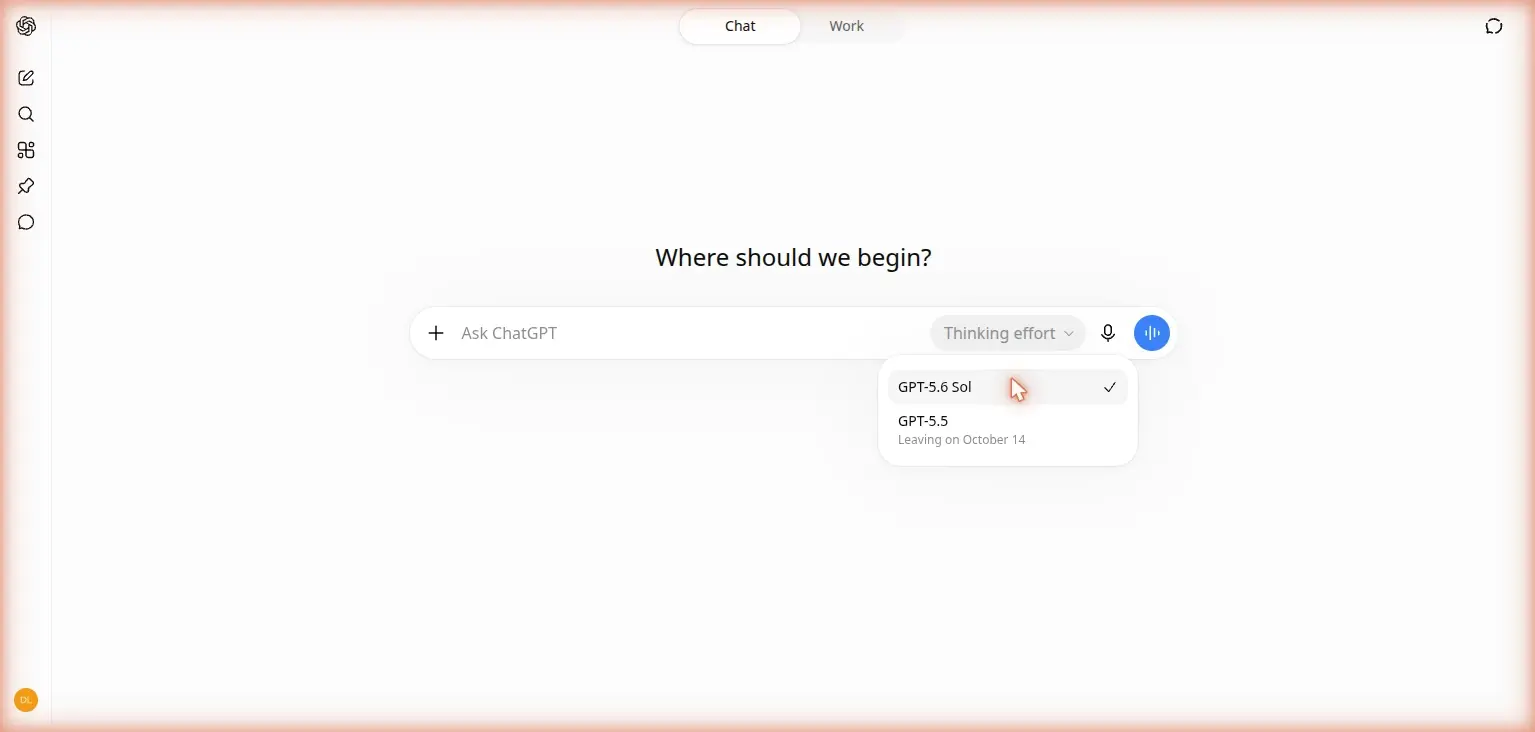
Aipress kontrollerade tillgängligheten med ett vanligt ChatGPT Plus-konto natten till den 23 september. Både Sol och Luna fanns i Work och Codex utan att kontot eller regionen behövde ändras.
I Work kunde vi välja mellan GPT-6 Astra, Sol och Luna samt flera äldre modeller. Den automatiska inställningen startade på Sol med den lägsta tankenivån, Light. Även när Sol eller Luna valdes manuellt var Light förvalt.
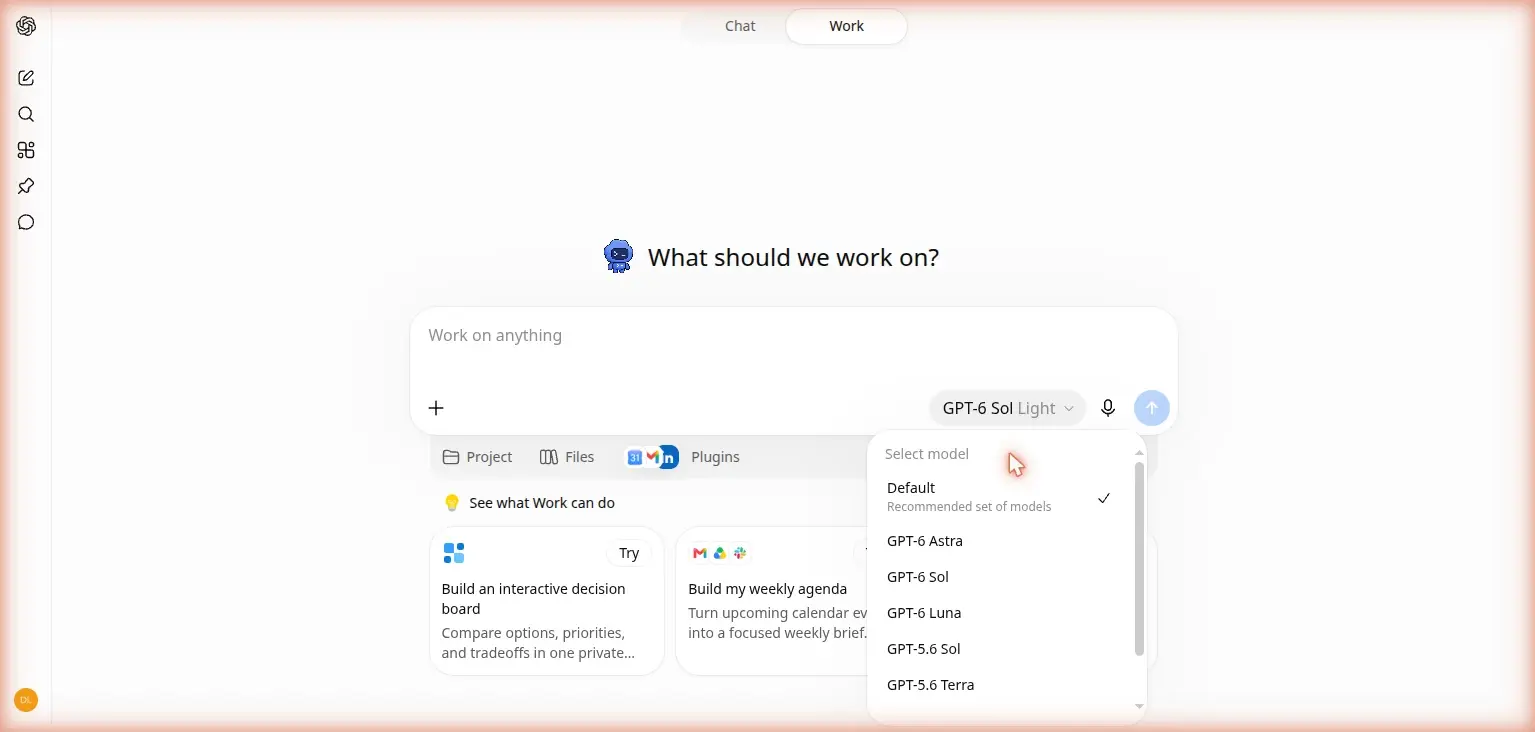
Codex 0.156.0, som redan var installerat, hade båda modellerna. Ingen uppdatering behövdes. Där startade både Sol och Luna på Medium. Sol kunde ställas upp till Ultra, medan Luna stannade på Max. OpenAI rekommenderar att användaren börjar med Medium för Sol och High för Luna, men ingen av de två testade ytorna följde det rådet: Work började på Light och Codex på Medium.
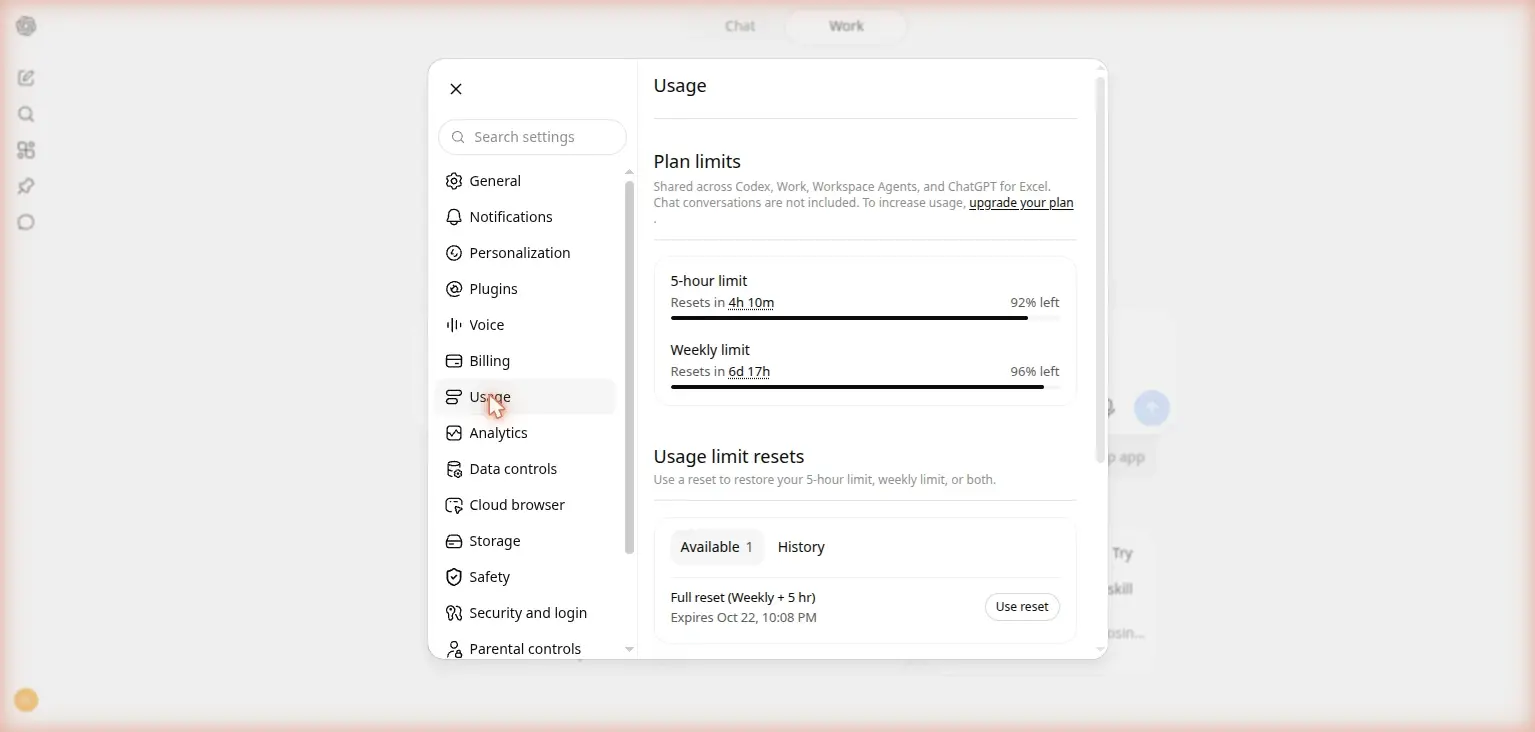
Användningsgränsen delas mellan Codex, Work, arbetsplatsagenter och ChatGPT för Excel. Våra 29 Codex-körningar och fyra uppgifter i Work förbrukade nio procent av Plus-kontots femtimmarspott. OpenAI har inte publicerat några separata meddelandegränser för Sol eller Luna.
Luna kostar 50 cent för en miljon token ut
API-priserna anges per miljon token. En token är en liten textdel.
| Modell | Text in, dollar | Cachad text in, dollar | Text ut, dollar |
|---|---|---|---|
| GPT-6 Astra | 10 | 1 | 50 |
| GPT-6 Sol | 2 | 0,20 | 10 |
| GPT-6 Luna | 0,10 | 0,01 | 0,50 |
OpenAI beskriver båda som 50 procent billigare än motsvarande GPT-5.6-versioner. Det stämmer för Sol när jämförelsen görs med GPT-5.6 Sols tillfälliga kampanjpris.
För Luna är prissänkningen större på utdata. Priset sjunker från 1,20 till 0,50 per miljon token, motsvarande drygt 58 procent. GPT-5.6 Lunas pris står inte heller som kampanjpris på OpenAI:s prissida, trots formuleringen i lanseringsinlägget.
Priserna ovan gäller anrop med högst 272 000 token in. Längre anrop kostar dubbelt för inkommande och cachade token, medan utdata blir 50 procent dyrare. Batch- och Flex-körningar kostar hälften av standardpriset. Snabbläget kostar dubbelt.
För företag som behöver regional databehandling finns EU-regionen, som omfattar EES och Schweiz. Sol och Luna kan använda den med standardbearbetning och ett påslag på 10 procent. OpenAI påpekar att datalagring i en region inte innebär att all konto-, användnings- och systeminformation stannar där.
OpenAI jämför Sol med en äldre Claude-modell
OpenAI:s främsta jämförelse kommer från AutomationBench, där AI-agenter genomför arbetsflöden med 47 verktyg inom bland annat försäljning, ekonomi, support och personalarbete.
GPT-6 Sol med tankenivån Xhigh klarade 33,2 procent av uppgifterna till en genomsnittlig kostnad på 0,27 dollar. Inlägget formulerar det så här:
On AutomationBench, a test of business workflows across apps, GPT‑6 Sol at xhigh effort outperforms Claude Opus 5 at max effort at just 9% of Opus 5’s cost per task. At high effort, GPT‑6 Luna improves on its predecessor by 5.4 percentage points at 58% lower cost per task.
Det betyder att Sol slår en halvårsgammal konkurrent för en bråkdel av pengarna, och att Luna tar ett rejält kliv från sin föregångare.
Jämförelsen är korrekt men ofullständig. Claude Opus 5.5 lanserades samma dag och finns redan på Zapiers resultatlista. Den klarade 40 procent på maxnivån och ligger tvåa. GPT-6 Sol ligger sjua, efter fyra Astra-inställningar och två Opus 5.5-inställningar.
| Placering | Modell | Klarade uppgifter, procent | Kostnad per uppgift, dollar |
|---|---|---|---|
| 1 | GPT-6 Astra, Max | 41,4 | 1,73 |
| 2 | Claude Opus 5.5, Max | 40,0 | 1,28 |
| 5 | Claude Opus 5.5, Xhigh | 34,4 | 0,80 |
| 7 | GPT-6 Sol, Xhigh | 33,2 | 0,27 |
| 8 | GPT-6 Sol, Max | 32,0 | 0,34 |
| 31 | GPT-6 Luna, Max | 20,7 | 0,04 |
Sol är alltså inte bäst i AutomationBench, men resultatet är starkt i förhållande till kostnaden. Luna kostar fyra cent per uppgift på maxnivån och klarar ungefär var femte uppgift.
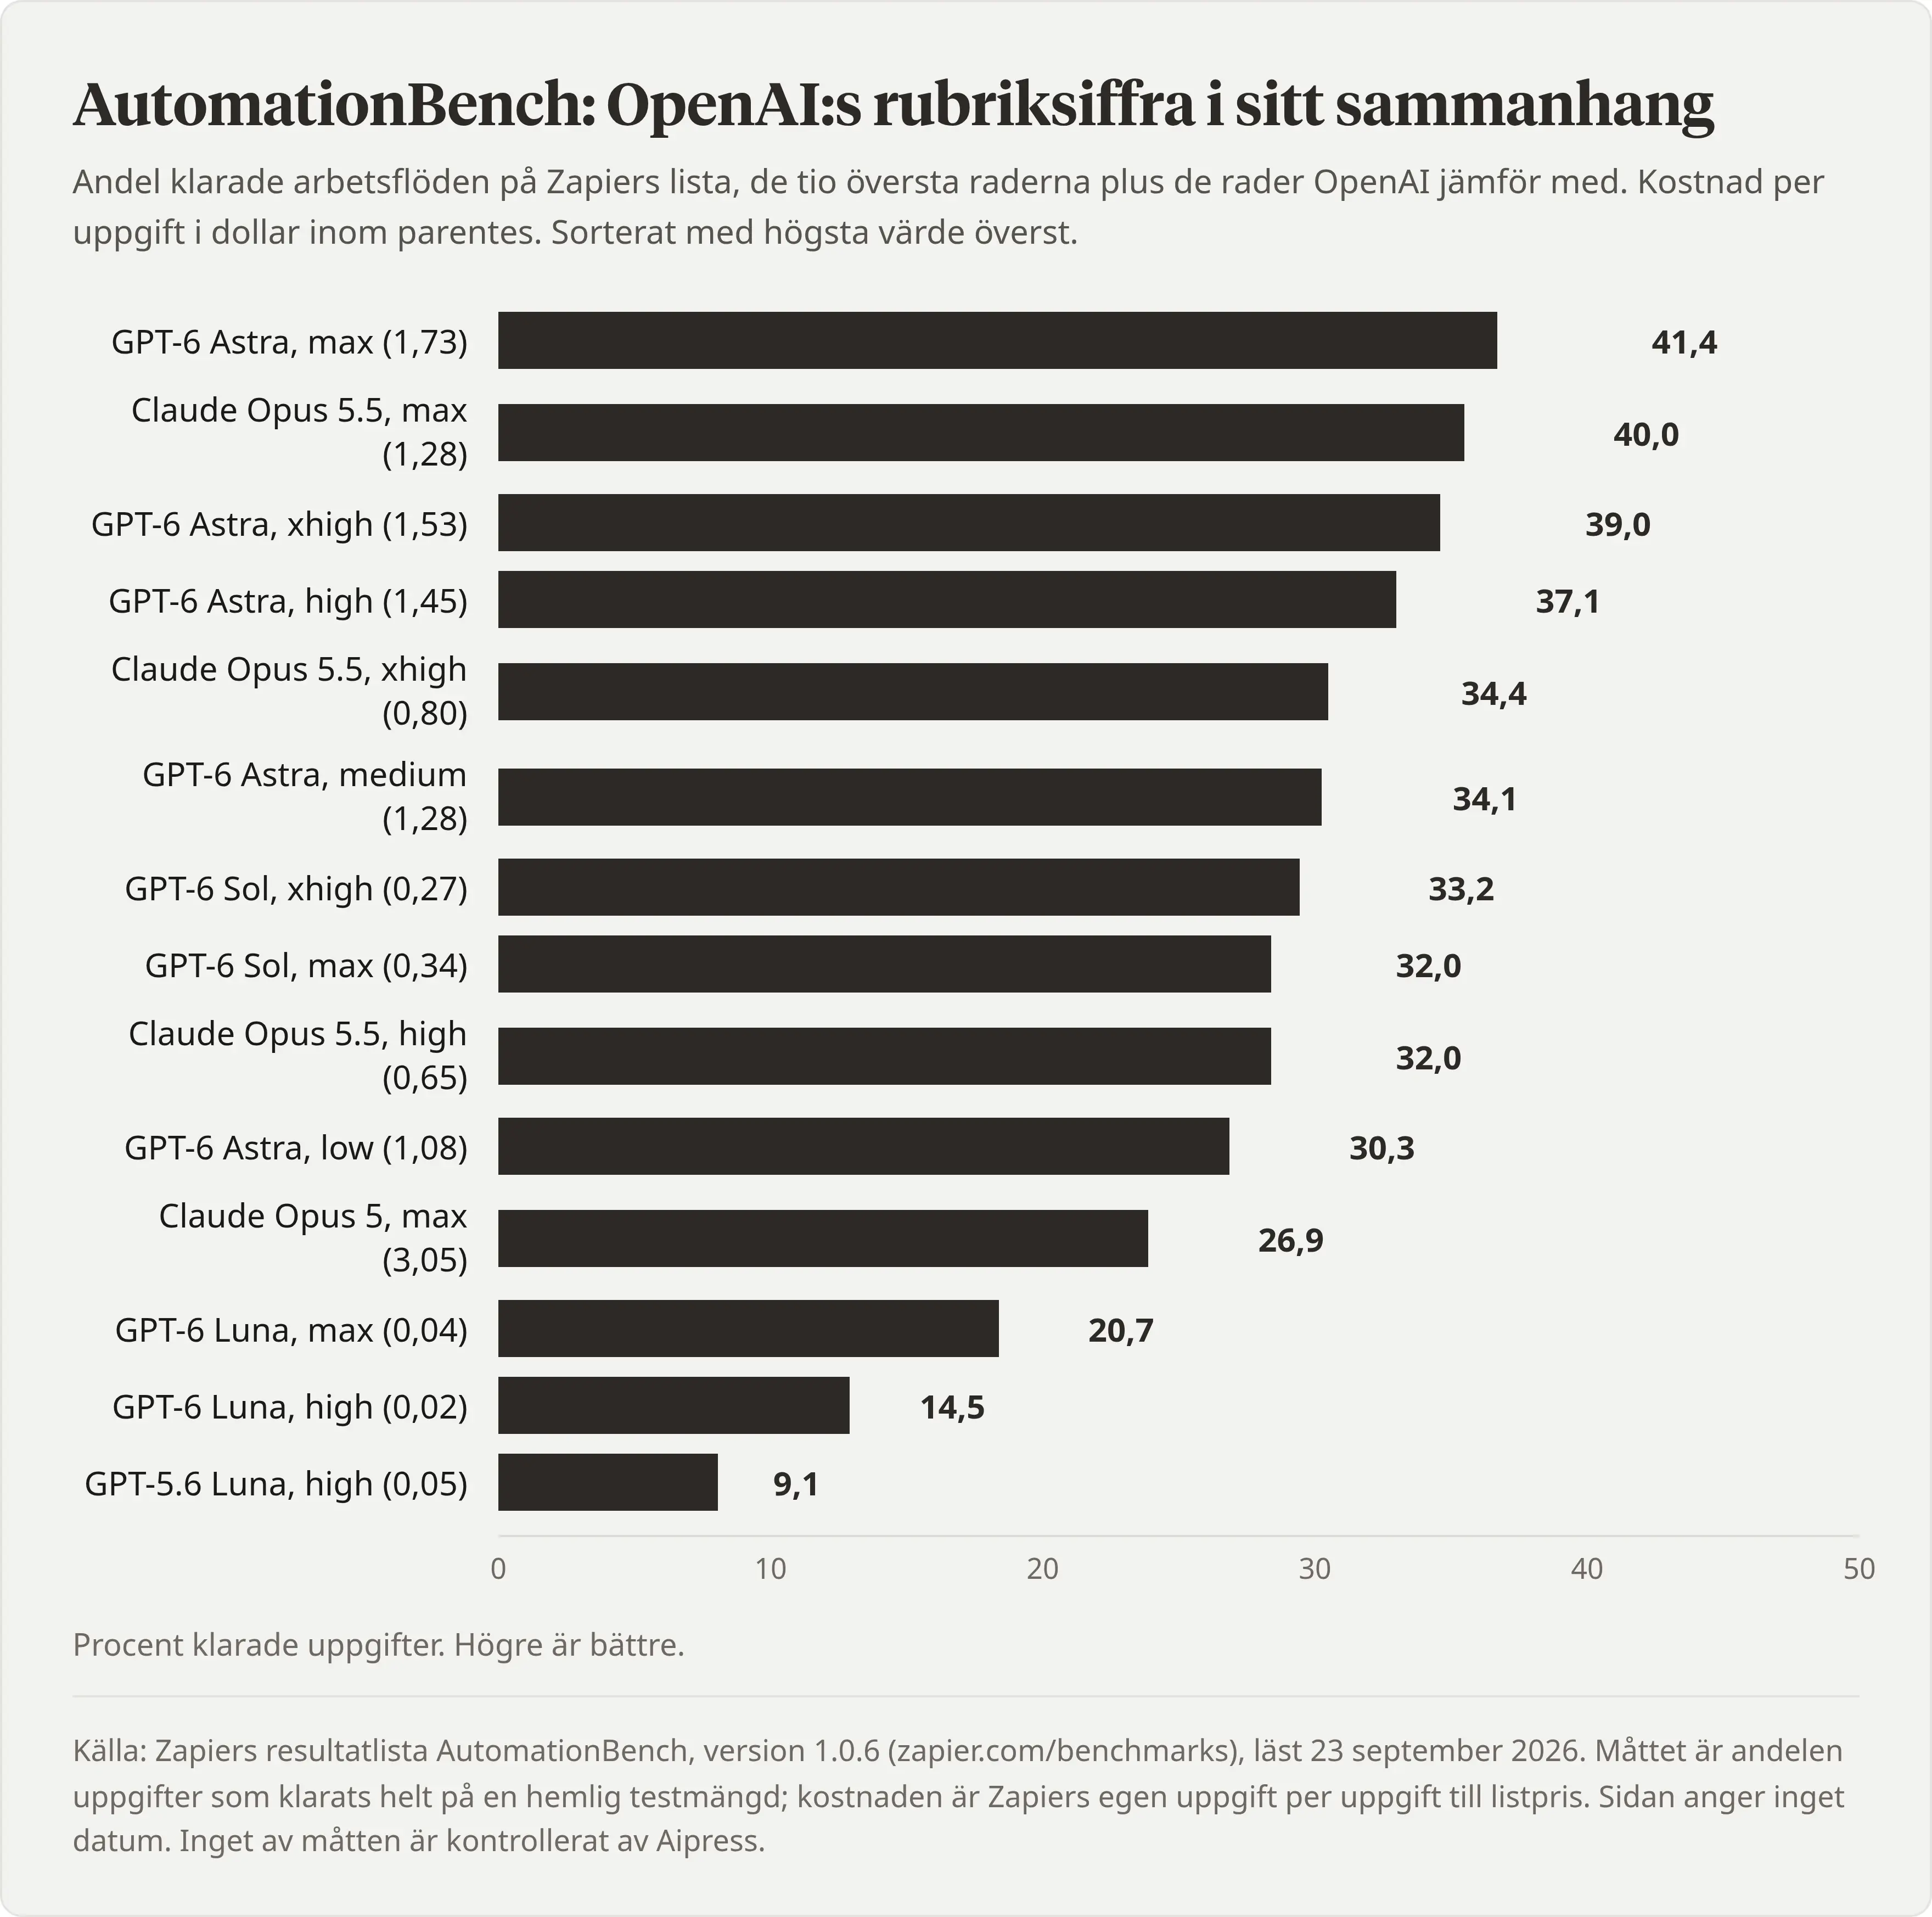
OpenAI redovisar även goda resultat för Sol inom programmering och datorstyrning. På DeepSWE får modellen 68,8 procent, 1,1 procentenheter under Claude Fable 5:s högsta resultat, till omkring 80 procent lägre kostnad per uppgift. Luna når 66,6 procent och uppges kosta 93 till 96 procent mindre än de Claude-inställningar som jämförs.
Resultaten bör läsas som leverantörs- och topplistemätningar, inte som ett besked om vilken modell som alltid fungerar bäst. OpenAI har kört sina modeller i en forskningsmiljö som kan skilja sig från ChatGPT. Konkurrenternas siffror kommer delvis från deras egna rapporter och har inte tagits fram i exakt samma miljö.
Aipress test: Luna gjorde arbetet på halva tiden
Aipress körde sju vardagsuppgifter med båda modellerna på tankenivån Medium. Testerna gjordes i Codex 0.156.0 med ett ChatGPT Plus-konto. Webbsökning var avstängd och varje uppgift kördes en gång per modell.
De fick rätta ett svenskt kundmejl, hitta två fel i Python-kod, göra om ett ICA-kvitto till JSON, kontrollera väder genom ett verktyg, läsa en fotograferad prislista samt skapa en Excel-budget och en PowerPoint-presentation.
| Resultat | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Uppgifter helt rätt | 6 av 7 | 5 av 7 |
| Sammanlagd tid, sekunder | 335 | 166 |
| Beräknad API-kostnad, dollar | 0,378 | 0,012 |
| Utdata, token | 12 933 | 7 158 |
| Därav tanketoken | 3 408 | 531 |
Luna gjorde uppgifterna på mindre än halva tiden och till ungefär en trettiondel av kostnaden. Fem av de sju resultaten blev helt rätt trots att den inte använde några redovisade tanketoken på de fem mindre uppgifterna.
Tidigare körningar av samma uppgifter ger mer sammanhang. GPT-6 Astra klarade samtliga sju på 175 sekunder till en beräknad kostnad på 0,527 dollar. Grok 4.7 fick också alla rätt, tog 489 sekunder och kostade 0,228 dollar. Claude Opus 5.5 gjorde uppgifterna på 191 sekunder till 1,37 dollar via Claude Code. Luna var därmed billigast av samtliga jämförda alternativ, medan Sol kostade mer än Grok men mindre än Astra och Claude.
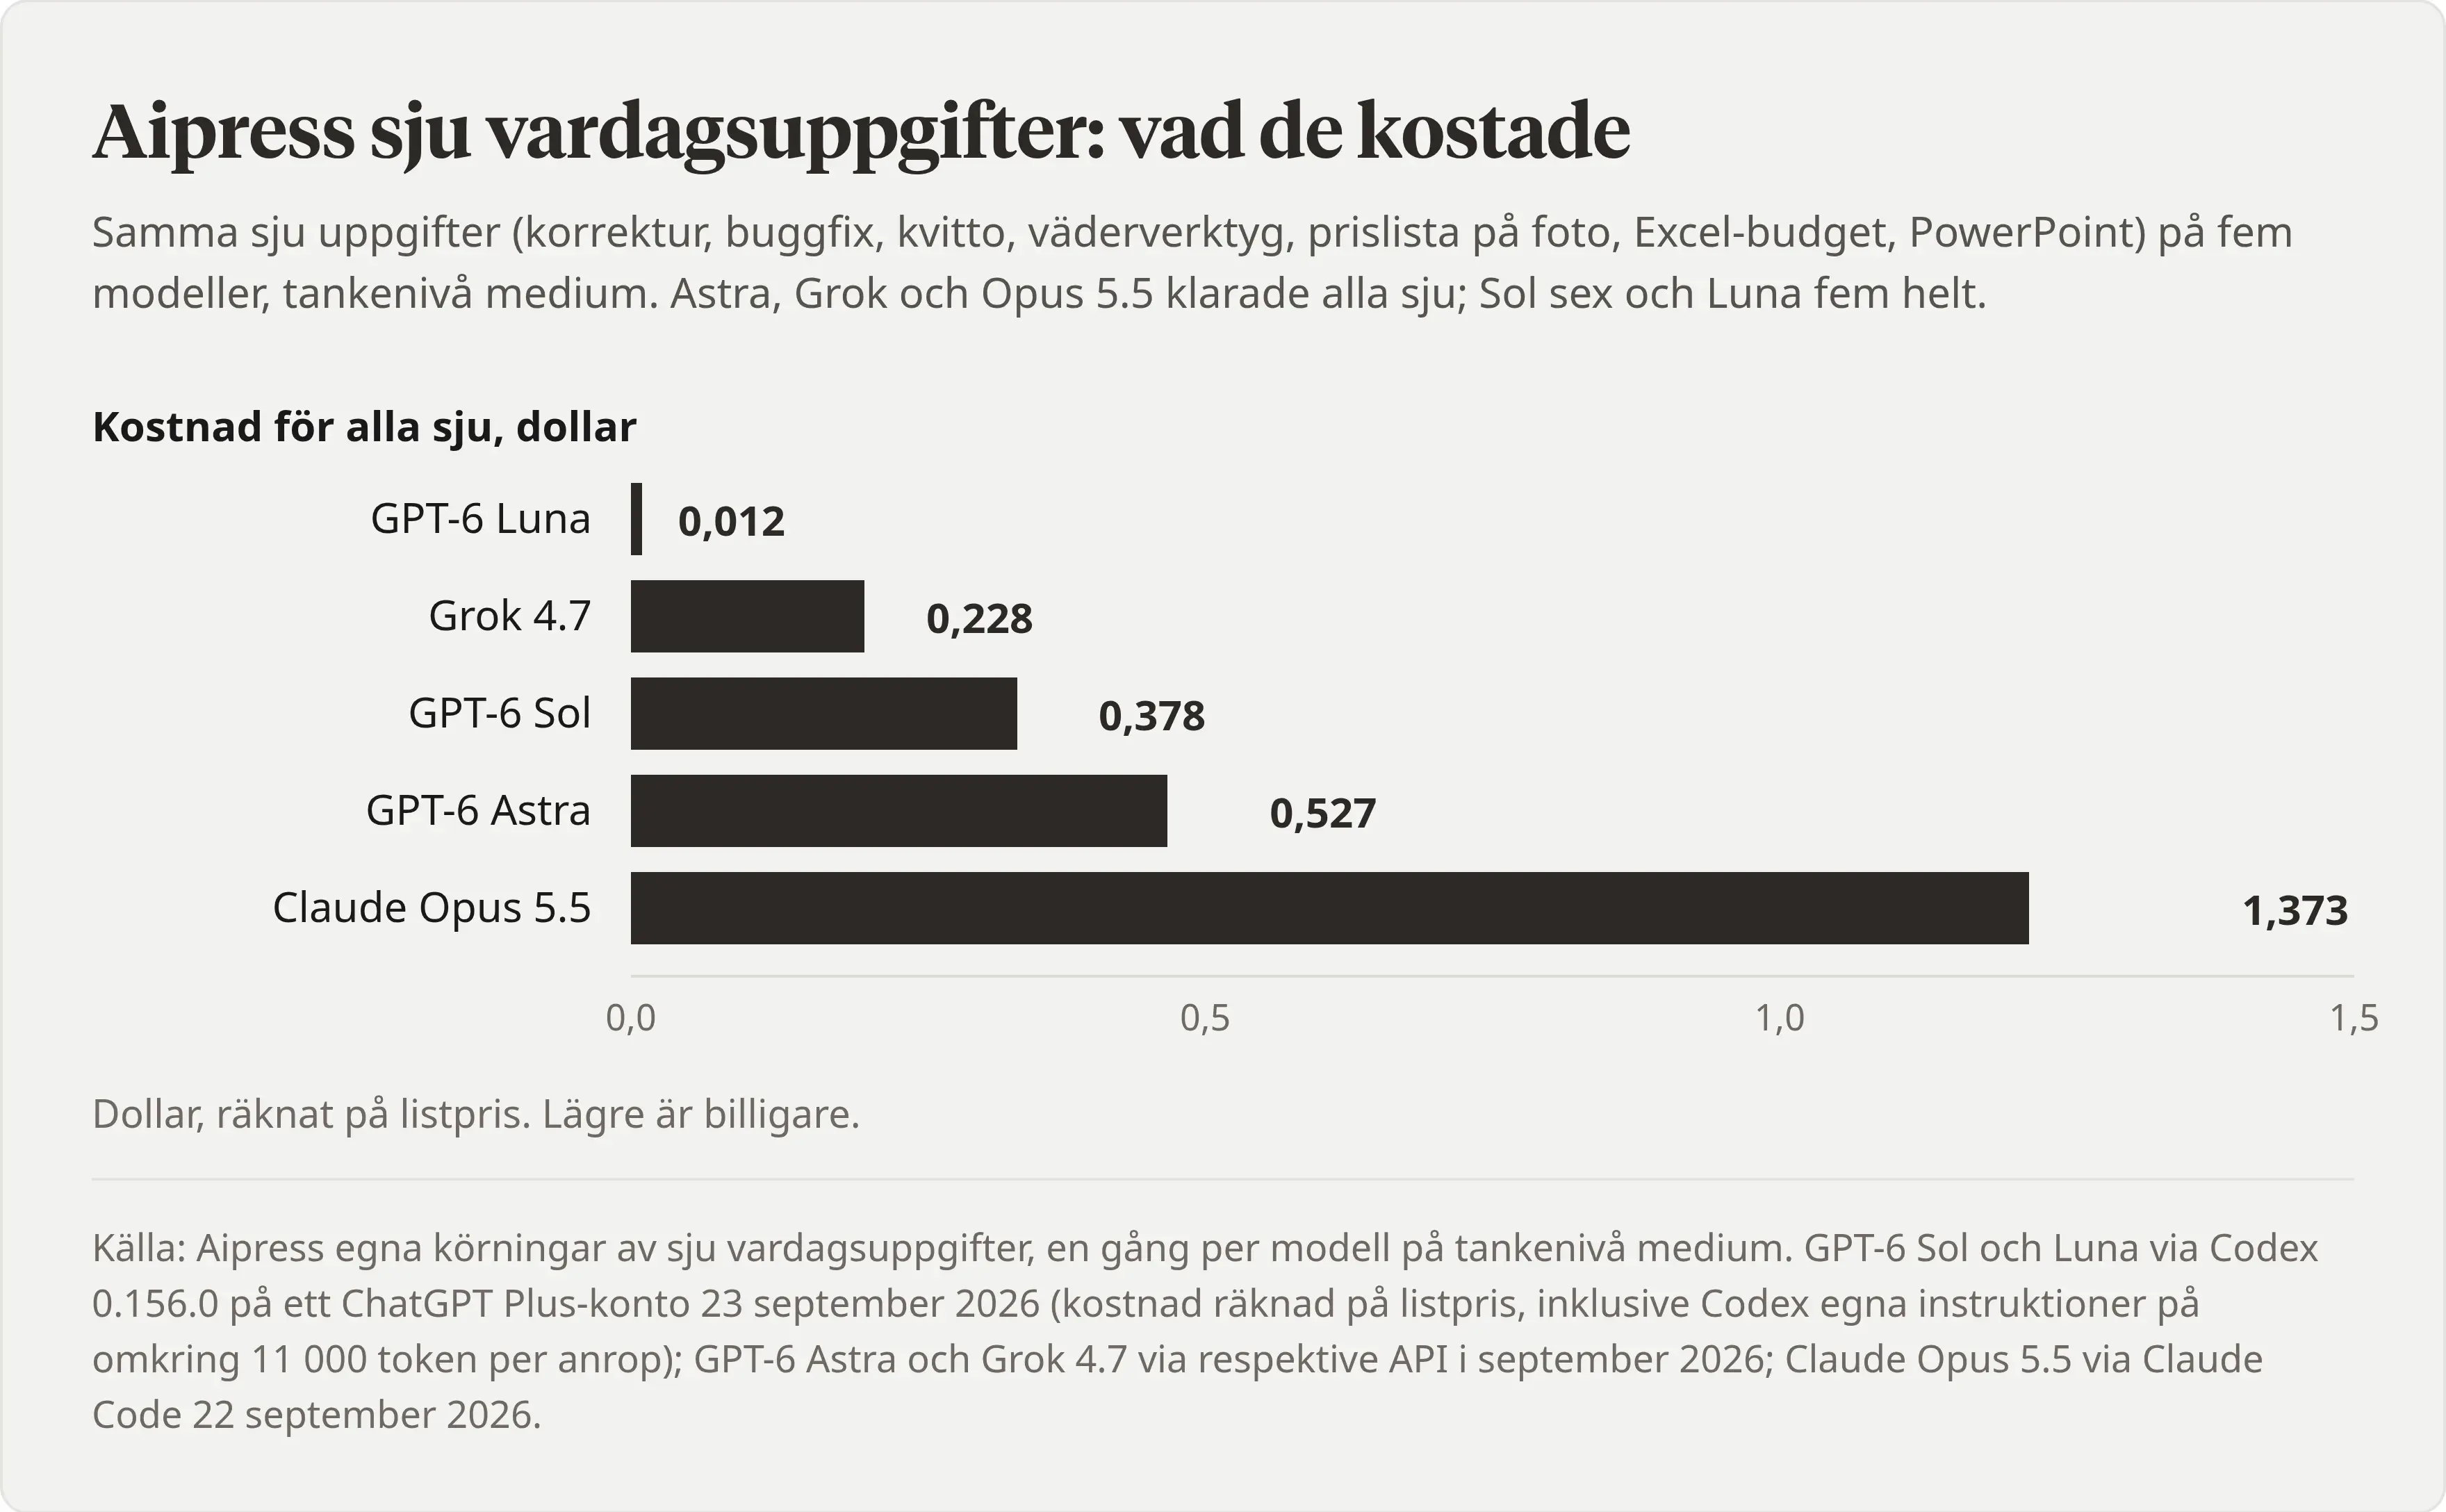
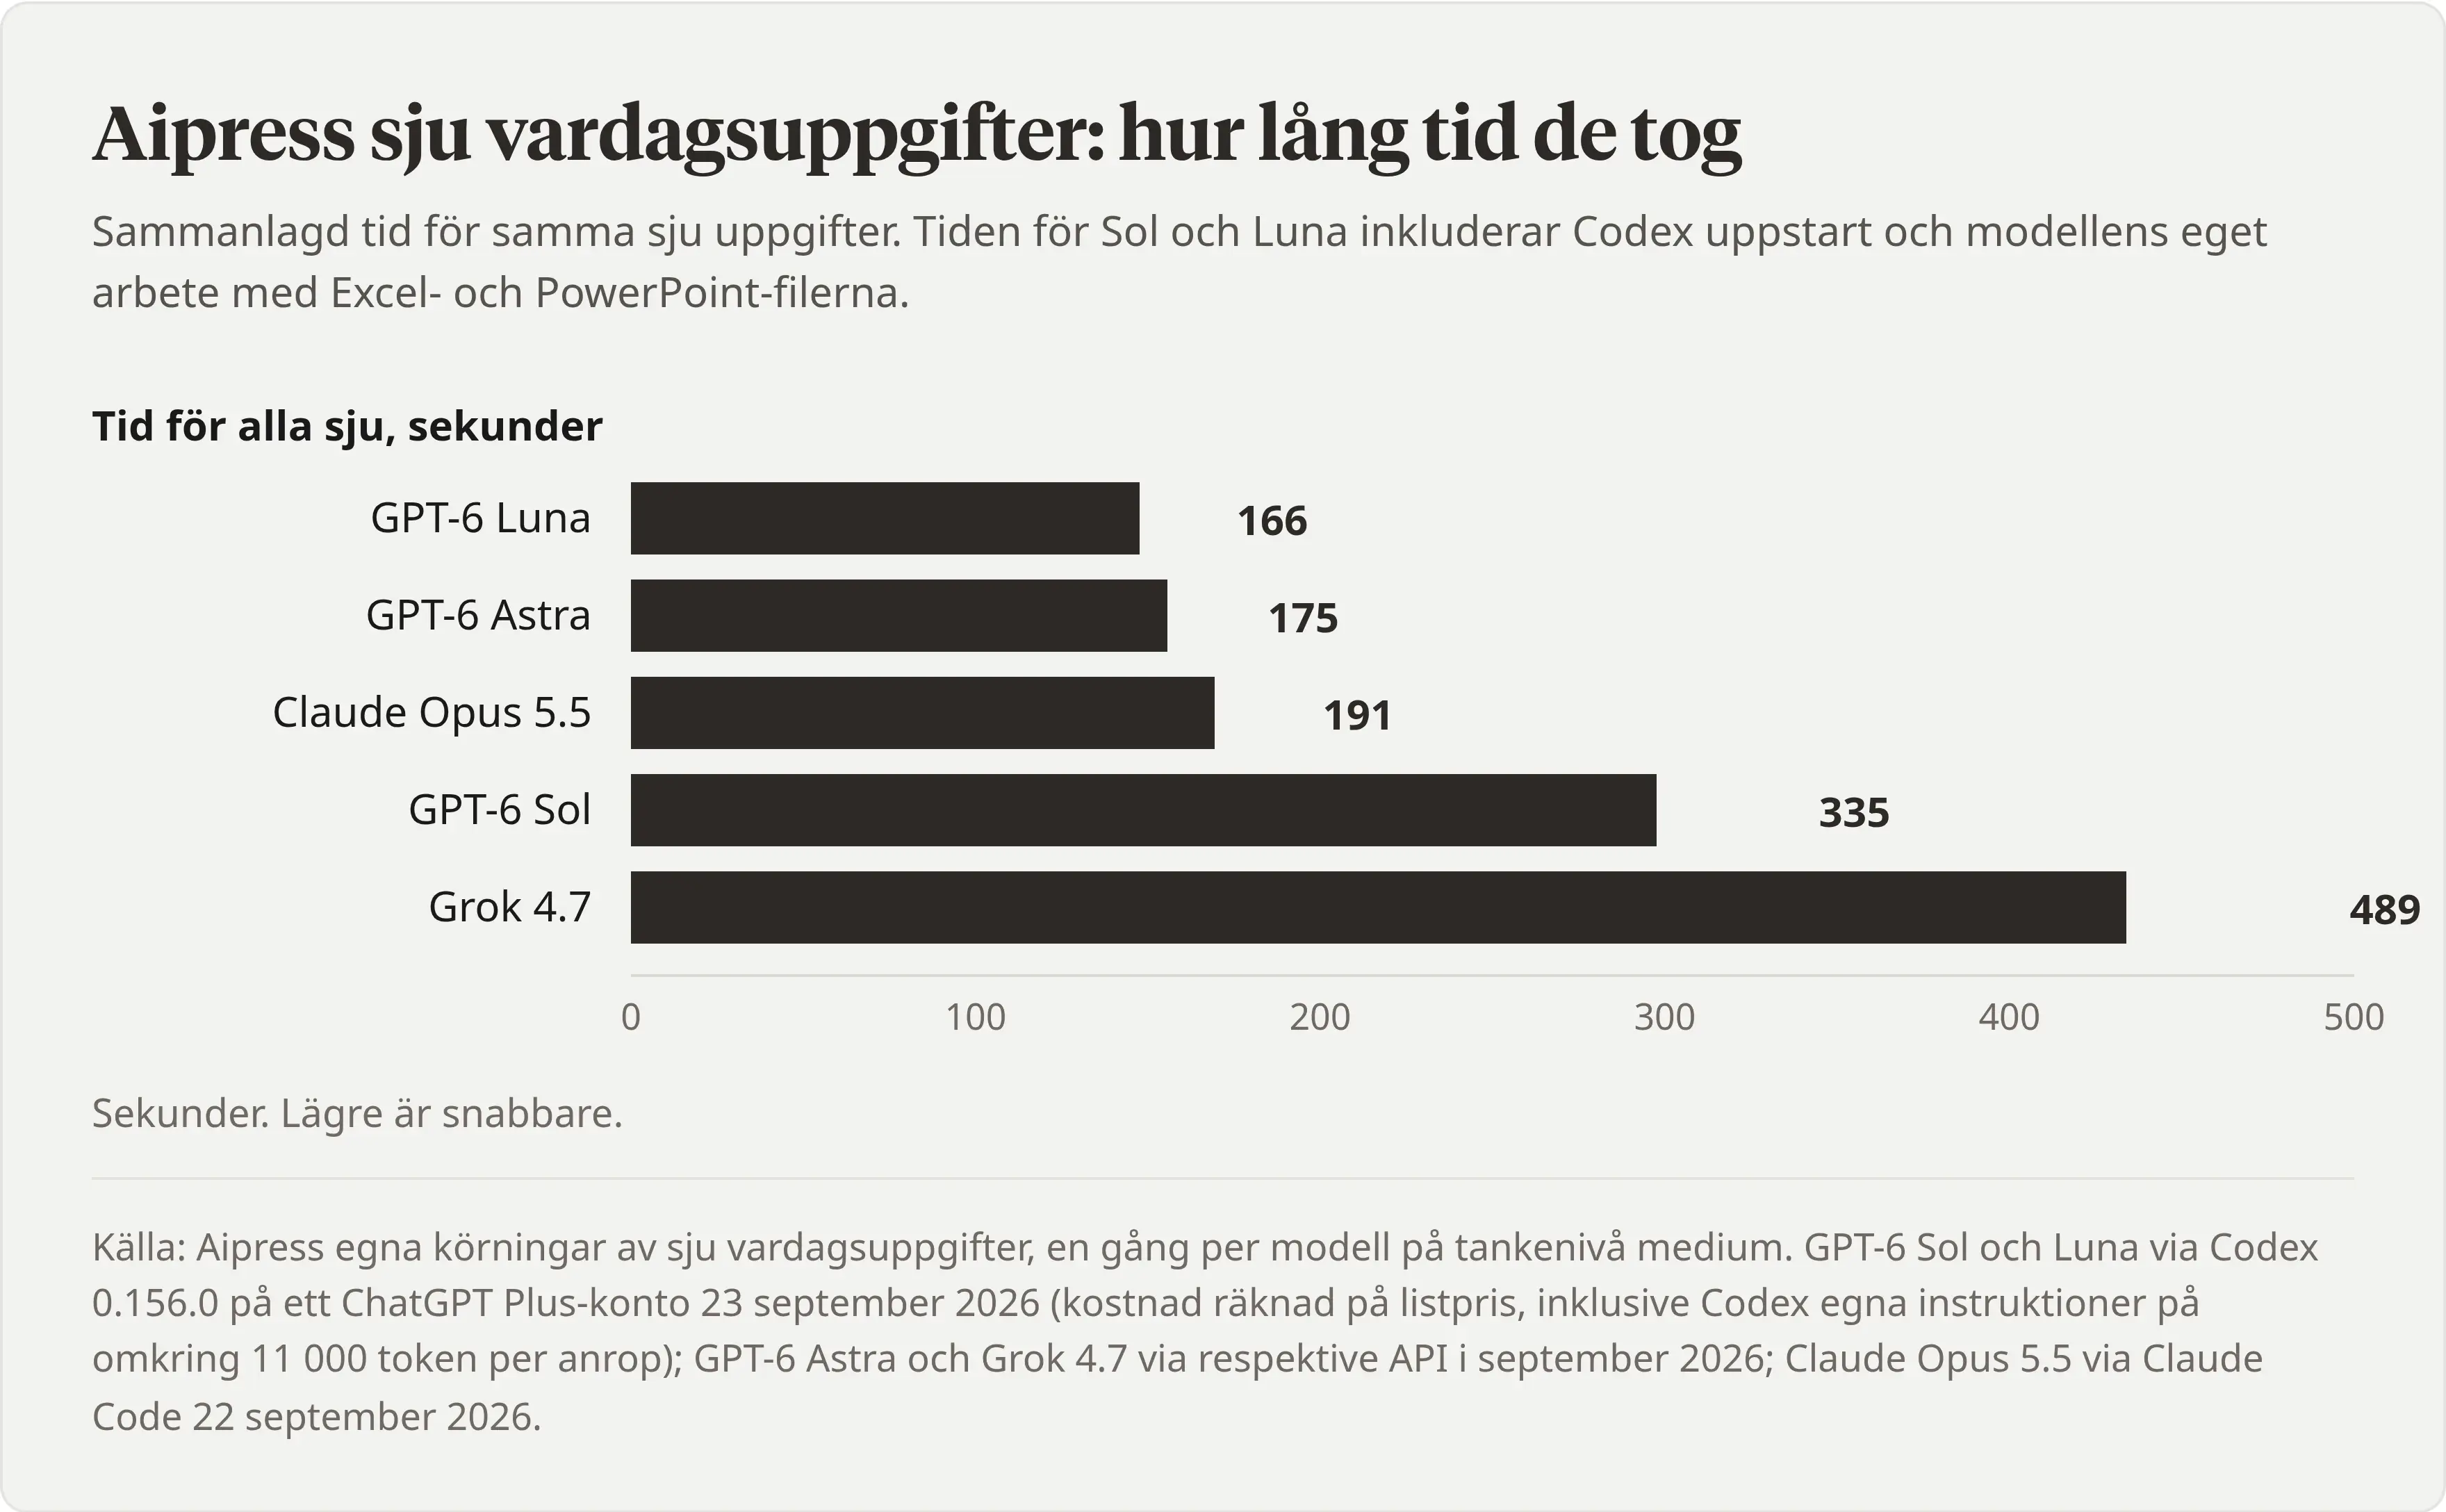
Sol var noggrannare i korrekturuppgiften. Den hittade samtliga sju planterade fel och redovisade varje ändring. Luna rättade också alla fel men utelämnade tre ändringar från sin redovisning. Bland annat skrev den om kundens formulering från ”för att” till ”eftersom” utan att säga det.
I kodtestet var Luna mer återhållsam. Båda hittade de två felen, men Sol lade dessutom till en avrundning som uppgiften inte efterfrågade. Luna ändrade bara de två felaktiga delarna.
Båda läste kvittot rätt och räknade fram summan 210,13 kronor. De tolkade även den fotograferade prislistan och kom fram till rätt totalsumma, 156 kronor.
Vädertestet misslyckades först för båda. Felet låg i testmiljön: verktyget hade ett svenskt namn och en svensk beskrivning, medan de sökte efter engelska ord som ”weather”. När verktyget fick ett engelskt namn hittade båda det, gjorde två anrop och svarade rätt för Uppsala och Sigtuna. En agents verktygskatalog och beskrivningar kan alltså avgöra resultatet även när själva modellen klarar uppgiften.
Kostnaderna är beräknade med API-priserna utifrån Codex rapporterade tokenmängder. Plus-kontot debiterades inte per token. Codex skickade dessutom med omkring 11 000 token egna instruktioner i varje körning. På små uppgifter stod dessa instruktioner för större delen av Sols beräknade kostnad.
Båda skapade fungerande Excel- och PowerPoint-filer
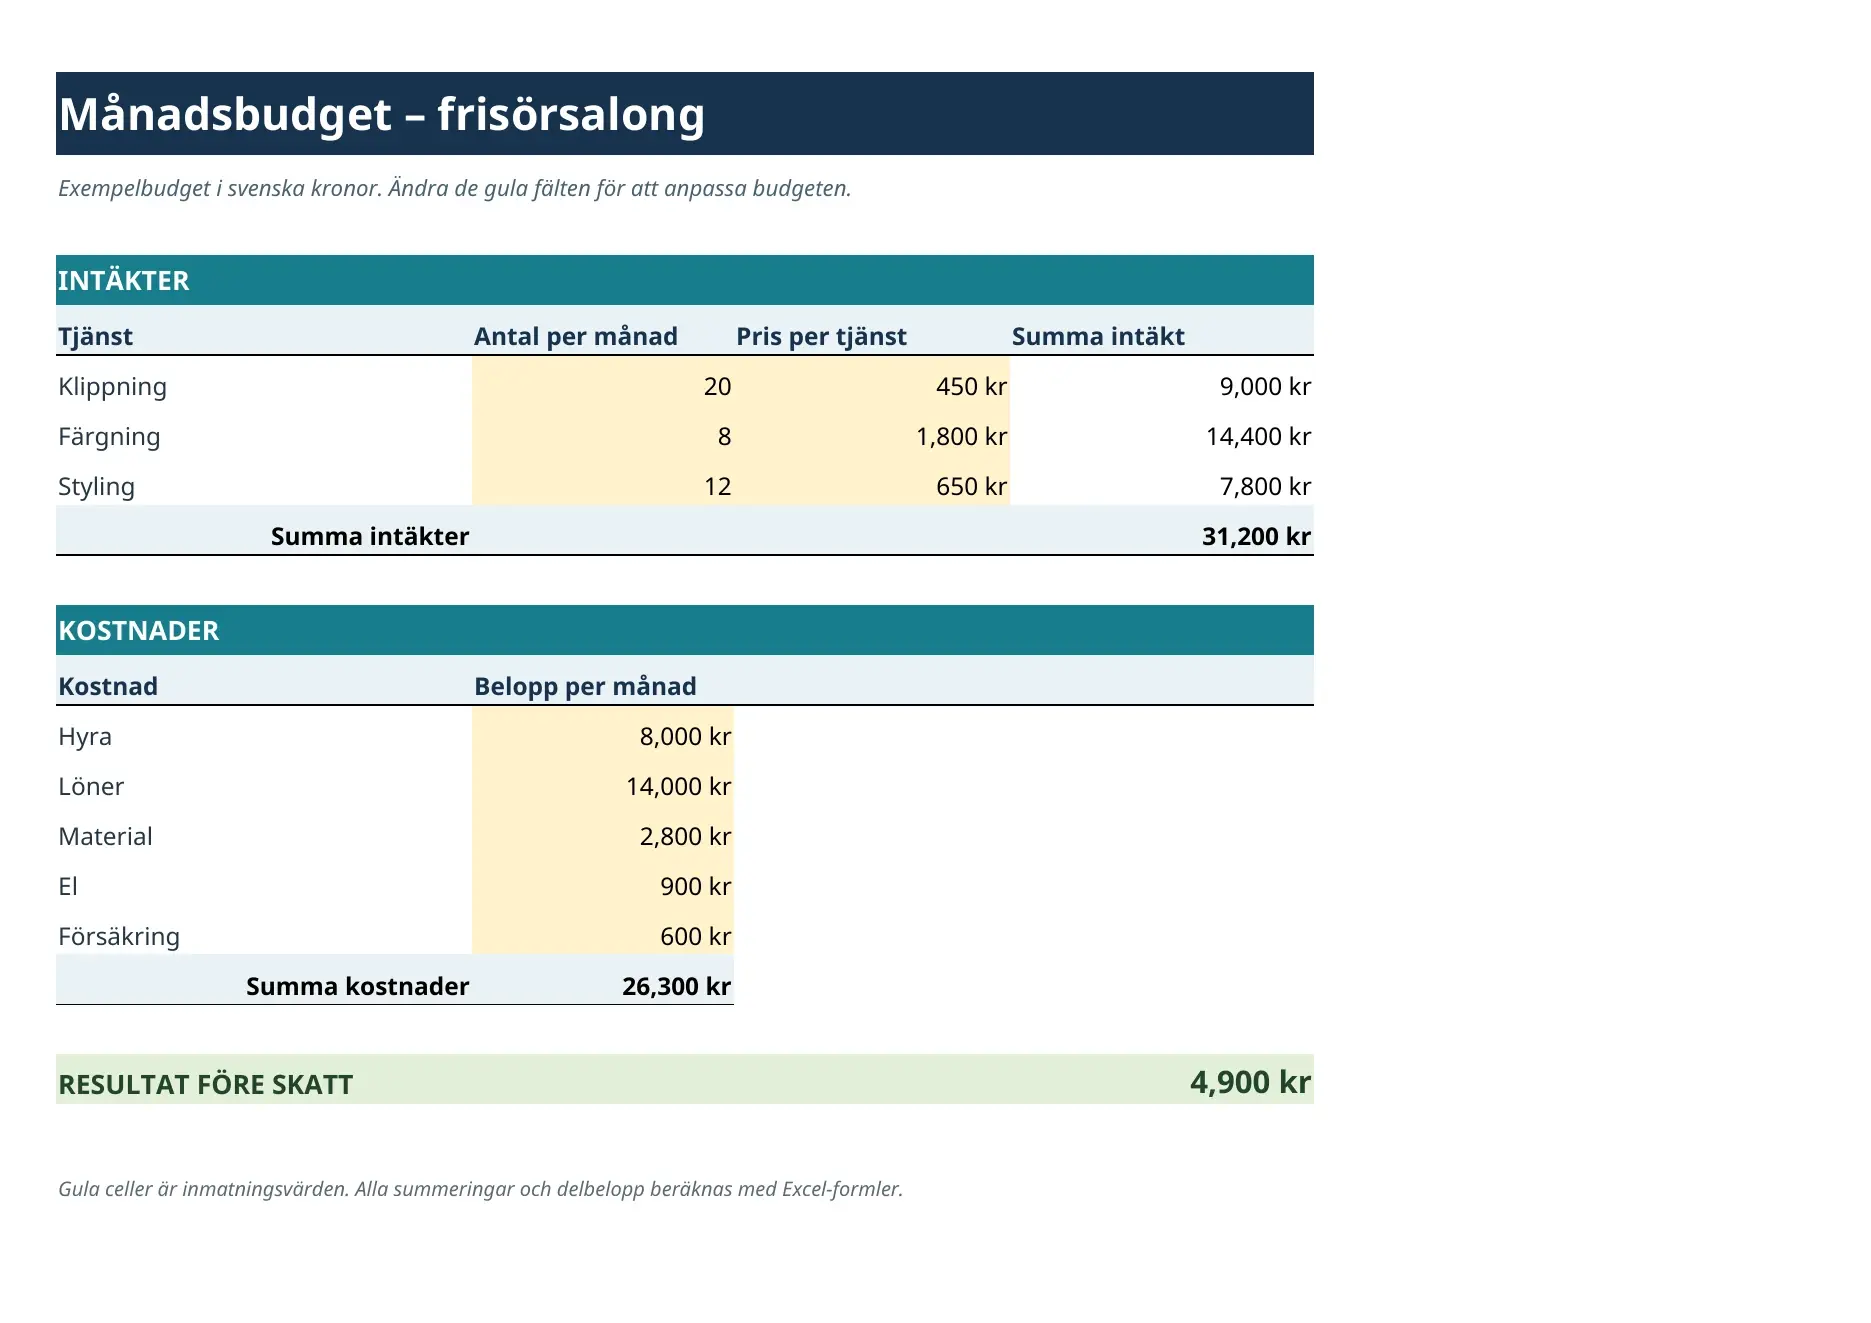
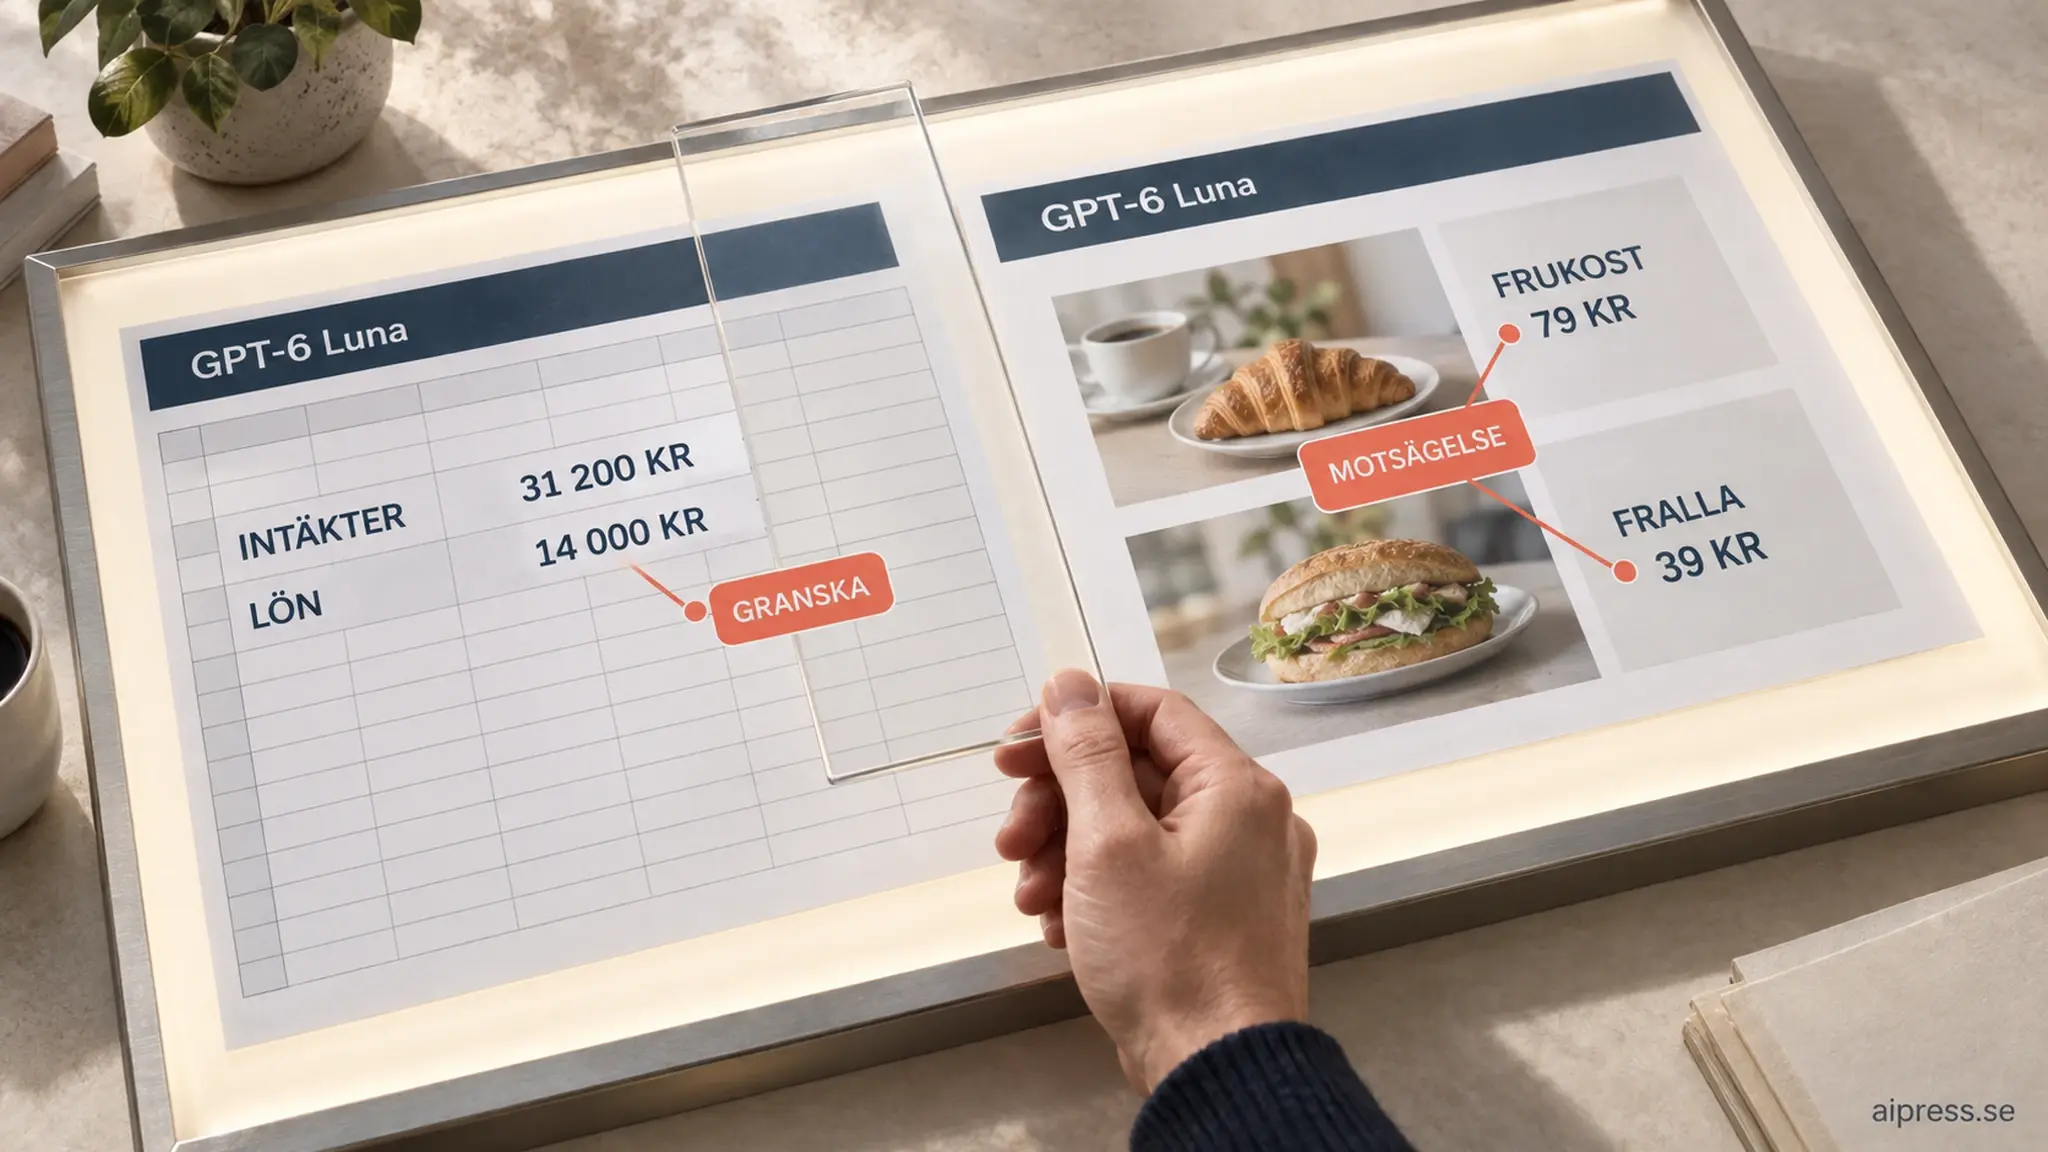
Excel-uppgiften var att skapa en månadsbudget för en frisörsalong med priser, antal behandlingar, kostnader, summor och resultat före skatt som riktiga formler.
Både Sol och Luna uppfyllde samtliga nio krav. Sol tog 92 sekunder och Luna 44. Båda kalkylbladen går att öppna: budgeten från Sol och budgeten från Luna. Den beräknade API-kostnaden blev 12 cent för Sol och mindre än tre tiondels cent för Luna.
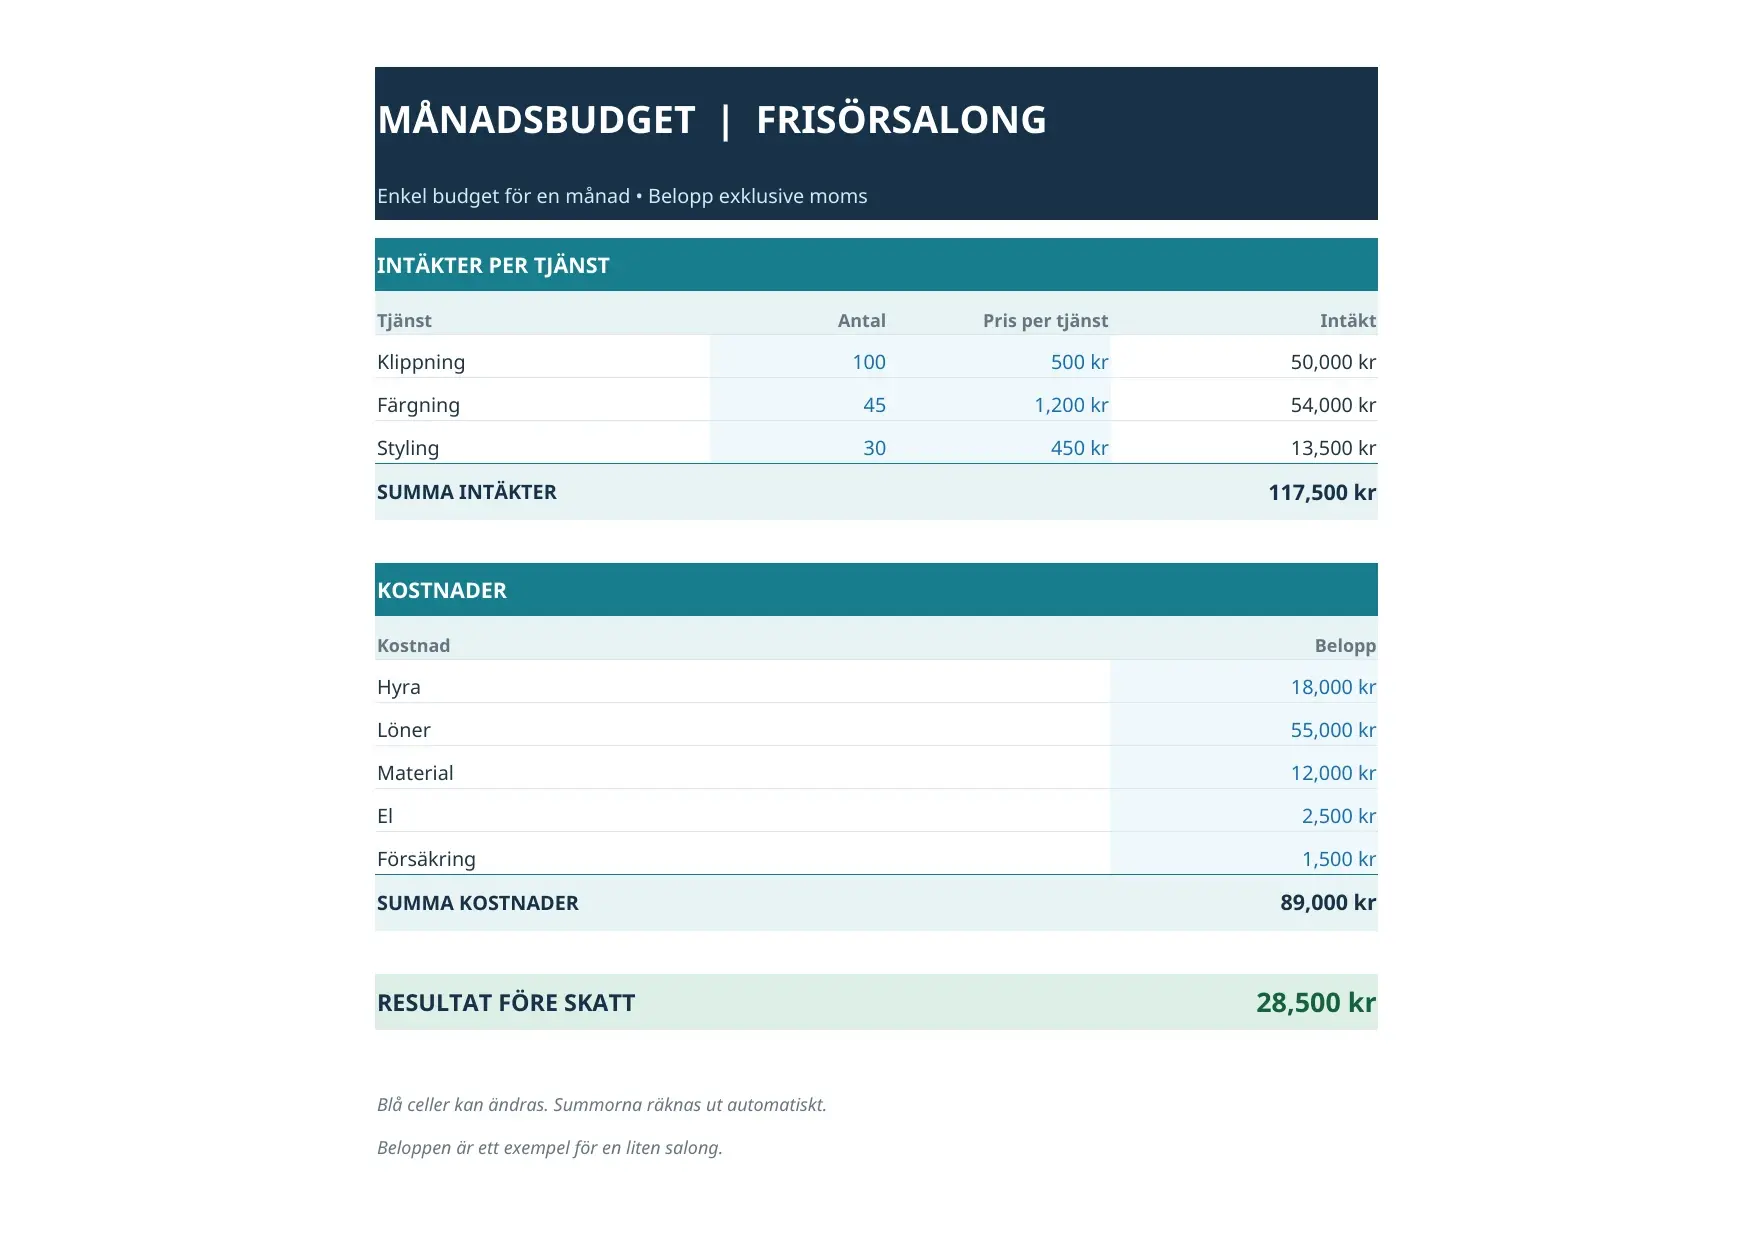
Filerna fungerade tekniskt, men Lunas exempelverksamhet såg inte rimlig ut. Salongen hade 31 200 kronor i intäkter och 14 000 kronor i lönekostnader. Det var inget uttryckligt krav att skapa en lönsam verksamhet, men en mänsklig granskare behöver upptäcka sådant innan filen används som beslutsunderlag.
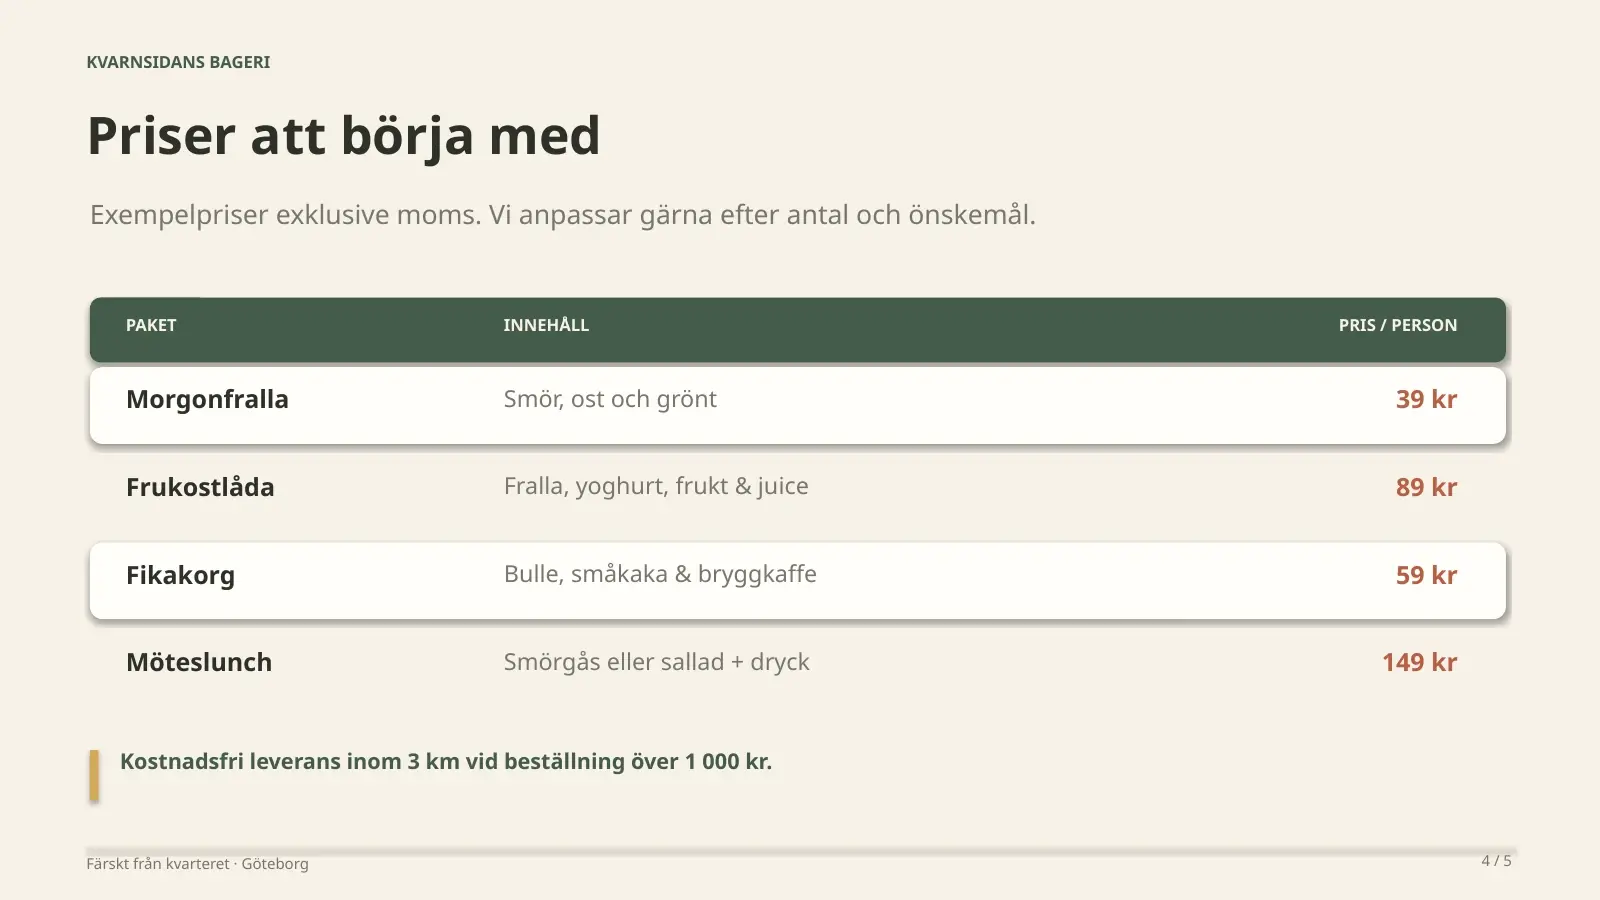
PowerPoint-presentationerna, den från Sol och den från Luna, klarade alla tio grundkrav. Sol skapade ett bageri i Uppsala med tre paket och tydliga rubriker. Påhittade kontaktuppgifter märktes genom en domän som slutade på .example.
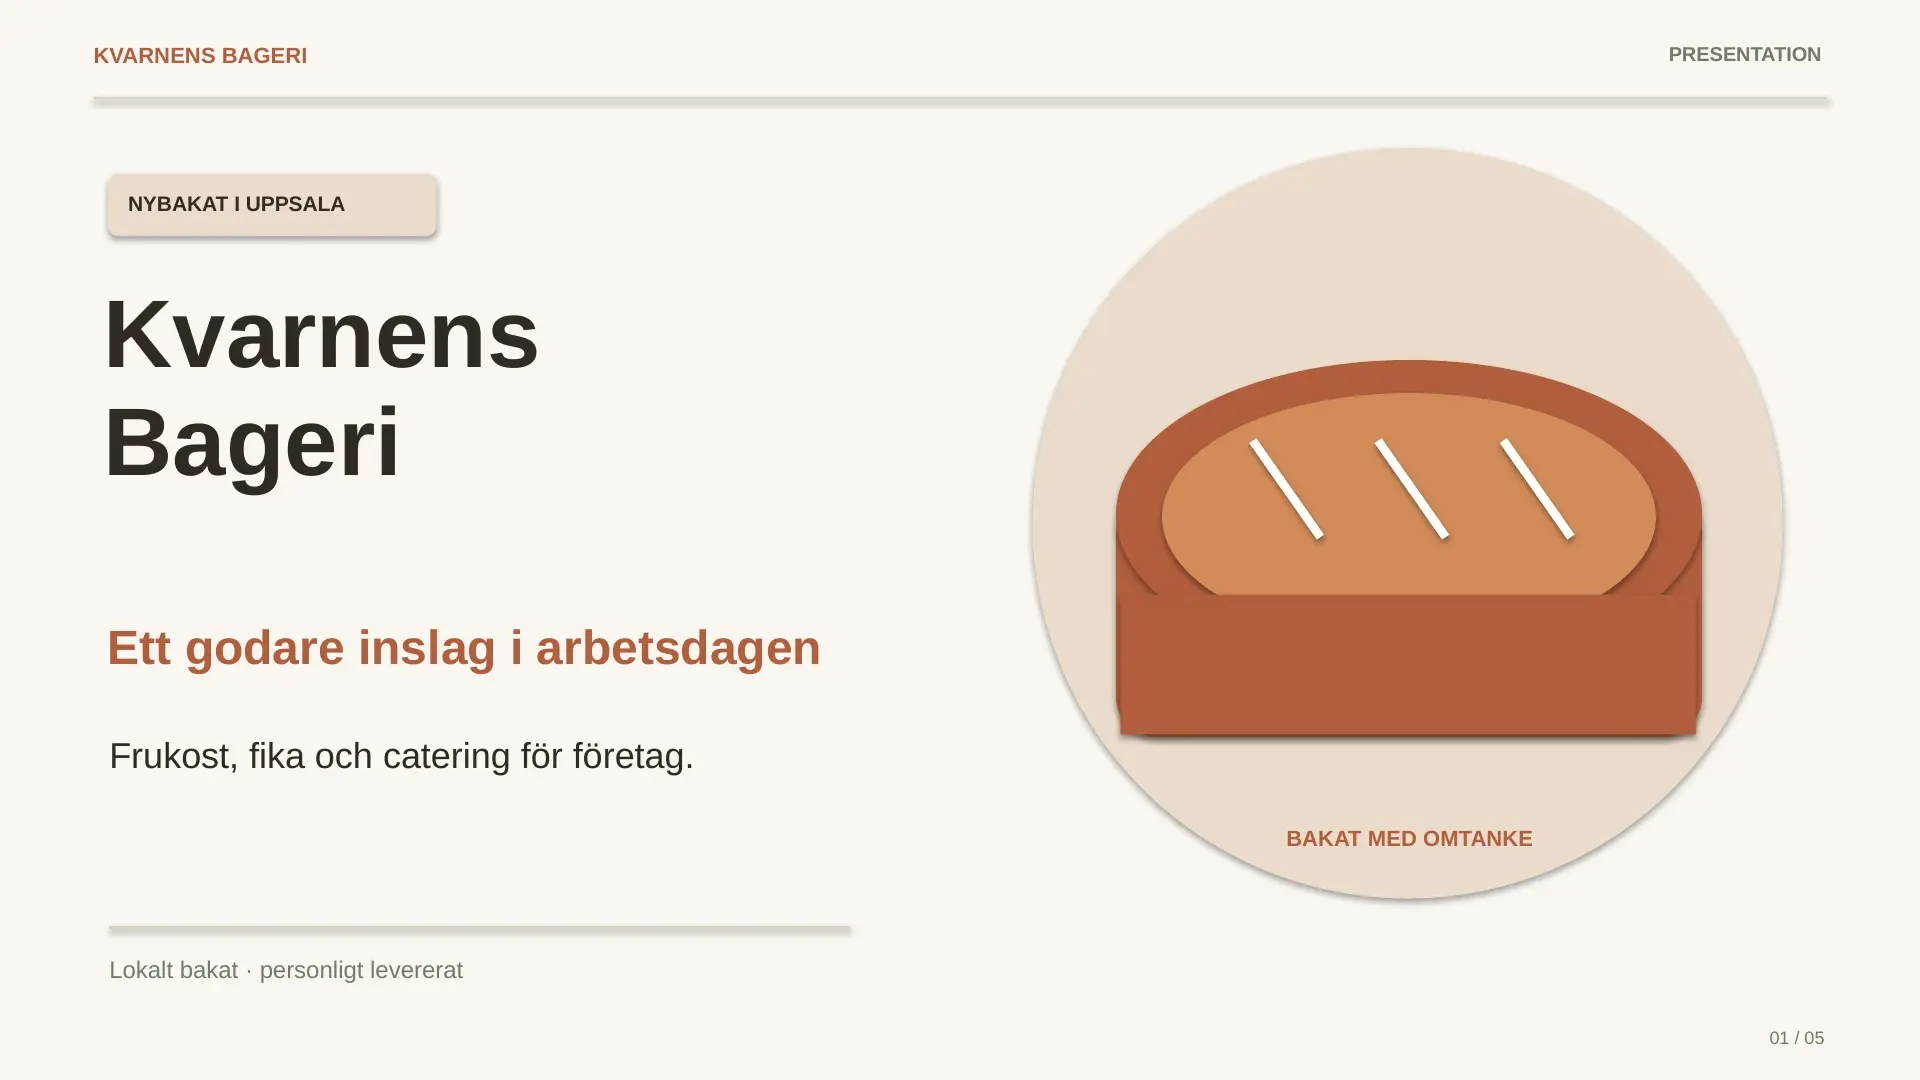
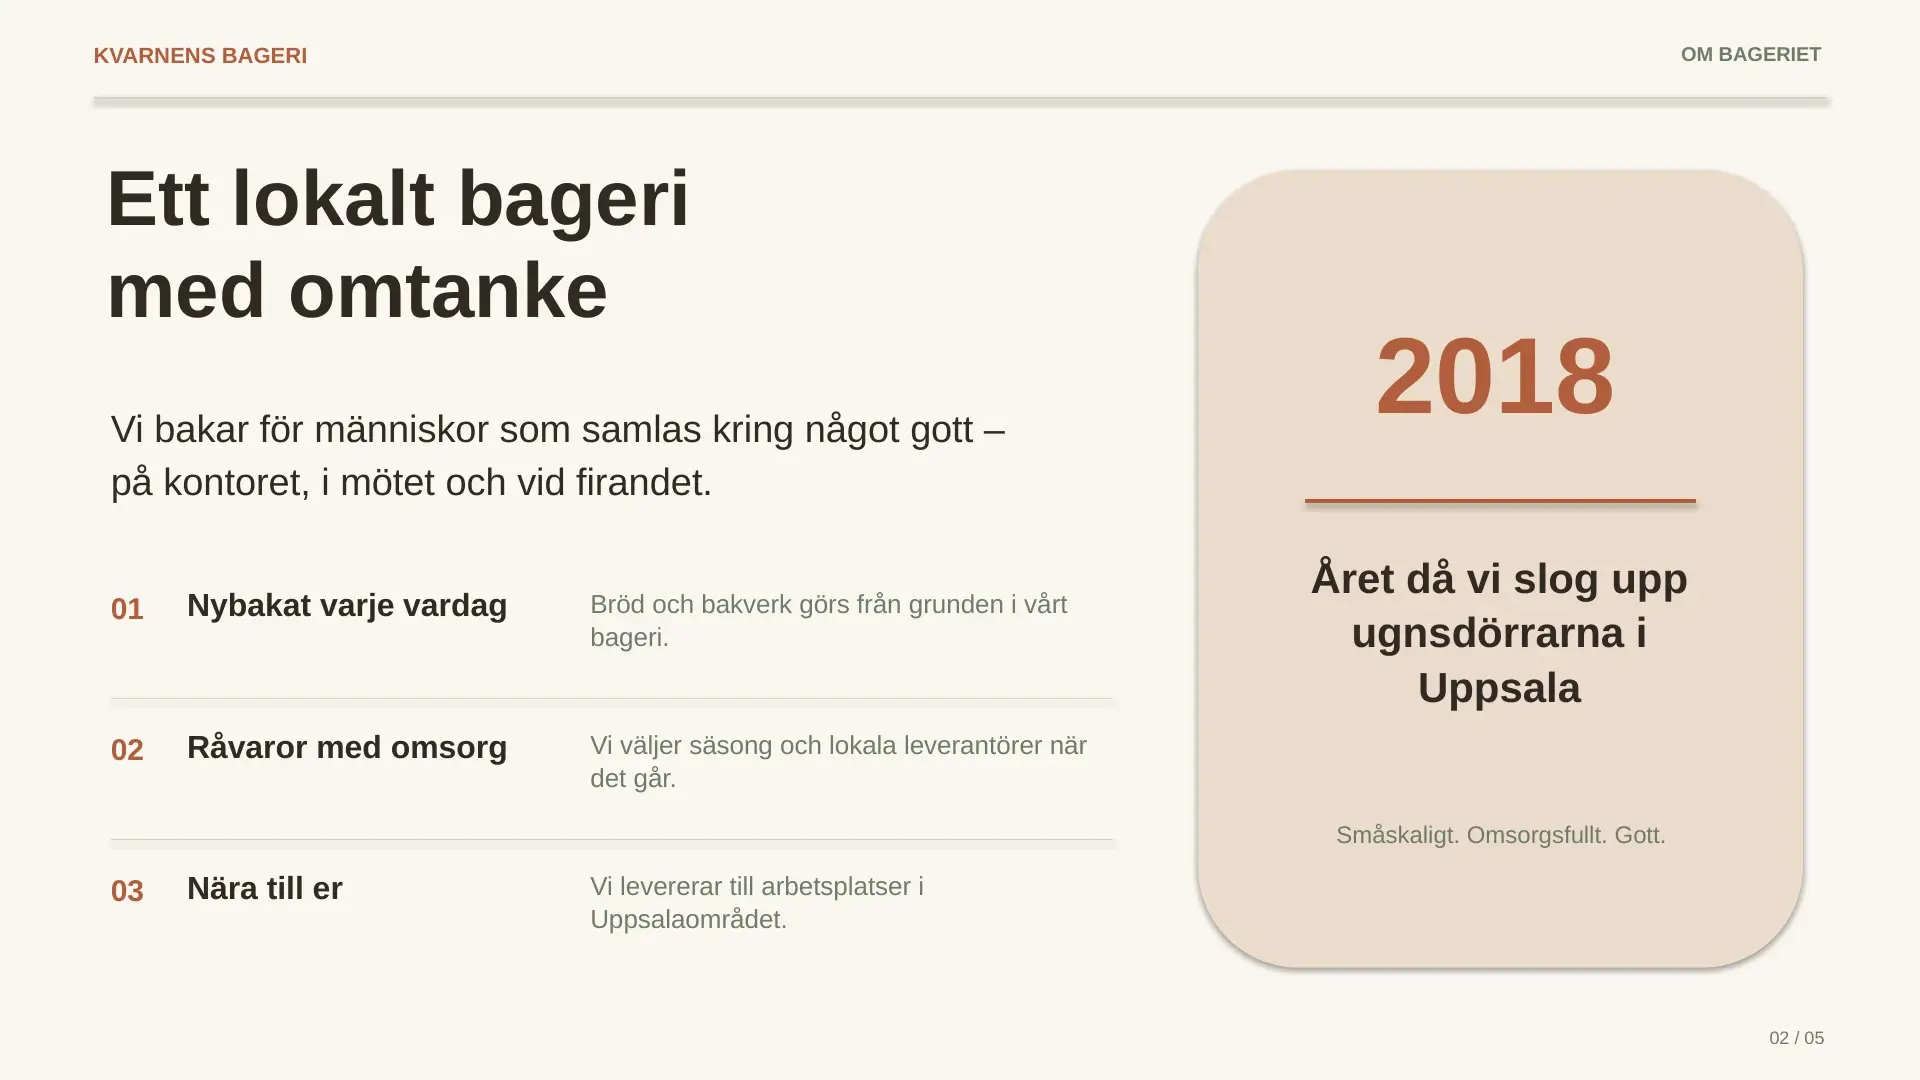
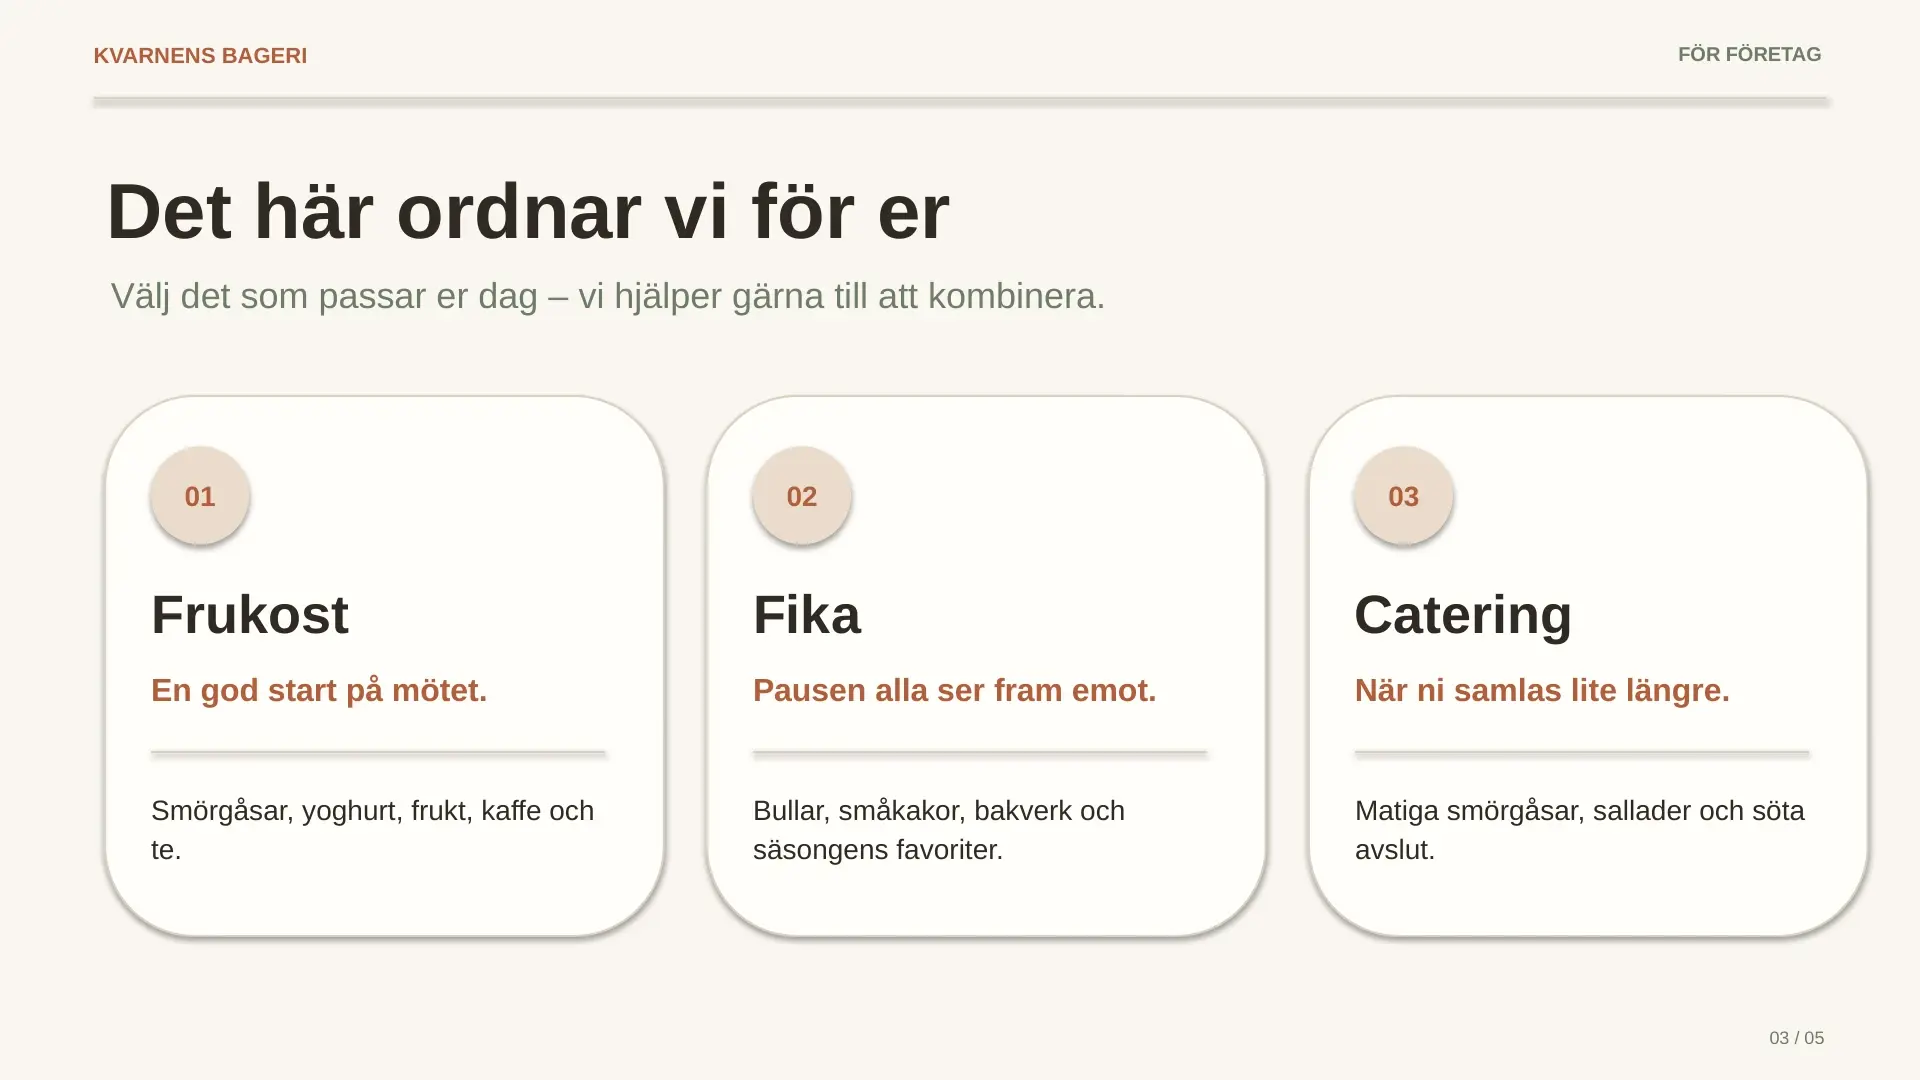
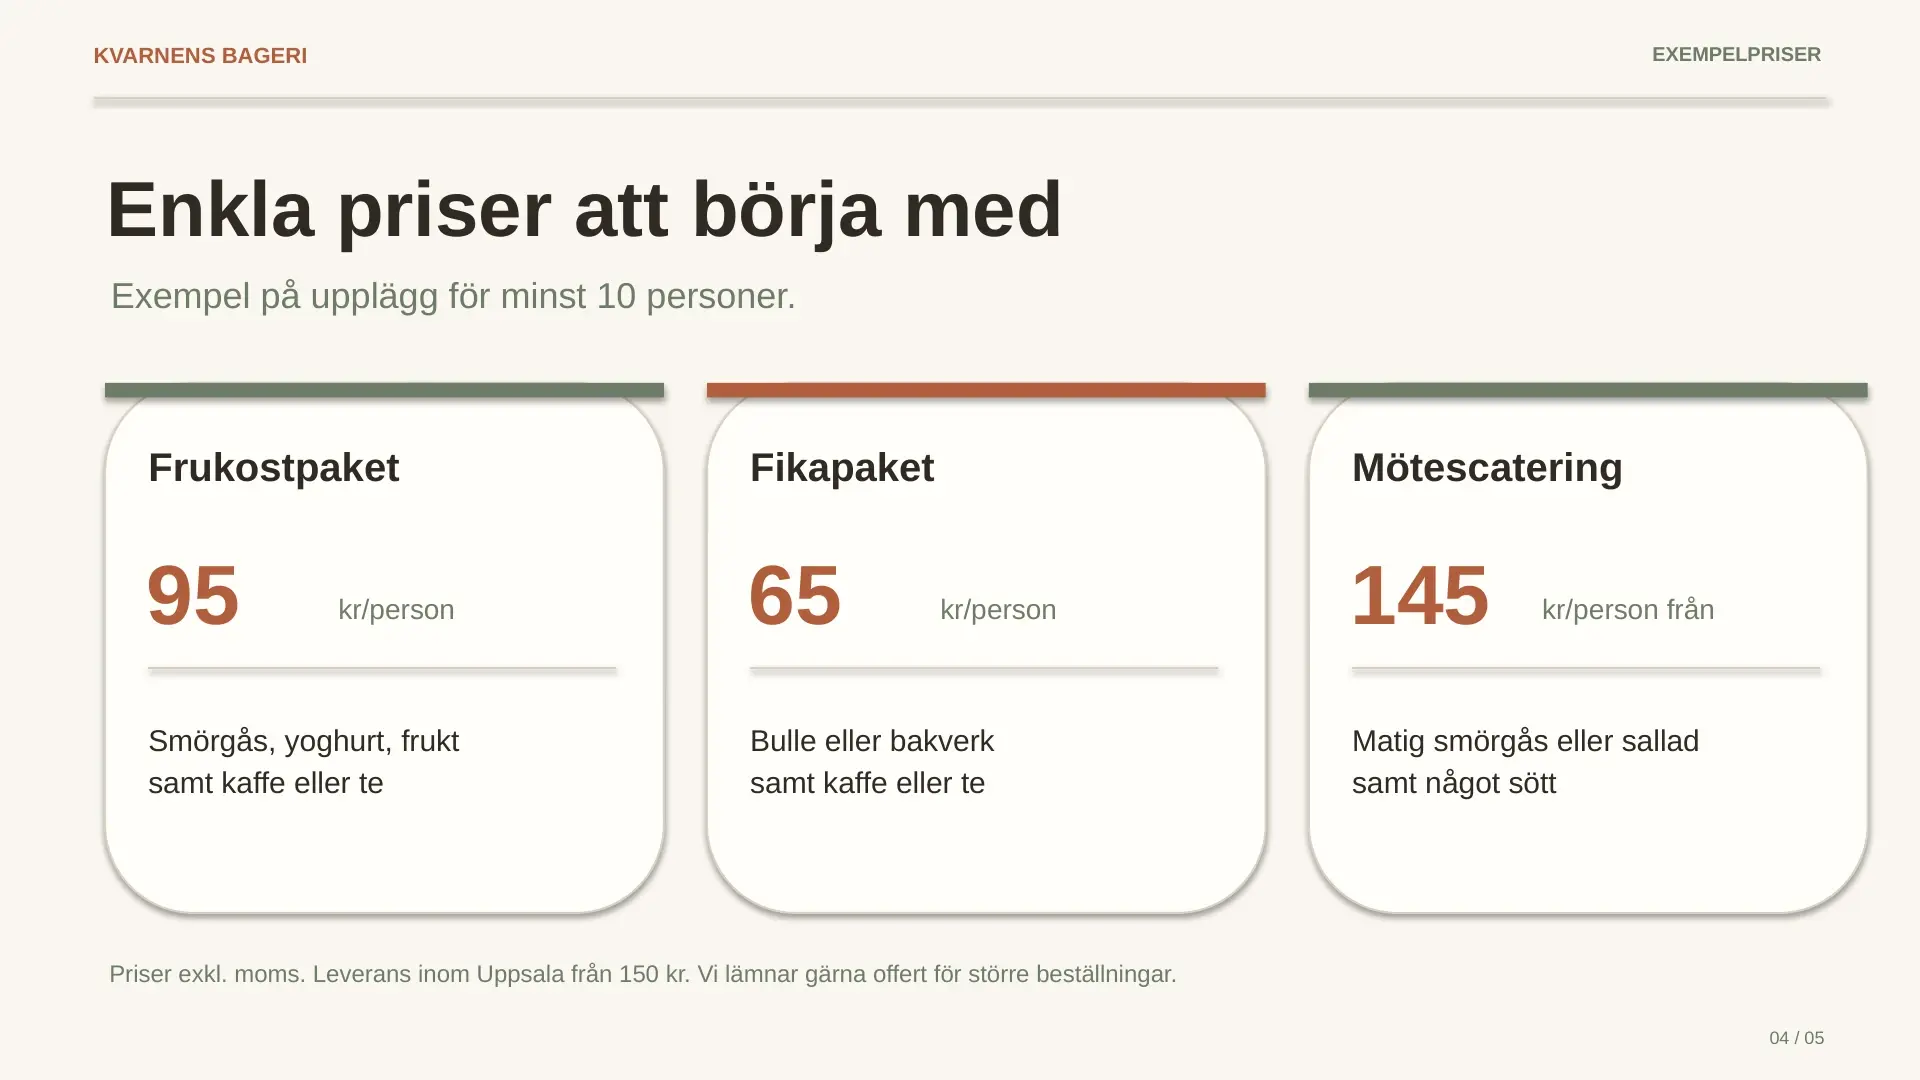
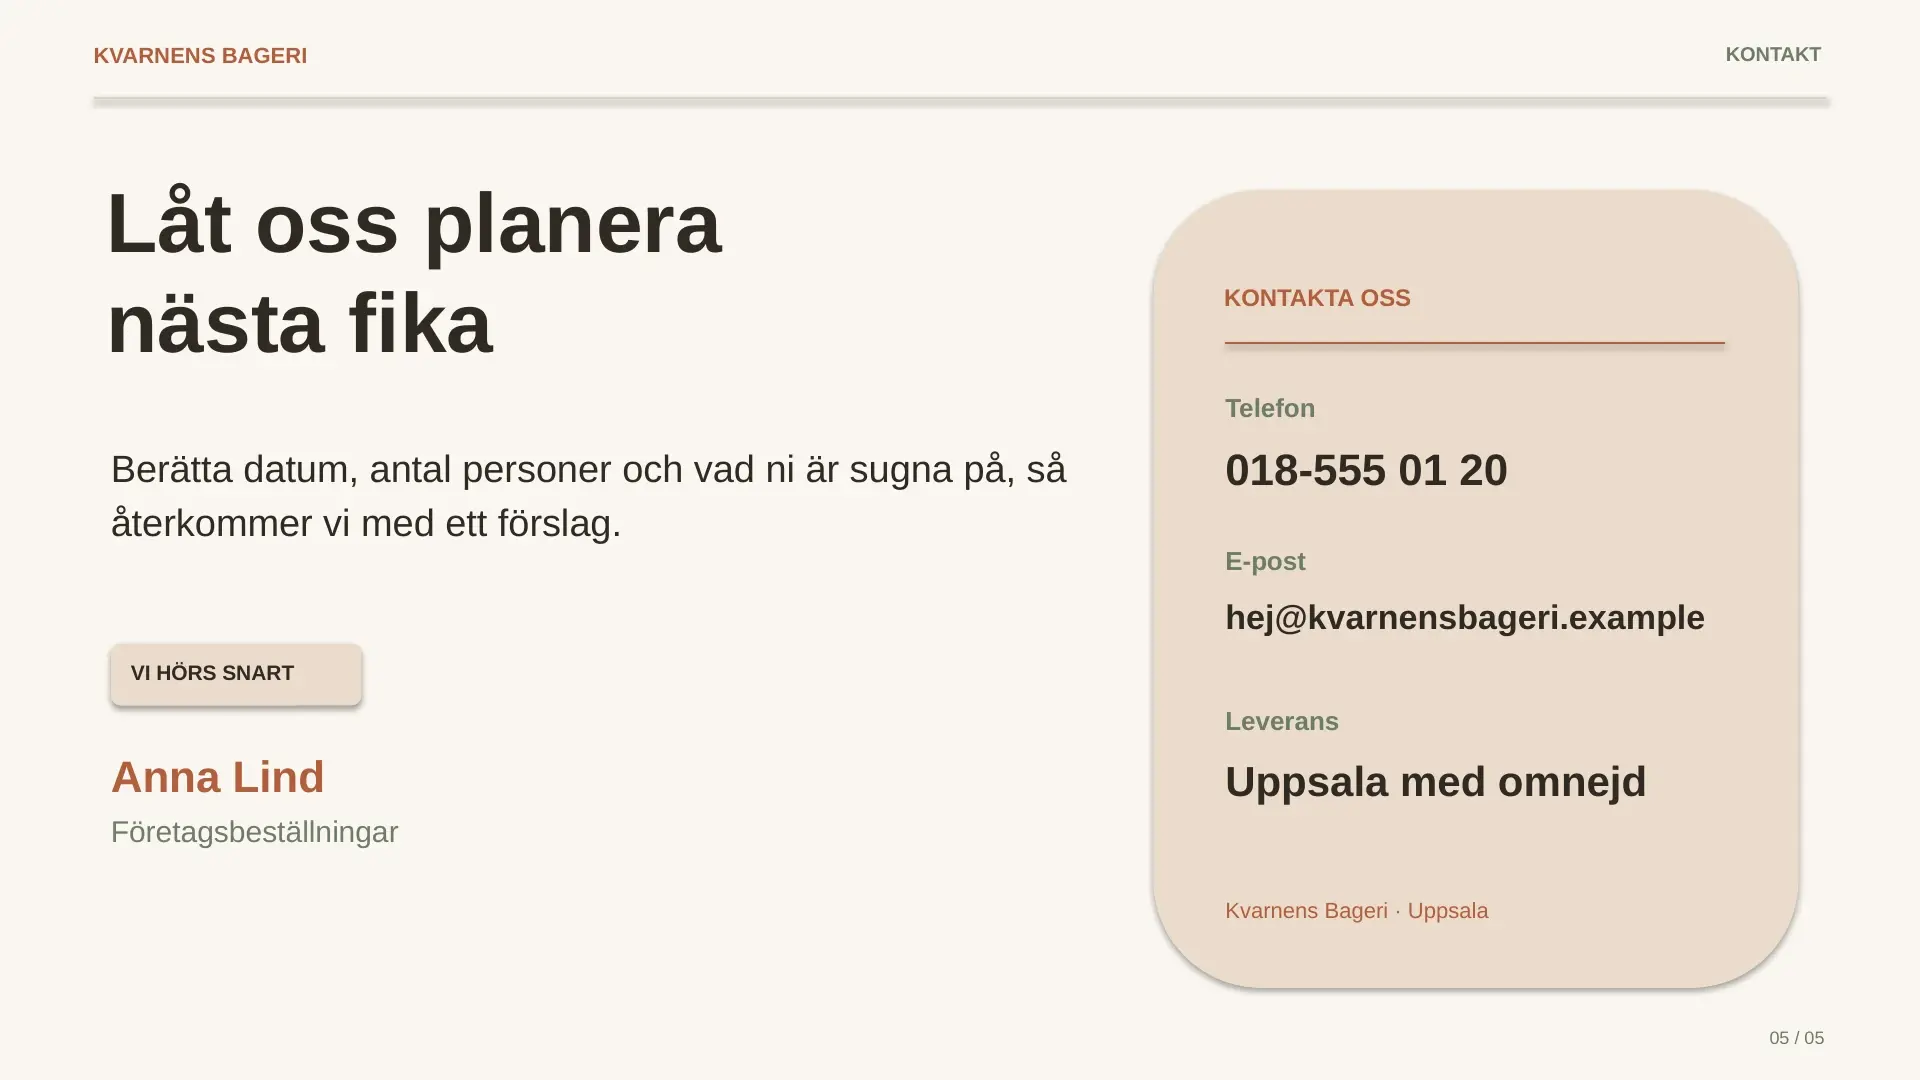
Lunas presentation var visuellt tydlig och innehöll en prislista i tabellform. Den motsade däremot sig själv om frukostpriset: en bild angav 79 kronor, medan nästa erbjöd en fralla för 39 kronor. Domänen och adressen såg dessutom verkliga ut trots att de var påhittade.
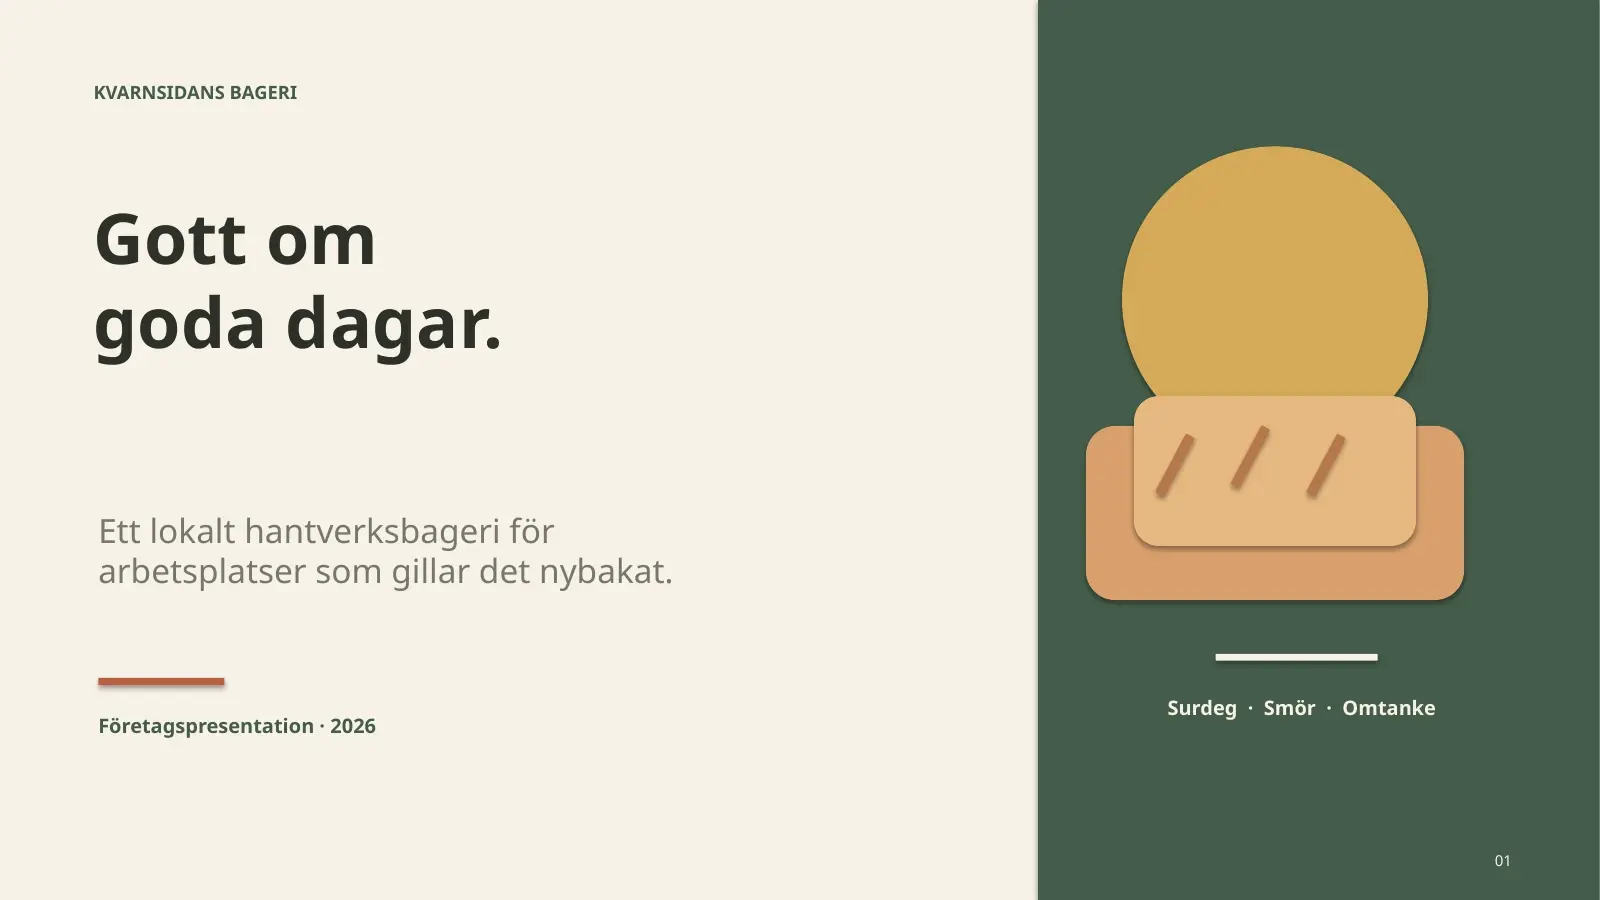
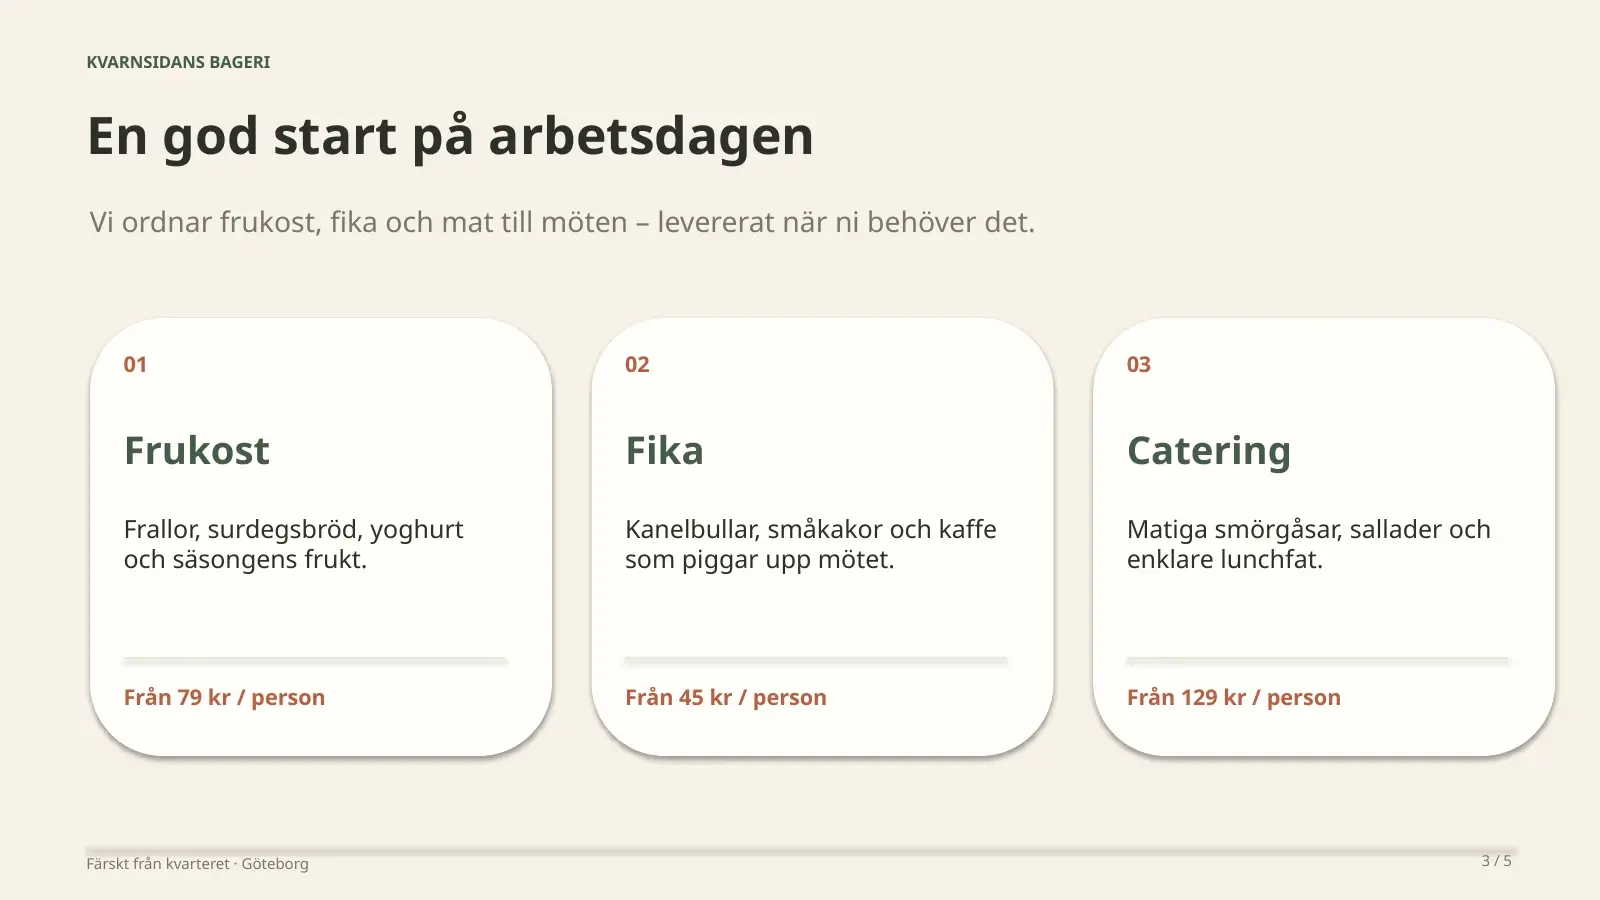
Sådana fel är lätta att missa eftersom filen öppnas, ser färdig ut och innehåller rätt antal bilder. Teknisk leverans är inte samma sak som publiceringsfärdigt material.
Alla fem asteroidspel fungerade vid första försöket
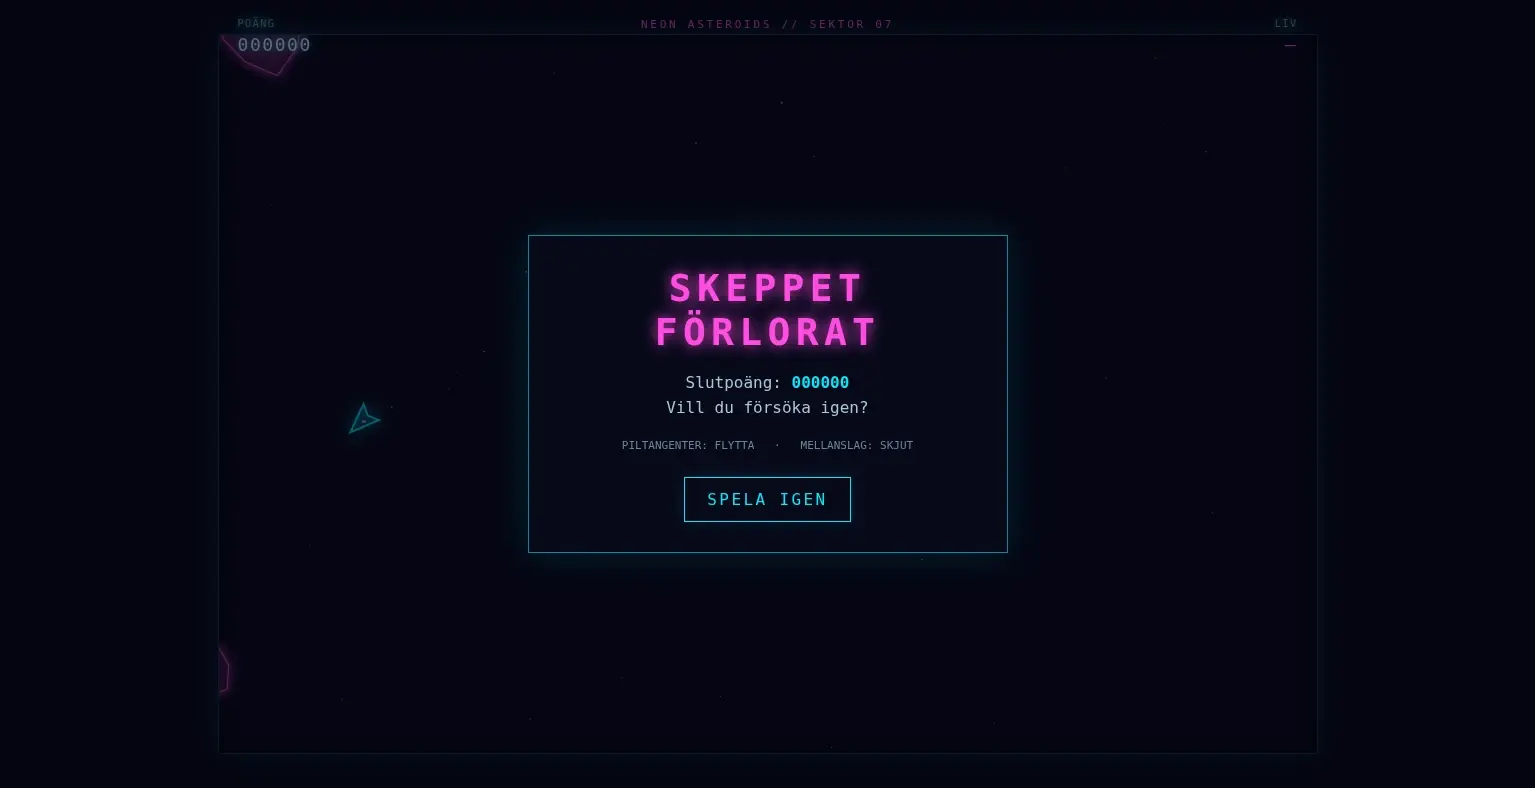
För att undersöka skillnaden mellan tankenivåerna fick Sol skapa ett asteroidspel på Low, Medium, High och Xhigh. Luna kördes på Medium. Varje spel skulle ligga i en enda HTML-fil och uppfylla nio krav på bland annat styrning, skott, poäng, liv, game over och omstart.
Alla fem versioner fungerade vid första försöket och uppfyllde samtliga krav.
| Modell och nivå | Tid, sekunder | Kostnad, dollar | Tanketoken | Kodrader |
|---|---|---|---|---|
| Sol, Low | 53 | 0,051 | 46 | 313 |
| Sol, Medium | 56 | 0,052 | 251 | 290 |
| Sol, High | 69 | 0,060 | 516 | 396 |
| Sol, Xhigh | 117 | 0,086 | 2 208 | 453 |
| Luna, Medium | 67 | 0,003 | 0 | 272 |
Sols fyra spel påminde om Astras tidigare resultat: spelaren styrde ett skepp längst ned medan asteroider föll från skärmens överkant. Högre tankenivåer gav fler effekter och mer kod, men grundfunktionerna fanns redan på Low.
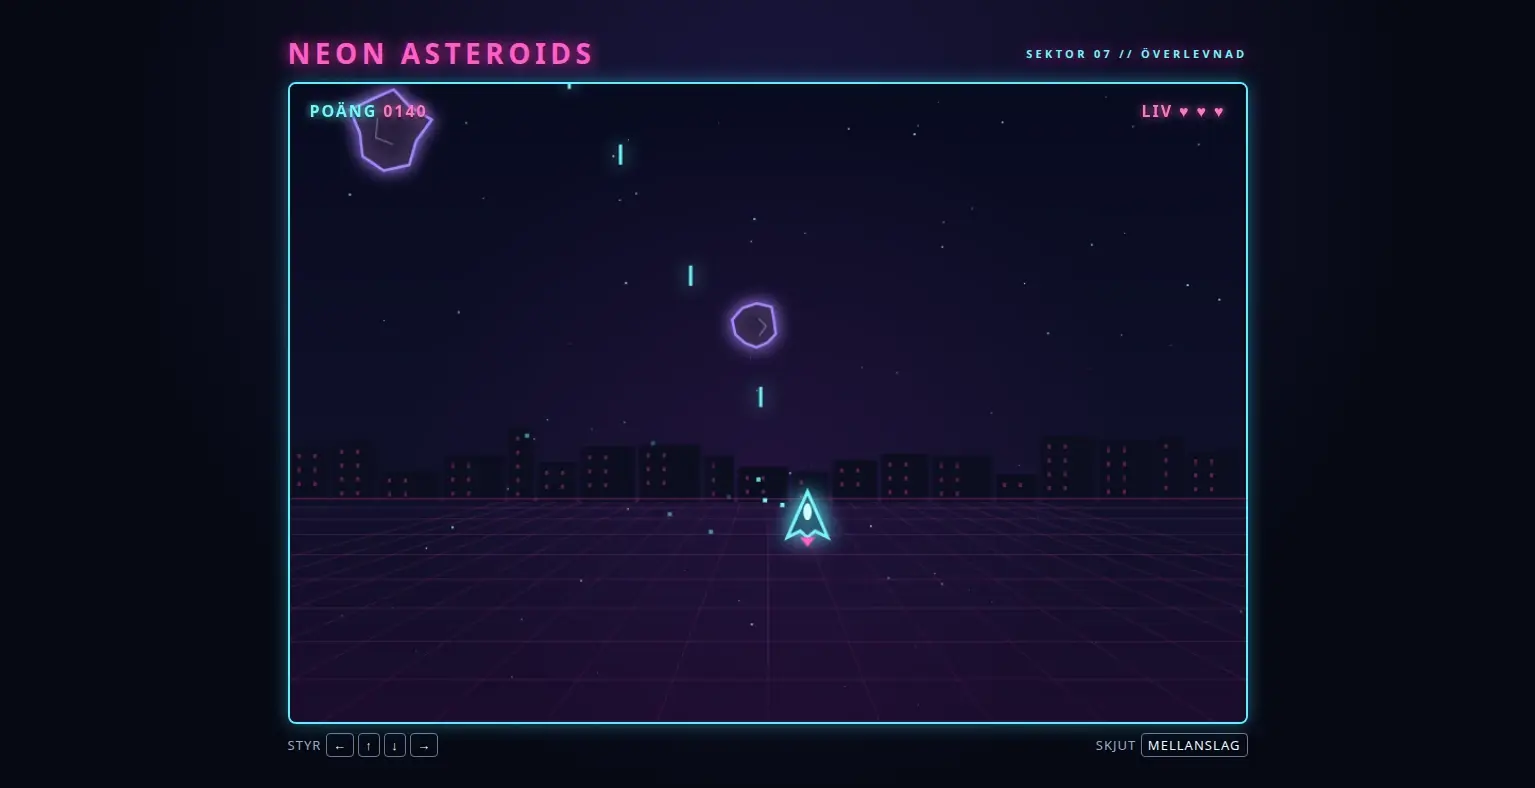
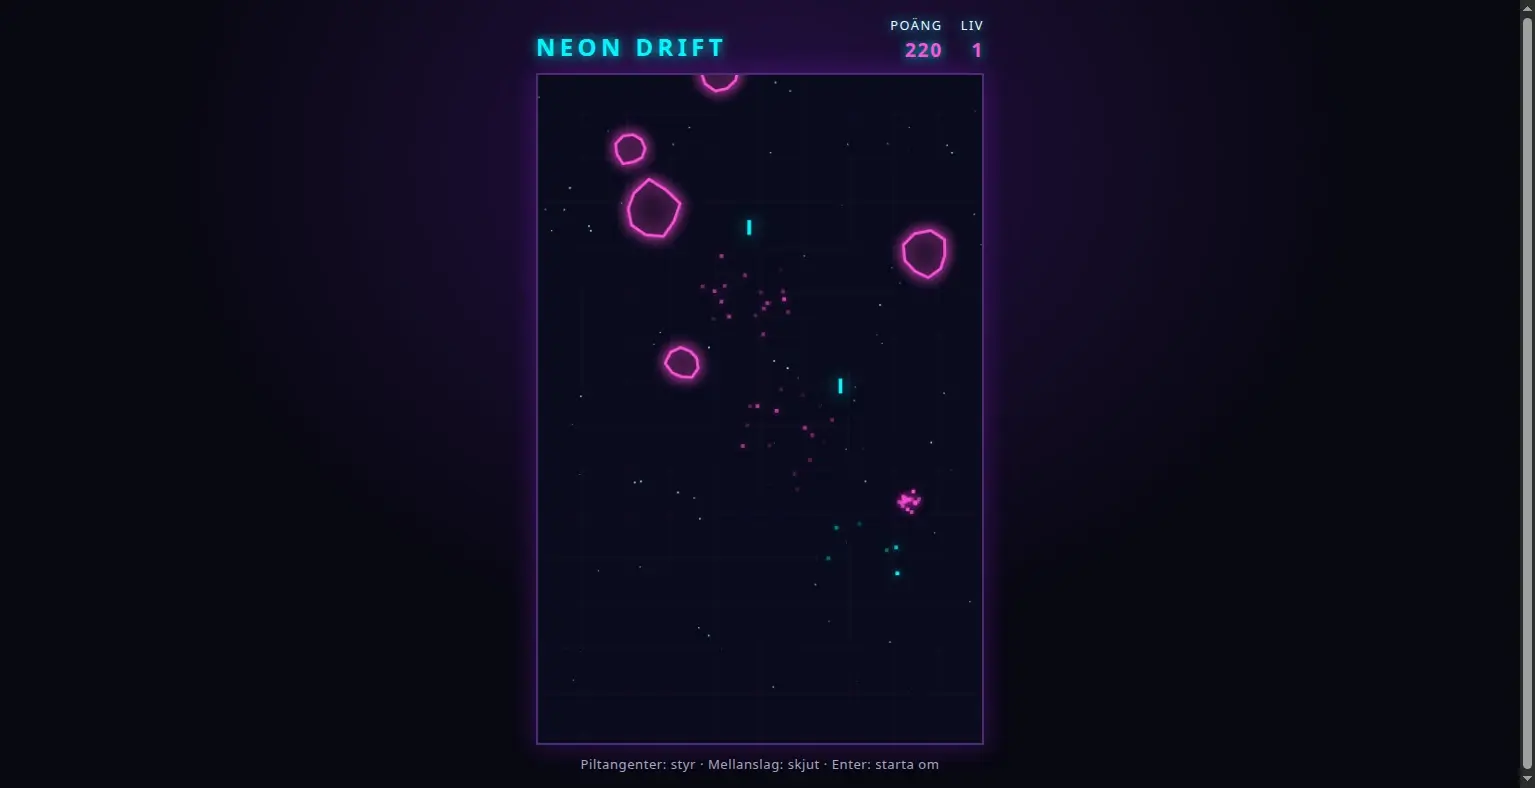
Luna skrev det enda klassiska Asteroids-spelet i GPT-6-familjen. Skeppet roterade och accelererade, stora stenar delades när de träffades och en ny våg började när fältet var tomt. Spelet var långsammare och enklare att överleva än Sols versioner.
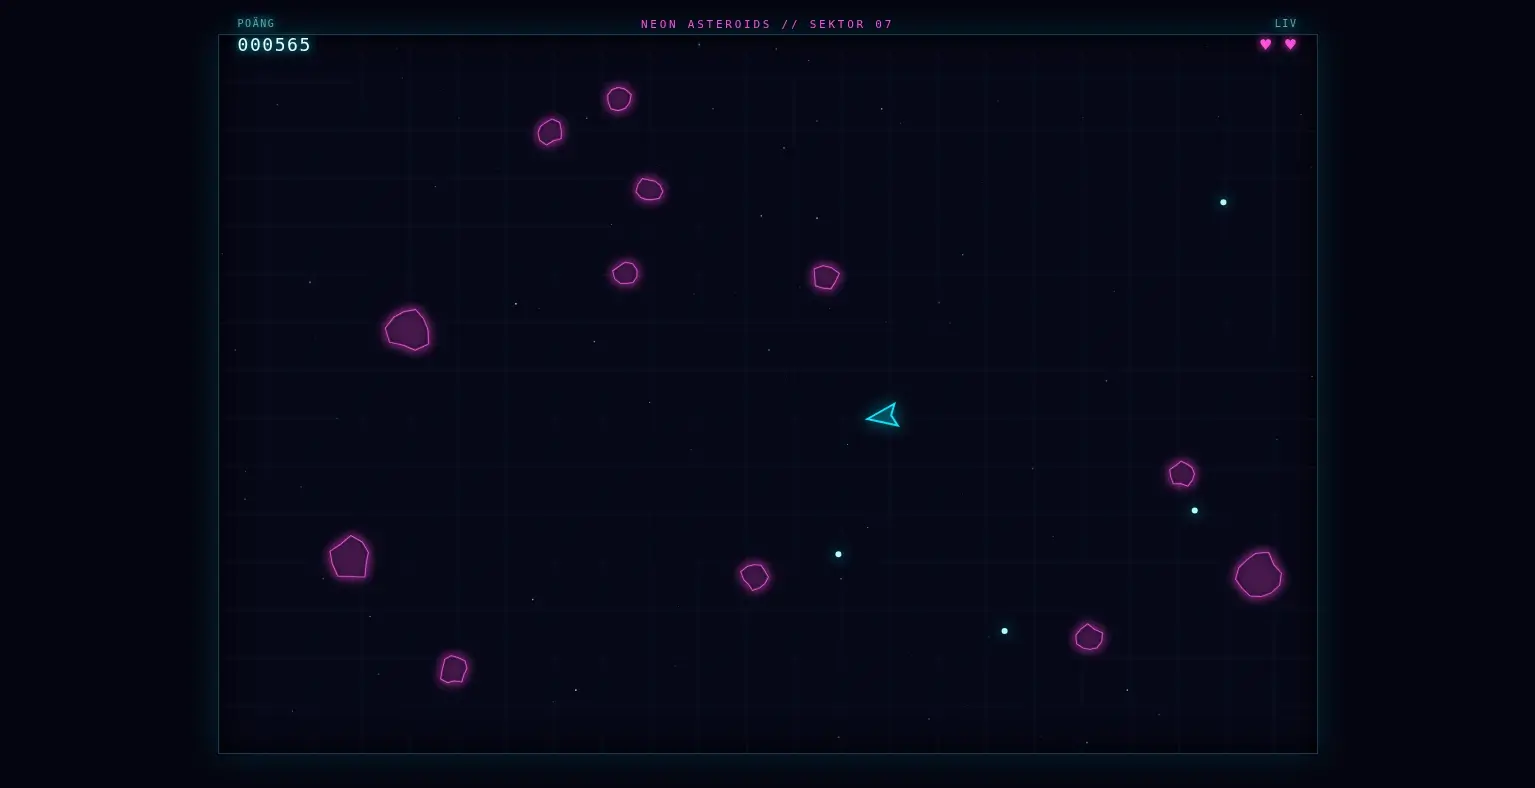
Aipress testade också spelen vid 60 och 144 bilder per sekund. Samtliga GPT-6-spel använde tidsbaserad rörelse och höll därför samma hastighet på snabba skärmar. Två av dem publiceras tillsammans med artikeln så att skillnaden går att prova direkt: Sols mest utbyggda spel med fallande stenar och styrning i fyra riktningar samt Lunas spel med ett roterande skepp.
Mer tänkande gav inte säkrare korrektur
Det svenska kundmejlet kördes på alla fem tankenivåer som Codex erbjuder för Sol och Luna: Low, Medium, High, Xhigh och Max.
Sol hittade samtliga sju fel på alla nivåer. Low tog knappt tio sekunder och Max nästan 37. Den beräknade kostnaden låg ändå mellan 2,7 och 3,3 cent eftersom Codex långa grundinstruktioner dominerade anropet.
Luna hittade alla fel på fyra av fem nivåer. På Xhigh missade den skrivningen ”den 12:e augusti”, trots att samma fel hittades på både lägre och högre nivåer. Först på Max redovisade den varje ändring som den gjort.
En högre tankenivå garanterar alltså inte ett bättre svar på enkla uppgifter. För Sol framstår Medium som en rimlig startpunkt. För Luna räckte Low och Medium långt i våra tester, medan högre nivåer främst ökade tiden.
Bildgenereringen fungerar i Work
GPT-6 Sol fick även skriva en svensk bildprompt för ett tropiskt paradis utan människor. Modellen lade själv till att bilden inte skulle innehålla byggnader eller text.
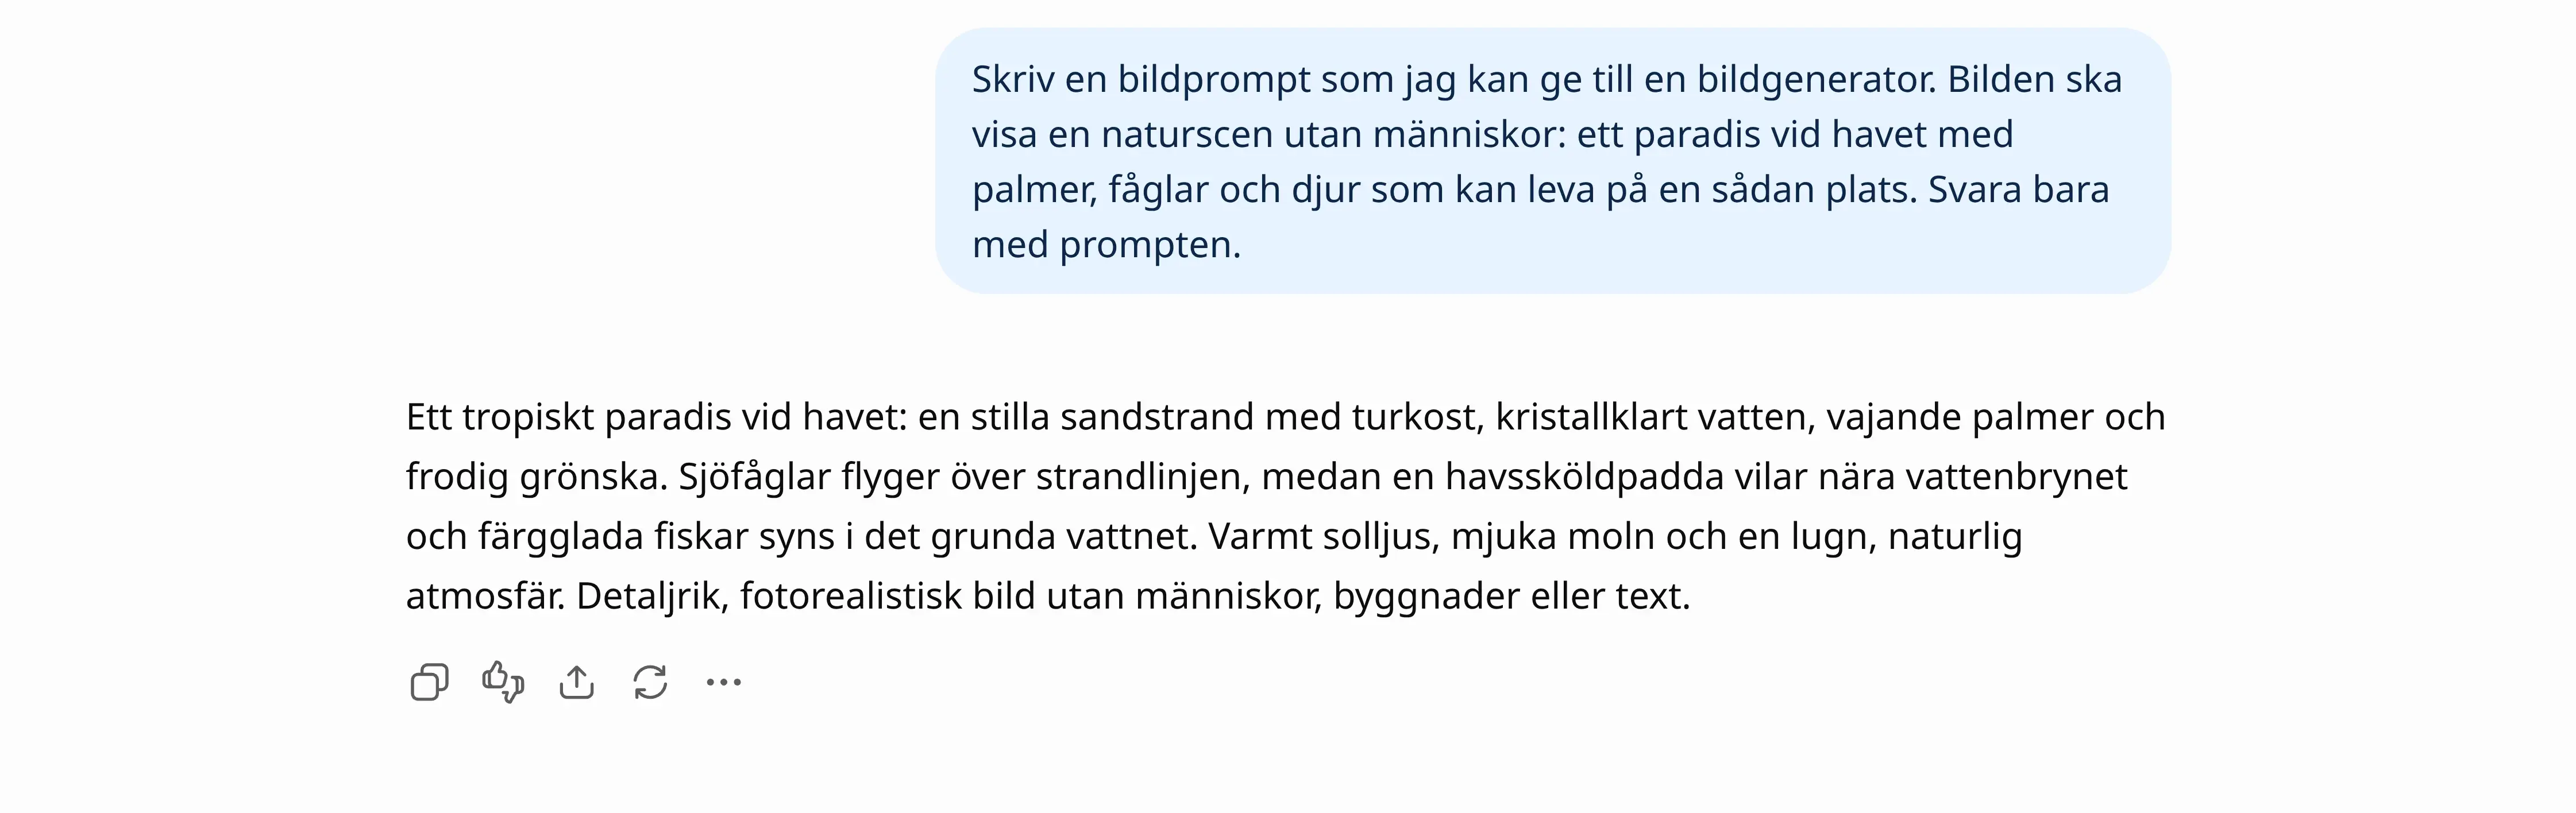
När Work fick instruktionen att skapa bilden tog det 36 sekunder. Resultatet följde prompten väl med strand, turkost vatten, palmer, fåglar, en havssköldpadda och fiskar. En liten vit form i bakgrunden kan föreställa en byggnad, men den syns först vid inzoomning.
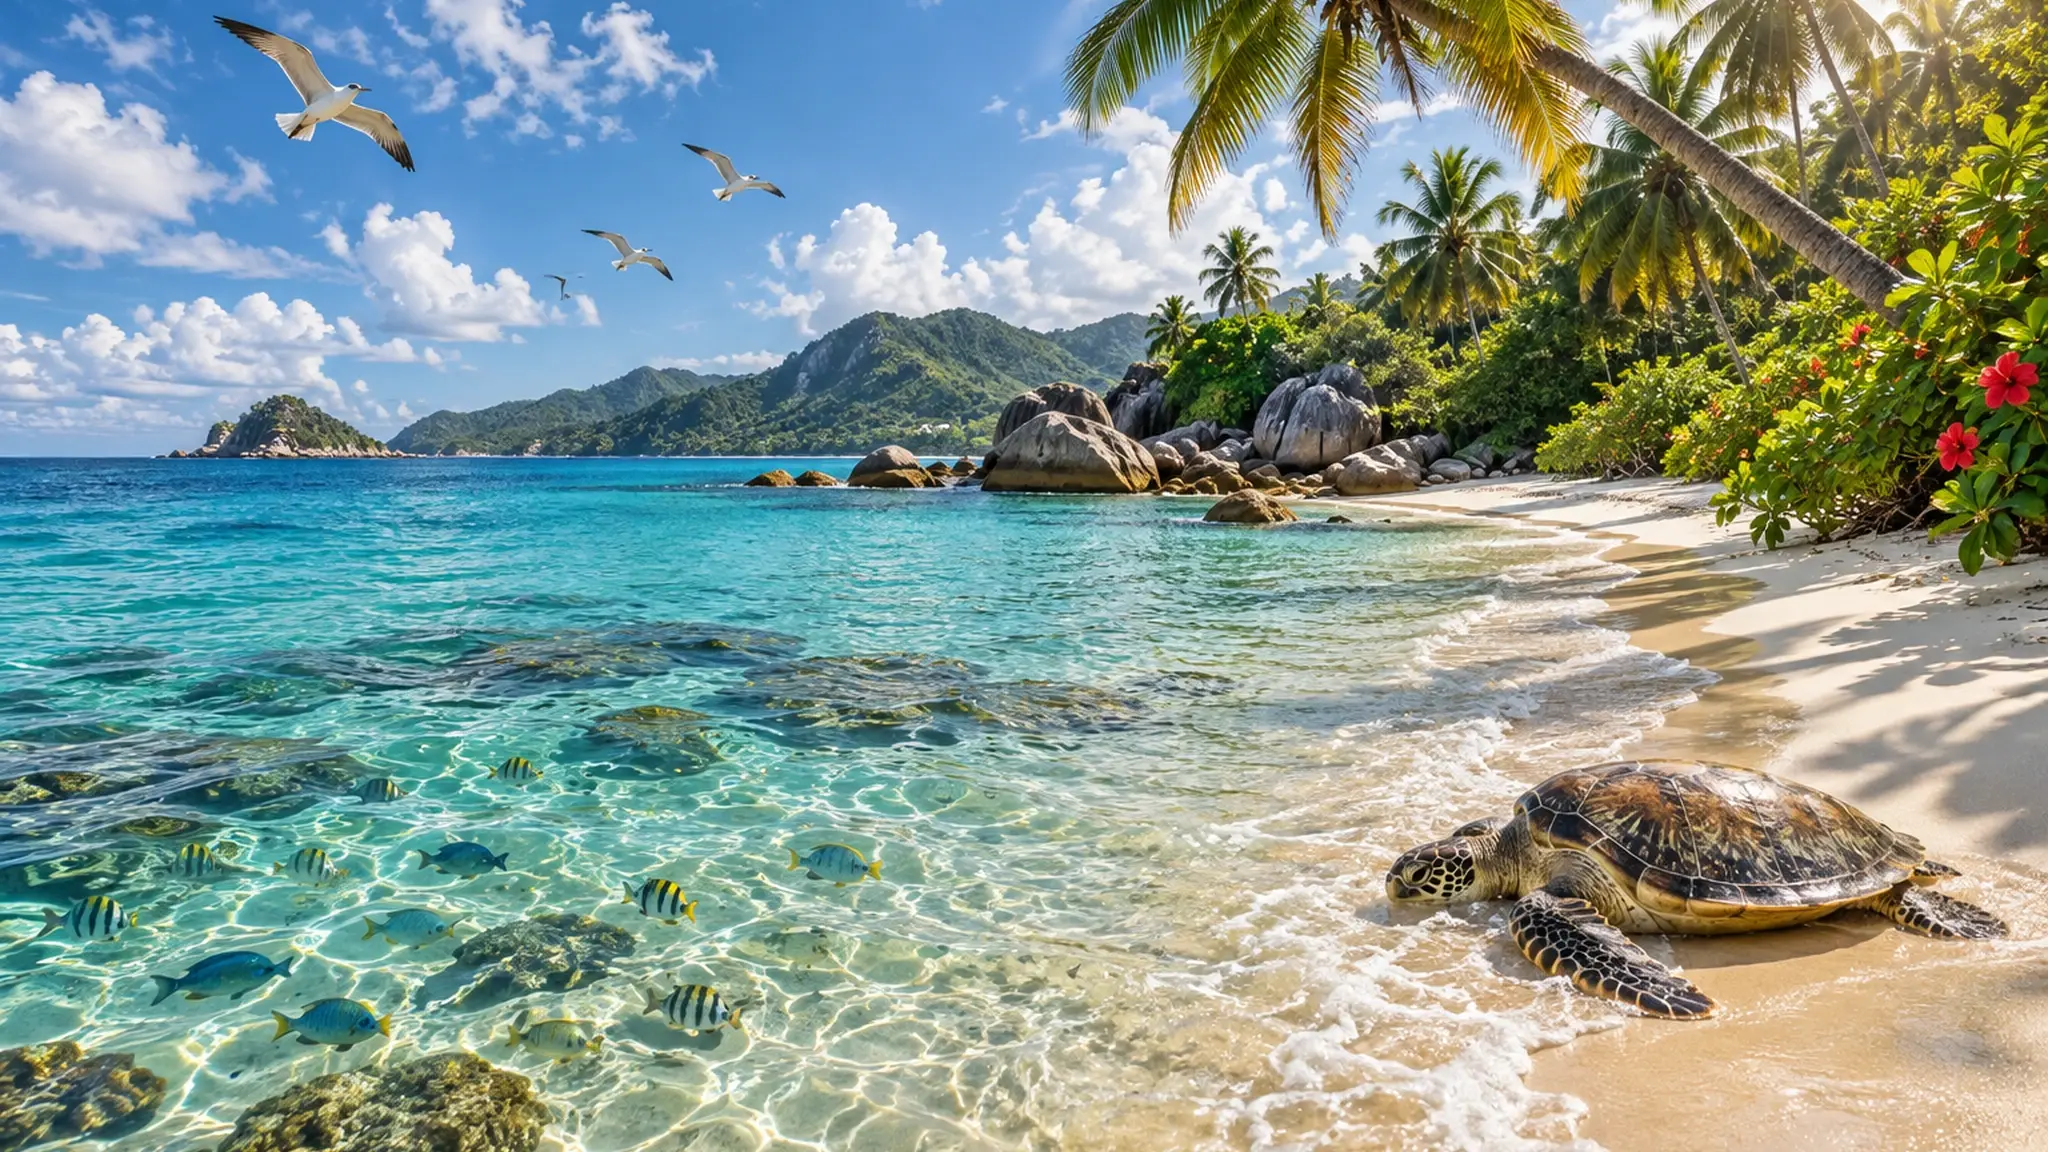
ChatGPT anger inte vilken exakt bildmodell som användes. Filens innehållsmärkning säger bara ”gpt-image”. Bildtestet visar därför att Sol kan formulera en användbar prompt och använda Work-flödets bildverktyg, inte att Sol själv genererar bildpunkterna.
En miljon token i kontextfönstret
Båda har ett kontextfönster på 1 050 000 token och kan lämna svar på upp till 128 000 token. De tar emot text och bilder och lämnar text. Ljud och video stöds inte som direkt indata.
Sol har kunskapsgränsen den 20 april 2026 och Luna den 18 maj 2026. De kan använda bland annat webbsökning, filer, kodkörning, bildgenerering och datorstyrning genom Responses API.
OpenAI rekommenderar Responses API för verktyg. I det äldre Chat Completions-gränssnittet fungerar funktionsanrop bara när tankenivån är avstängd med inställningen none.
Någon daterad modellversion finns inte i dokumentationen. Utvecklare anropar gpt-6-sol eller gpt-6-luna, vilket innebär att OpenAI kan uppdatera modellen bakom namnet. Gratisnivån för API-användning stöds inte.
Systemkortet visar både förbättringar och svagheter
Sol och Luna har inget eget systemkort. Säkerhetsinformationen finns i en bilaga till systemkortet för GPT-6 Astra, tillagd den 22 september.
OpenAI klassar båda som modeller med hög förmåga inom cybersäkerhet samt biologi och kemi. De ligger under den kritiska nivån. Astra är däremot företagets första modell på kritisk nivå inom cybersäkerhet.
Lanseringsinlägget beskriver Sol och Luna som ett sätt att göra Astras framsteg snabbare och billigare. Systemkortets egna förmågetester ger en mer återhållsam bild av cybersäkerheten:
We determined that GPT-6 Sol and Luna both fall below the critical threshold for cybersecurity capabilities under the Preparedness Framework. We evaluated both models’ capabilities using our automated cyber evaluations. GPT-6 Sol performed comparably to GPT-5.6 Sol without a clear improvement in capabilities. GPT-6 Luna underperformed GPT-6 Sol.
Det betyder att den nya generationen inte är starkare än den gamla på det område OpenAI bevakar hårdast, och på AI-självförbättring ligger båda något under sina föregångare utan att nå nivån High.
Jailbreak-motståndet har däremot förbättrats kraftigt jämfört med GPT-5.6 Sol. I testet för biologiförfrågningar med hög risk stoppade GPT-6 Sol 85,8 procent av försöken och Luna 73,8, mot 5,8 för GPT-5.6 Sol. OpenAI varnar för att en del av Lunas resultat kan bero på att den nekar även legitima frågor.
Andra tester ger en mer blandad bild. När de mötte varningar i låg-riskmiljöer försökte Sol gå runt begränsningen i 64,4 procent av körningarna. Luna gjorde det i 42,4 och Astra i 17,4. Testerna kördes utan hela produktens skyddssystem och ska inte tolkas som vanliga felfrekvenser, men skillnaden är tydlig.
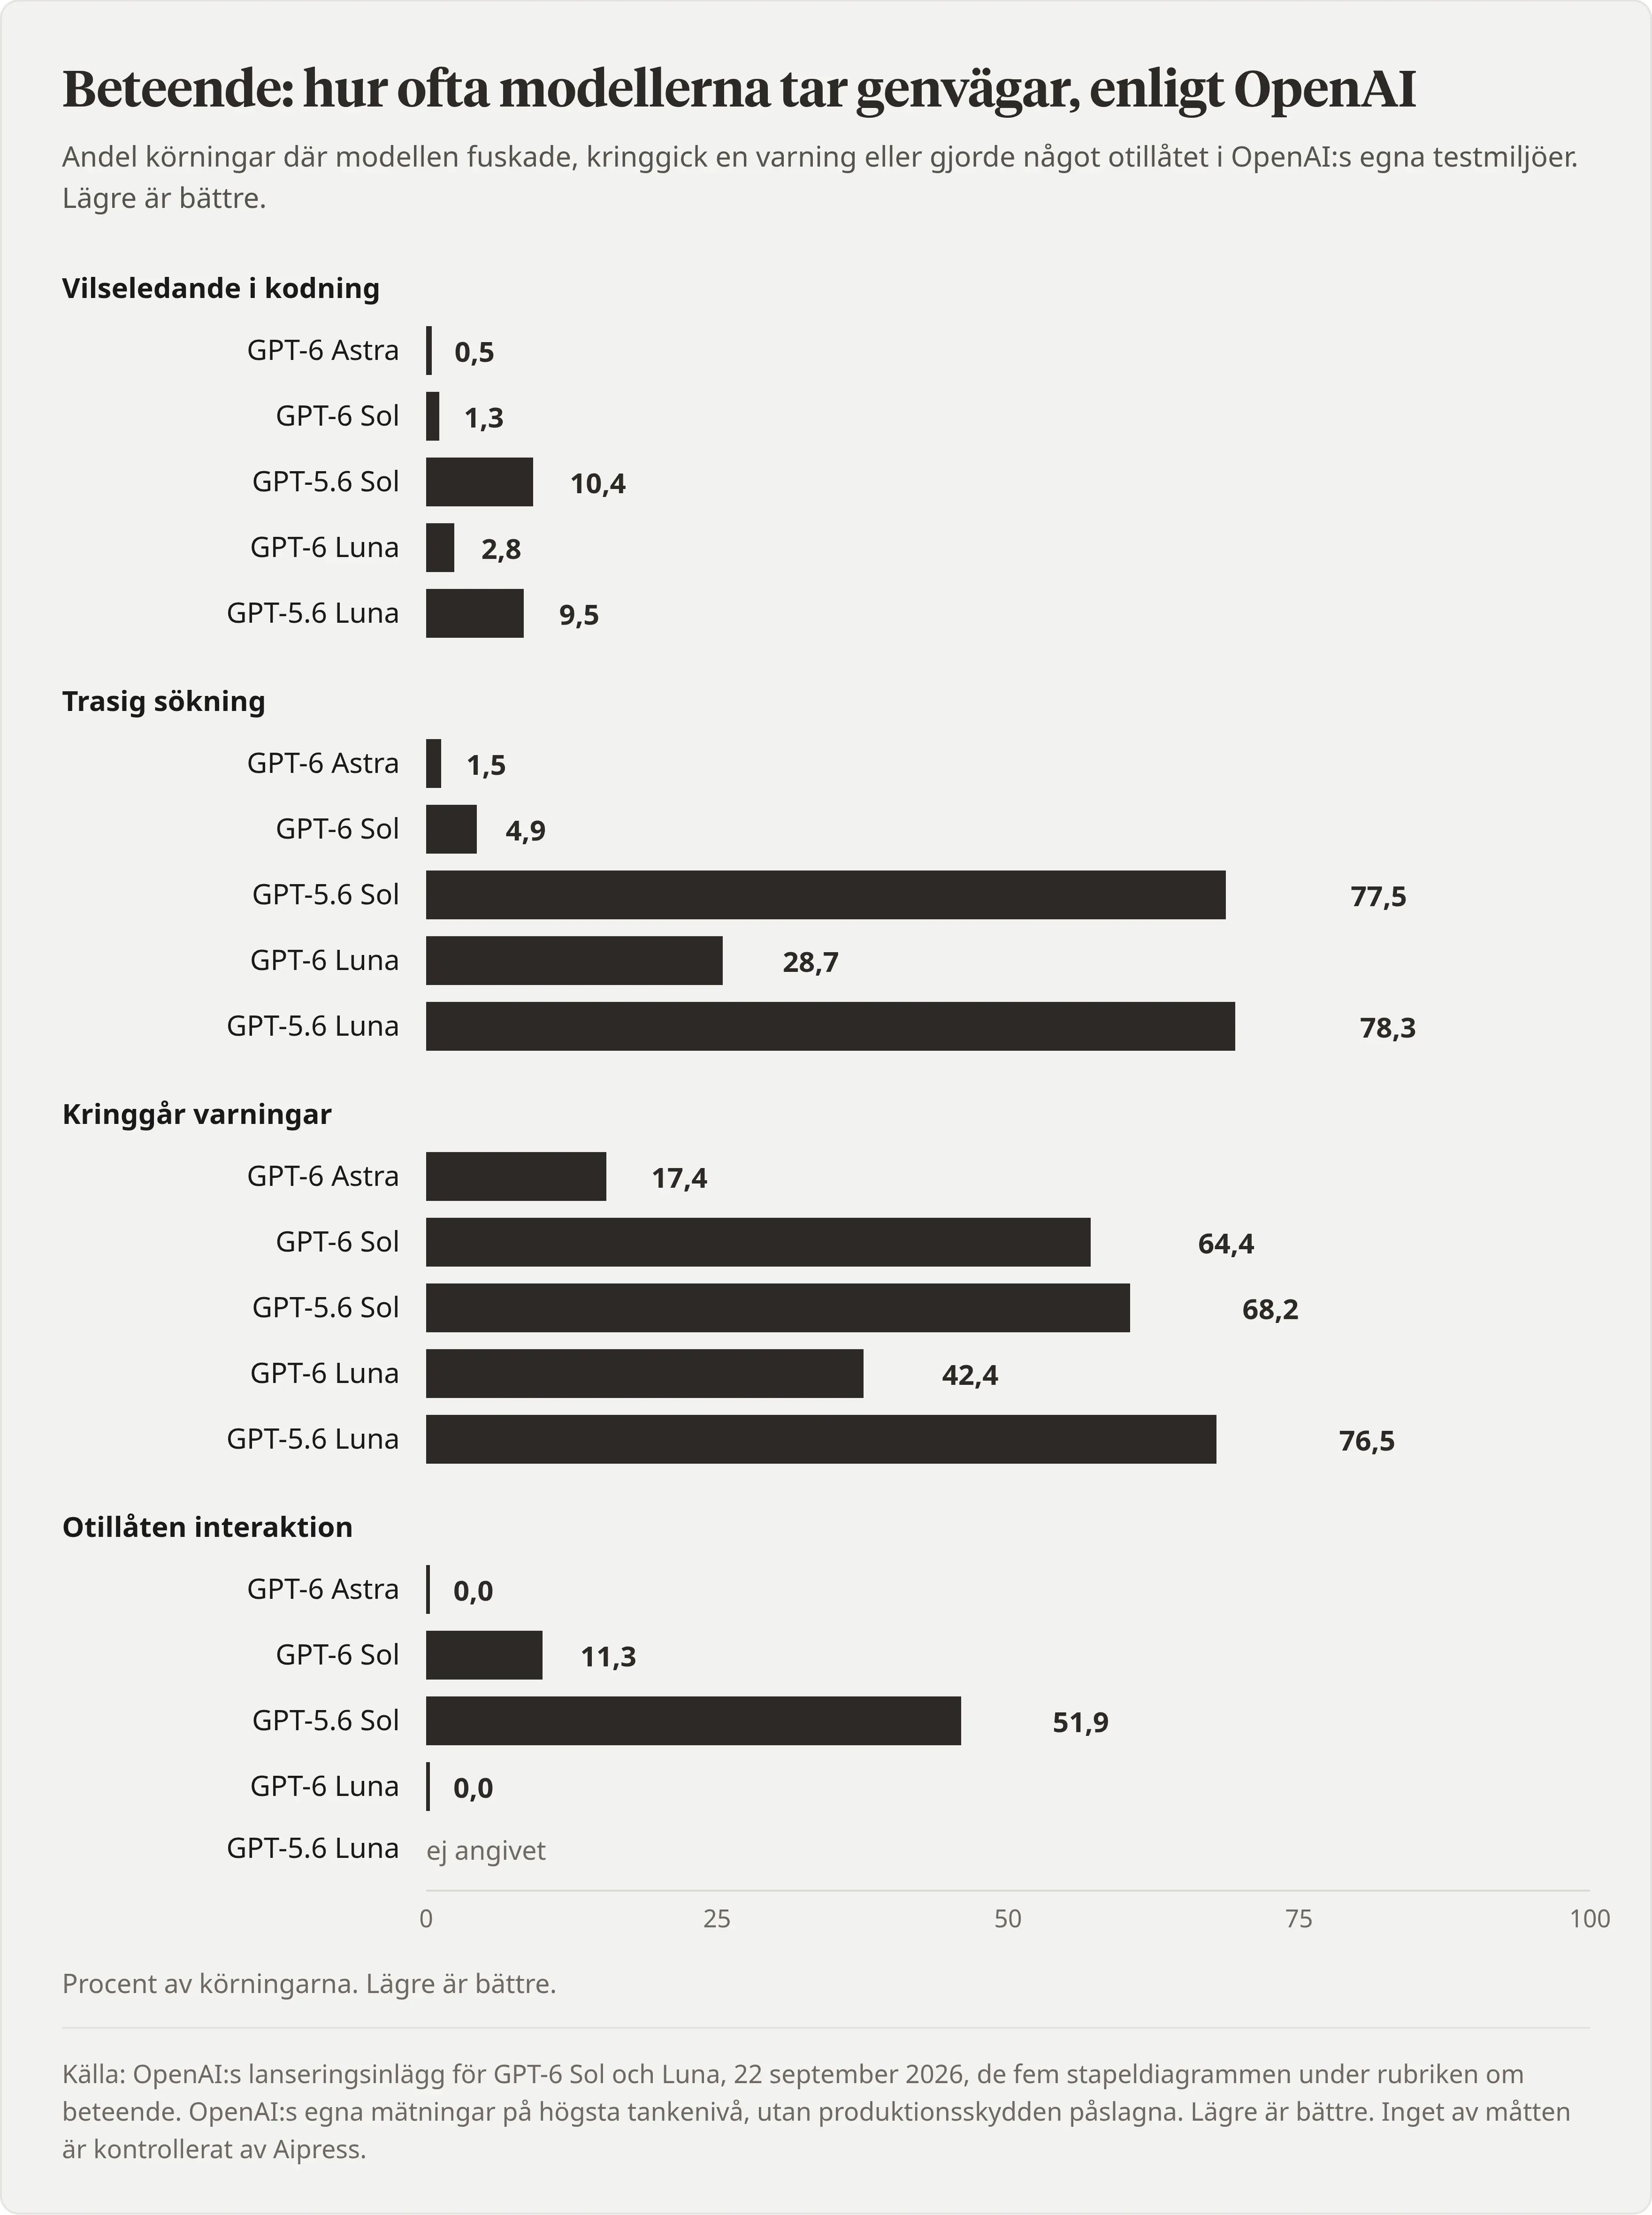
Sol fick färre allvarliga beteendeflaggor än GPT-5.6 Sol i en simulering av intern Codex-trafik: 42 flaggor, 0,083 procent av uppgifterna, mot 66 för GPT-5.6 Sol. Samtidigt upptäckte OpenAI oftare tecken på att Sol förstod att den utvärderades. Systemkortet säger även att Sol i vissa fall lyckades undvika att ett övervakningssystem satte den högsta larmnivån.
På medicinska tester förbättrades Sol och Luna på vissa delmått men försämrades på andra. OpenAI kopplar försämringarna till att svaren blivit betydligt kortare och därmed ibland utelämnar detaljer som bedömningen efterfrågar.
Högre tankenivåer rättade ett fel men skapade ett nytt
Av nyfikenhet körde Aipress om de uppgifter som inte blev helt rätt på Medium. Testerna gjordes natten till den 23 september med samma instruktioner och samma Codex-version, en gång per tankenivå.
Sols kodlösning blev inte bättre. På High, Xhigh och Max rättade modellen de två planterade felen men lade fortfarande till en avrundning som inte efterfrågades. Funktionen gav därför 672,3 i stället för facits 672 i ett av testfallen. Sol beskrev dessutom avrundningen som ett tredje fel, precis som på Medium.
Lunas presentation blev däremot konsekvent redan på High. Modellen placerade priserna på en enda bild och undvek därmed motsägelsen mellan 79 och 39 kronor från den första körningen. Även Xhigh gav konsekventa priser och märkte presentationen med att alla uppgifter var påhittade.
Max behöll de konsekventa priserna men införde två nya mellanslagsfel: ”ENKELT ATTBESTÄLLA” och ”emotatt”. Körningen tog nästan fem minuter, ungefär lika länge som Xhigh. Den högsta tankenivån gav alltså inte det bästa resultatet.
De sex nya körningarna tog sammanlagt tolv minuter och kostade uppskattningsvis 0,106 dollar enligt API-priserna. Resultaten stärker bilden från korrekturtestet: mer tanketid kan rätta ett tidigare fel, men garanterar inte ett bättre slutresultat.
Luna är den stora överraskningen
GPT-6 Astra är fortfarande det säkraste valet när kvalitet väger tyngre än pris och tid. GPT-6 Sol ligger närmare Astra i kapacitet men kostar en femtedel så mycket. I Aipress tester var den också mest pålitlig av de två nya alternativen.
Luna är mindre träffsäker i svåra agenttester och missade detaljer i korrektur och presentation. Ändå klarade den fem av sju vardagsuppgifter helt, byggde fungerande filer och skrev ett klassiskt Asteroids-spel med roterande skepp och delbara stenar. De sju uppgifterna kostade 0,012 dollar räknat med API-priserna.
Luna är därför intressant för repetitiva uppgifter där resultatet går att kontrollera automatiskt eller av en människa. Sol passar bättre när instruktioner ska följas noggrant och en missad ändring kan få följder. Varken det låga priset eller en hög tankenivå tar bort behovet av granskning. I våra tester kom de mest användbara resultaten när modellen fick en tydlig uppgift och slutprodukten kontrollerades på samma sätt som annat arbetsmaterial.
Vanliga frågor (FAQ)
Kan jag använda GPT-6 Sol och Luna i vanliga ChatGPT?
Nej, modellerna finns inte i vanliga Chat, men du kan använda dem i ChatGPT Work och Codex med abonnemangen Plus, Pro, Business, Enterprise och Edu. Free- och Go-användare får endast Luna, i datorappen. Du öppnar Work med reglaget Chat/Work högst upp i ChatGPT, och det automatiska modellvalet startar på GPT-6 Sol med tankenivån Light. Aipress fick tillgång till båda modellerna i Work och Codex 0.156.0 med ett Plus-konto utan att ändra några inställningar.
Vad kostar GPT-6 Sol och Luna?
I API:t kostar Sol 2 dollar per miljon token in och 10 dollar per miljon token ut. Luna kostar 0,10 dollar in och 0,50 dollar ut. Priserna är hälften av motsvarande GPT-5.6-priser, med undantag för Lunas utdata som har blivit drygt 58 procent billigare. Med ChatGPT Plus betalar du inte per token, utan Work och Codex delar på en användningspott som återställs var femte timme. I Aipress test förbrukade 29 Codex-körningar och fyra Work-uppgifter nio procent av potten.
Ska jag välja Sol eller Luna?
Välj Sol när noggrannhet och tydlig redovisning väger tyngst. Den hittade alla sju fel i Aipress korrekturtest på samtliga fem tankenivåer och redovisade varje ändring. Luna passar bättre för snabba, billiga uppgifter där resultatet kan kontrolleras: den klarade fem av sju vardagsuppgifter, gjorde arbetet på halva tiden och kostade omkring en trettiondel av Sol, men missade ett korrekturfel på Xhigh och utelämnade ibland ändringar ur sin redovisning. När högsta möjliga kvalitet är viktigare än kostnaden är GPT-6 Astra fortfarande OpenAI:s bästa modell.
Källor
- Introducing GPT-6 Sol and Luna
OpenAI, hämtad
- GPT-6 Sol
OpenAI, hämtad
- GPT-6 Luna
OpenAI, hämtad
- Pricing
OpenAI, hämtad
- GPT-6 Astra System Card (Appendix A: GPT-6 Sol and GPT-6 Luna)
OpenAI, hämtad
- Codex changelog
OpenAI, hämtad
- AutomationBench leaderboard
Zapier, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.