Claude Opus 5.5 lanserades den 22 september och är först ut i Anthropics nya 5.5-serie. Enligt företaget presterar den på Claude Fable 5.1:s nivå i de flesta uppgifter, samtidigt som den kräver mindre datorkraft.
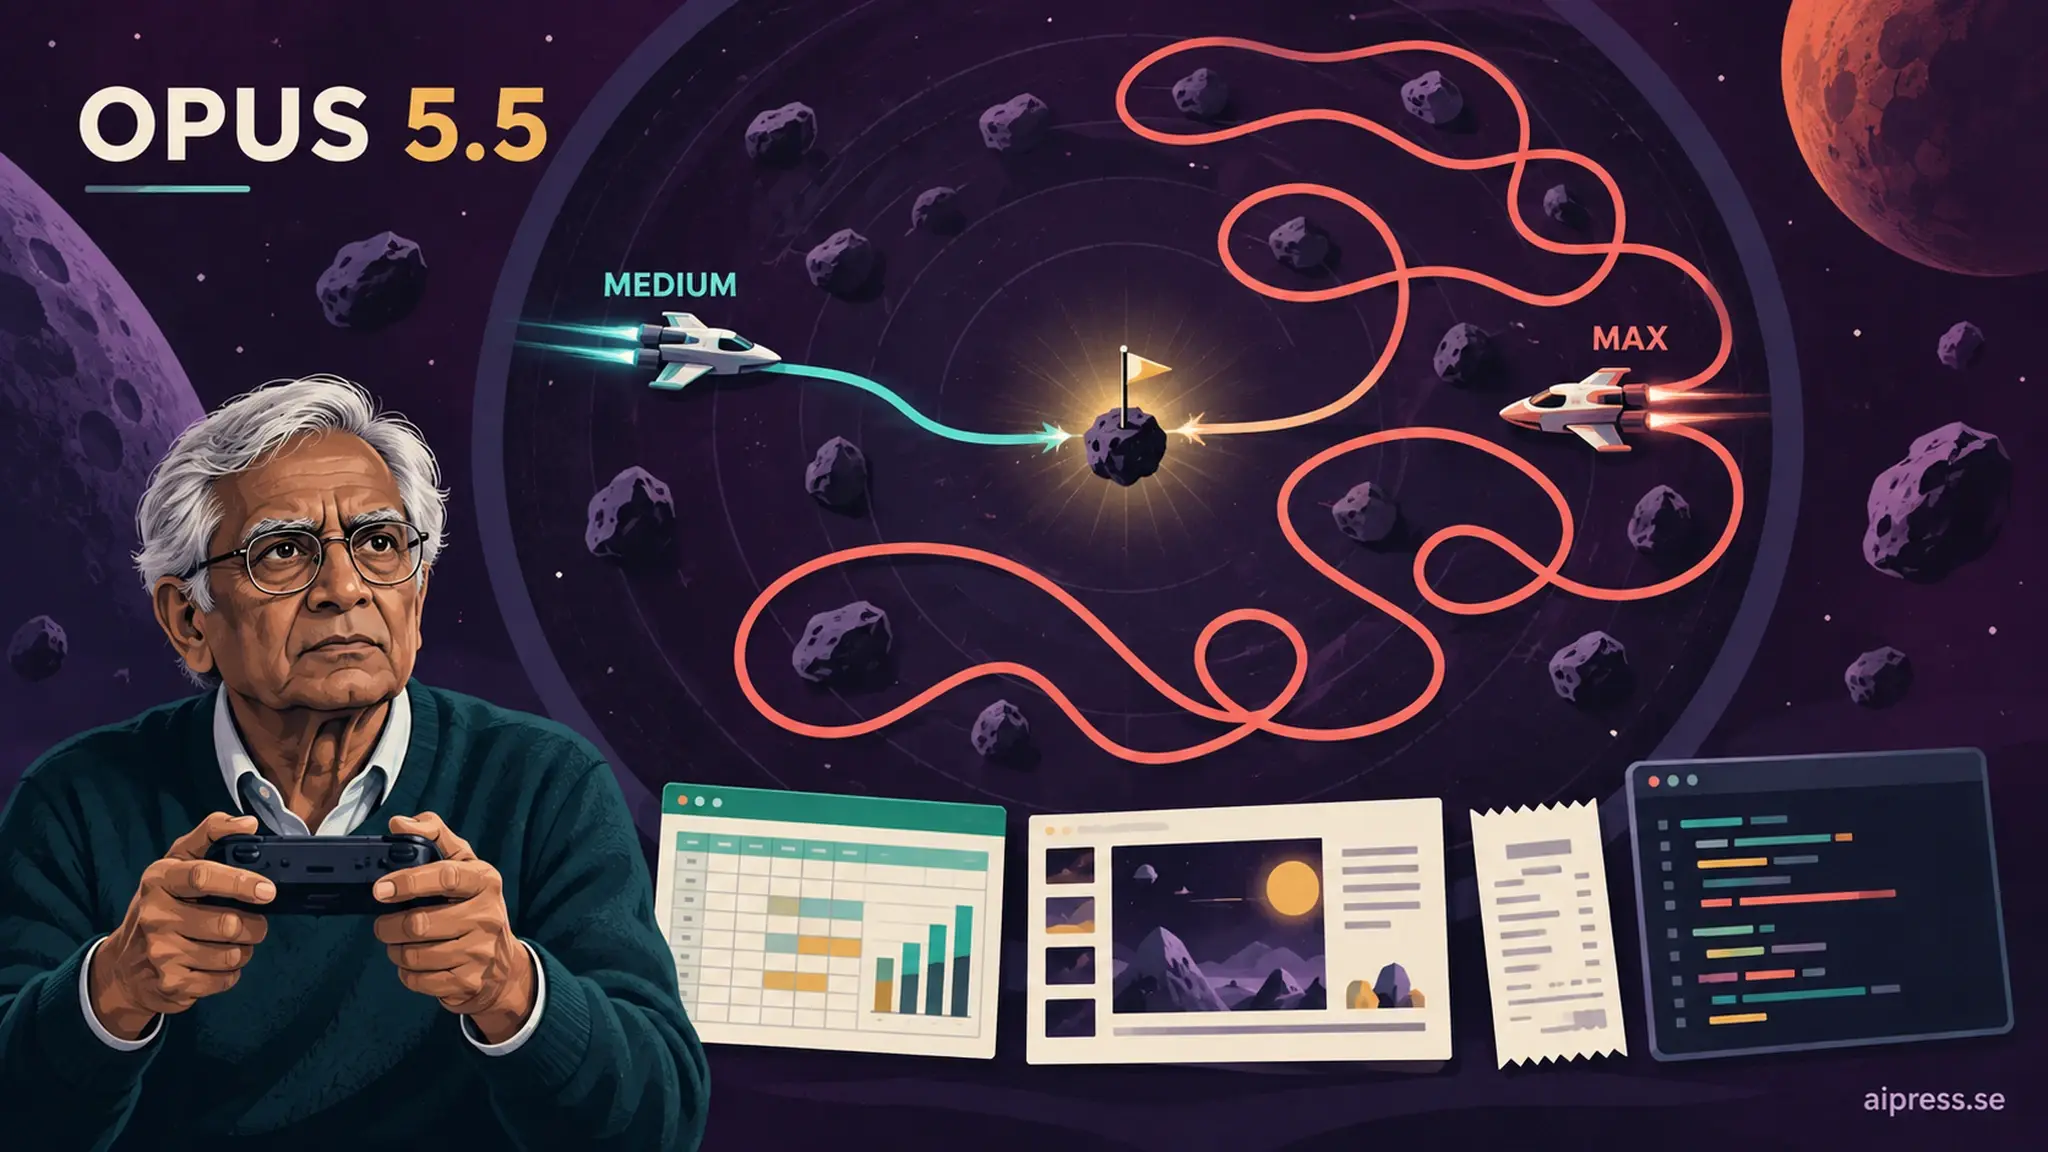
Aipress testade den under lanseringskvällen från Sverige. Den klarade sex av sju vanliga arbetsuppgifter helt och byggde fyra fungerande asteroidspel på första försöket. Standardnivån medium gav ett komplett spel på 54 sekunder. Maxnivån tog nästan 30 minuter och kostade omkring 30 gånger mer, trots att båda versionerna uppfyllde de nio grundkraven.
Tokenpriset har sänkts med 20 procent
Claude Opus 5.5 kostar 4 dollar per miljon token som skickas in och 20 dollar per miljon token som skrivs ut. För Opus 5 är priserna 5 respektive 25 dollar. Det rena tokenpriset har alltså sänkts med 20 procent.
Anthropic marknadsför ändå lanseringen som 40 procent billigare för typiska uppgifter. Den siffran bygger även på företagets egna mätningar, där Opus 5.5 använder färre token för att lösa ett arbete. Den faktiska besparingen varierar därför beroende på uppgift, vald tankenivå och antalet verktygsanrop.
Så här står det i lanseringsinlägget:
Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads. Input and output tokens are $4 and $20 per million, 20% less than Opus 5.
Bara en del av sänkningen sitter alltså i prislistan. Resten kräver att arbetet kan göras med kortare text in och ut, något leverantören har mätt på egna flöden.
Cacheläsning, som används när en AI-agent återkommer till tidigare kod eller samtal, har blivit betydligt billigare: 0,20 dollar per miljon token mot 0,50 dollar för föregångaren. Anthropic uppger också att svaren genereras mer än 30 procent snabbare.
Prislistan för de två:
| Dollar per miljon token | Opus 5.5 | Opus 5 |
|---|---|---|
| Indata | 4 | 5 |
| Utdata | 20 | 25 |
| Cacheläsning | 0,20 | 0,50 |
| Cacheskrivning, 5 minuter | 5 | 6,25 |
| Cacheskrivning, 1 timme | 8 | 10 |
| Batch, indata och utdata | 2 och 10 | 2,50 och 12,50 |
| Fast mode, indata och utdata | 8 och 40 | 10 och 50 |
Hela kontextfönstret debiteras till ordinarie pris, utan påslag för långa anrop.
Kontextfönstret rymmer en miljon token, ungefär 555 000 ord med Anthropics nuvarande sätt att räkna. Ett enskilt svar kan omfatta högst 128 000 token. Anthropics dokumentation anger juni 2026 som gräns för träningsdata och tillförlitlig intern kunskap.
Anthropics resultat placerar den nära toppen
I lanseringsinlägget redovisar Anthropic tydliga förbättringar inom programmering, datorstyrning och kvalificerat kontorsarbete. Claude Opus 5.5 får bland annat 66,4 procent i Terminal-Bench 4.0, jämfört med 52,3 procent för Opus 5 och 57,9 procent för GPT-6 Astra.
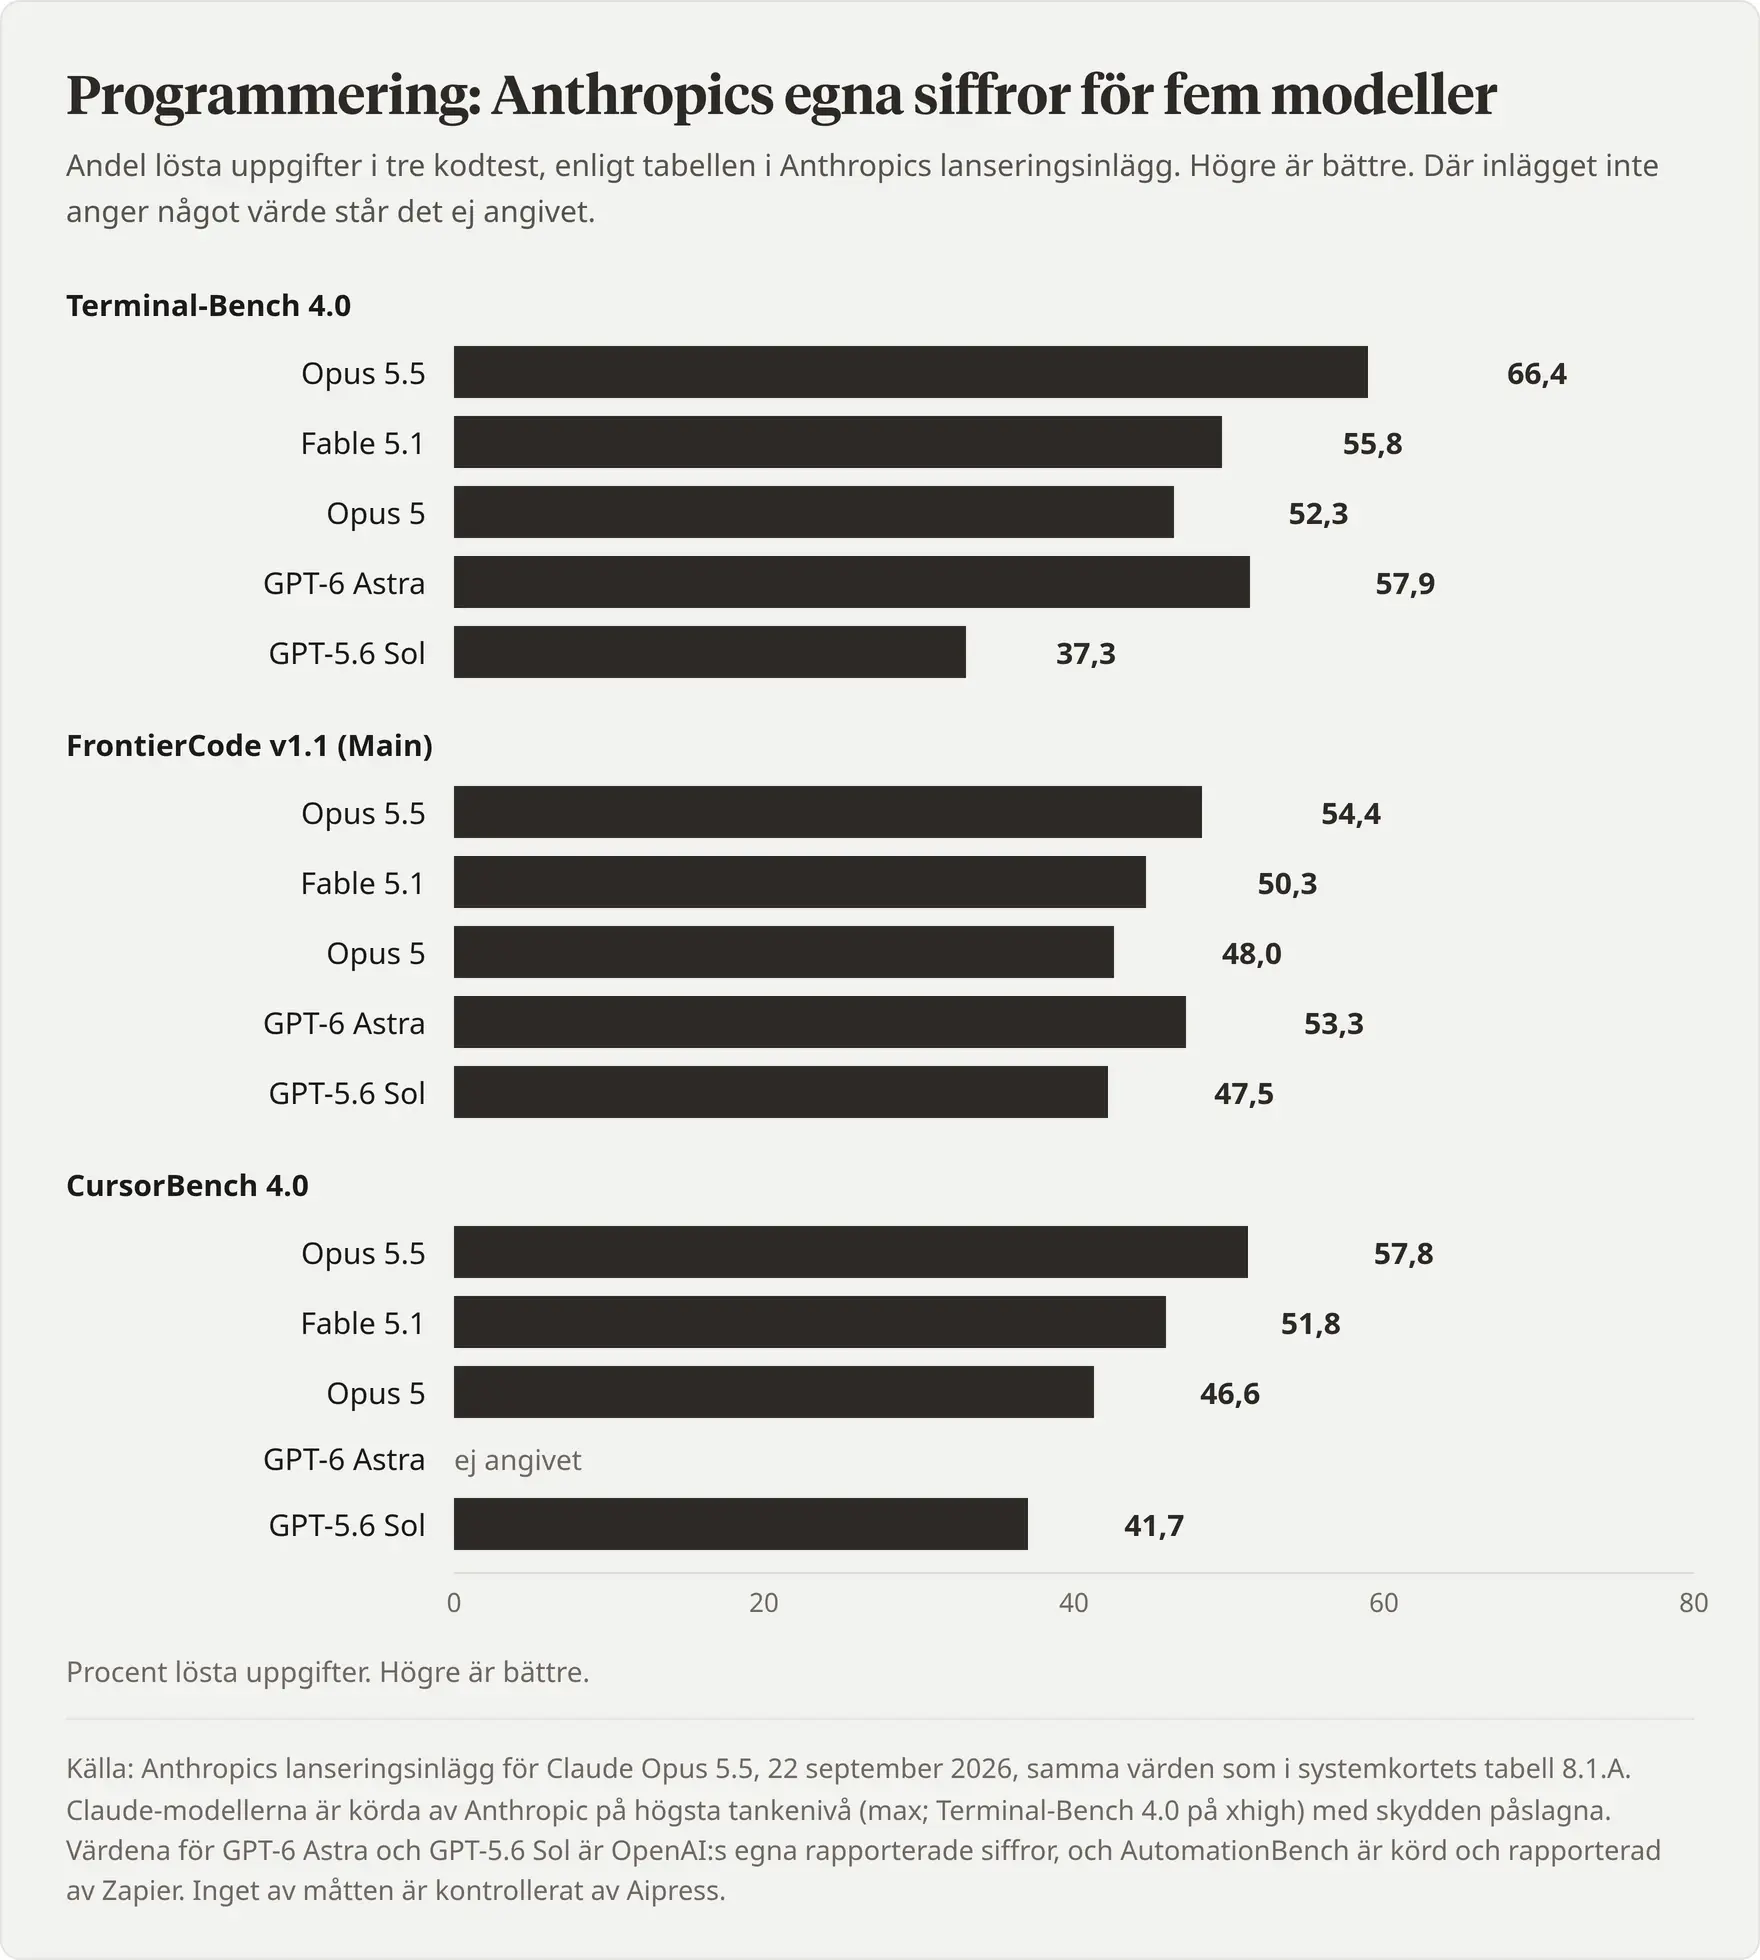
På FrontierCode får den 54,4 procent på maxnivån. Standardinställningen medium ger faktiskt ett något högre resultat, 54,6 procent. Det är ett av flera tecken på att mer beräkning inte automatiskt förbättrar resultatet.
Claude Opus 5.5 är inte bäst i varje redovisat test. GPT-6 Astra ligger högre i både AutomationBench och det vetenskapliga Terminal-Bench-Science. Anthropics tabell är dessutom ingen enhetlig oberoende jämförelse. Företaget har kört Claude-modellerna, medan flera konkurrentsiffror kommer från respektive tillverkares publicerade resultat eller externa topplistor. De flesta resultaten för Opus 5.5 har tagits fram med maxnivån, trots att vanliga användare får medium som standard.
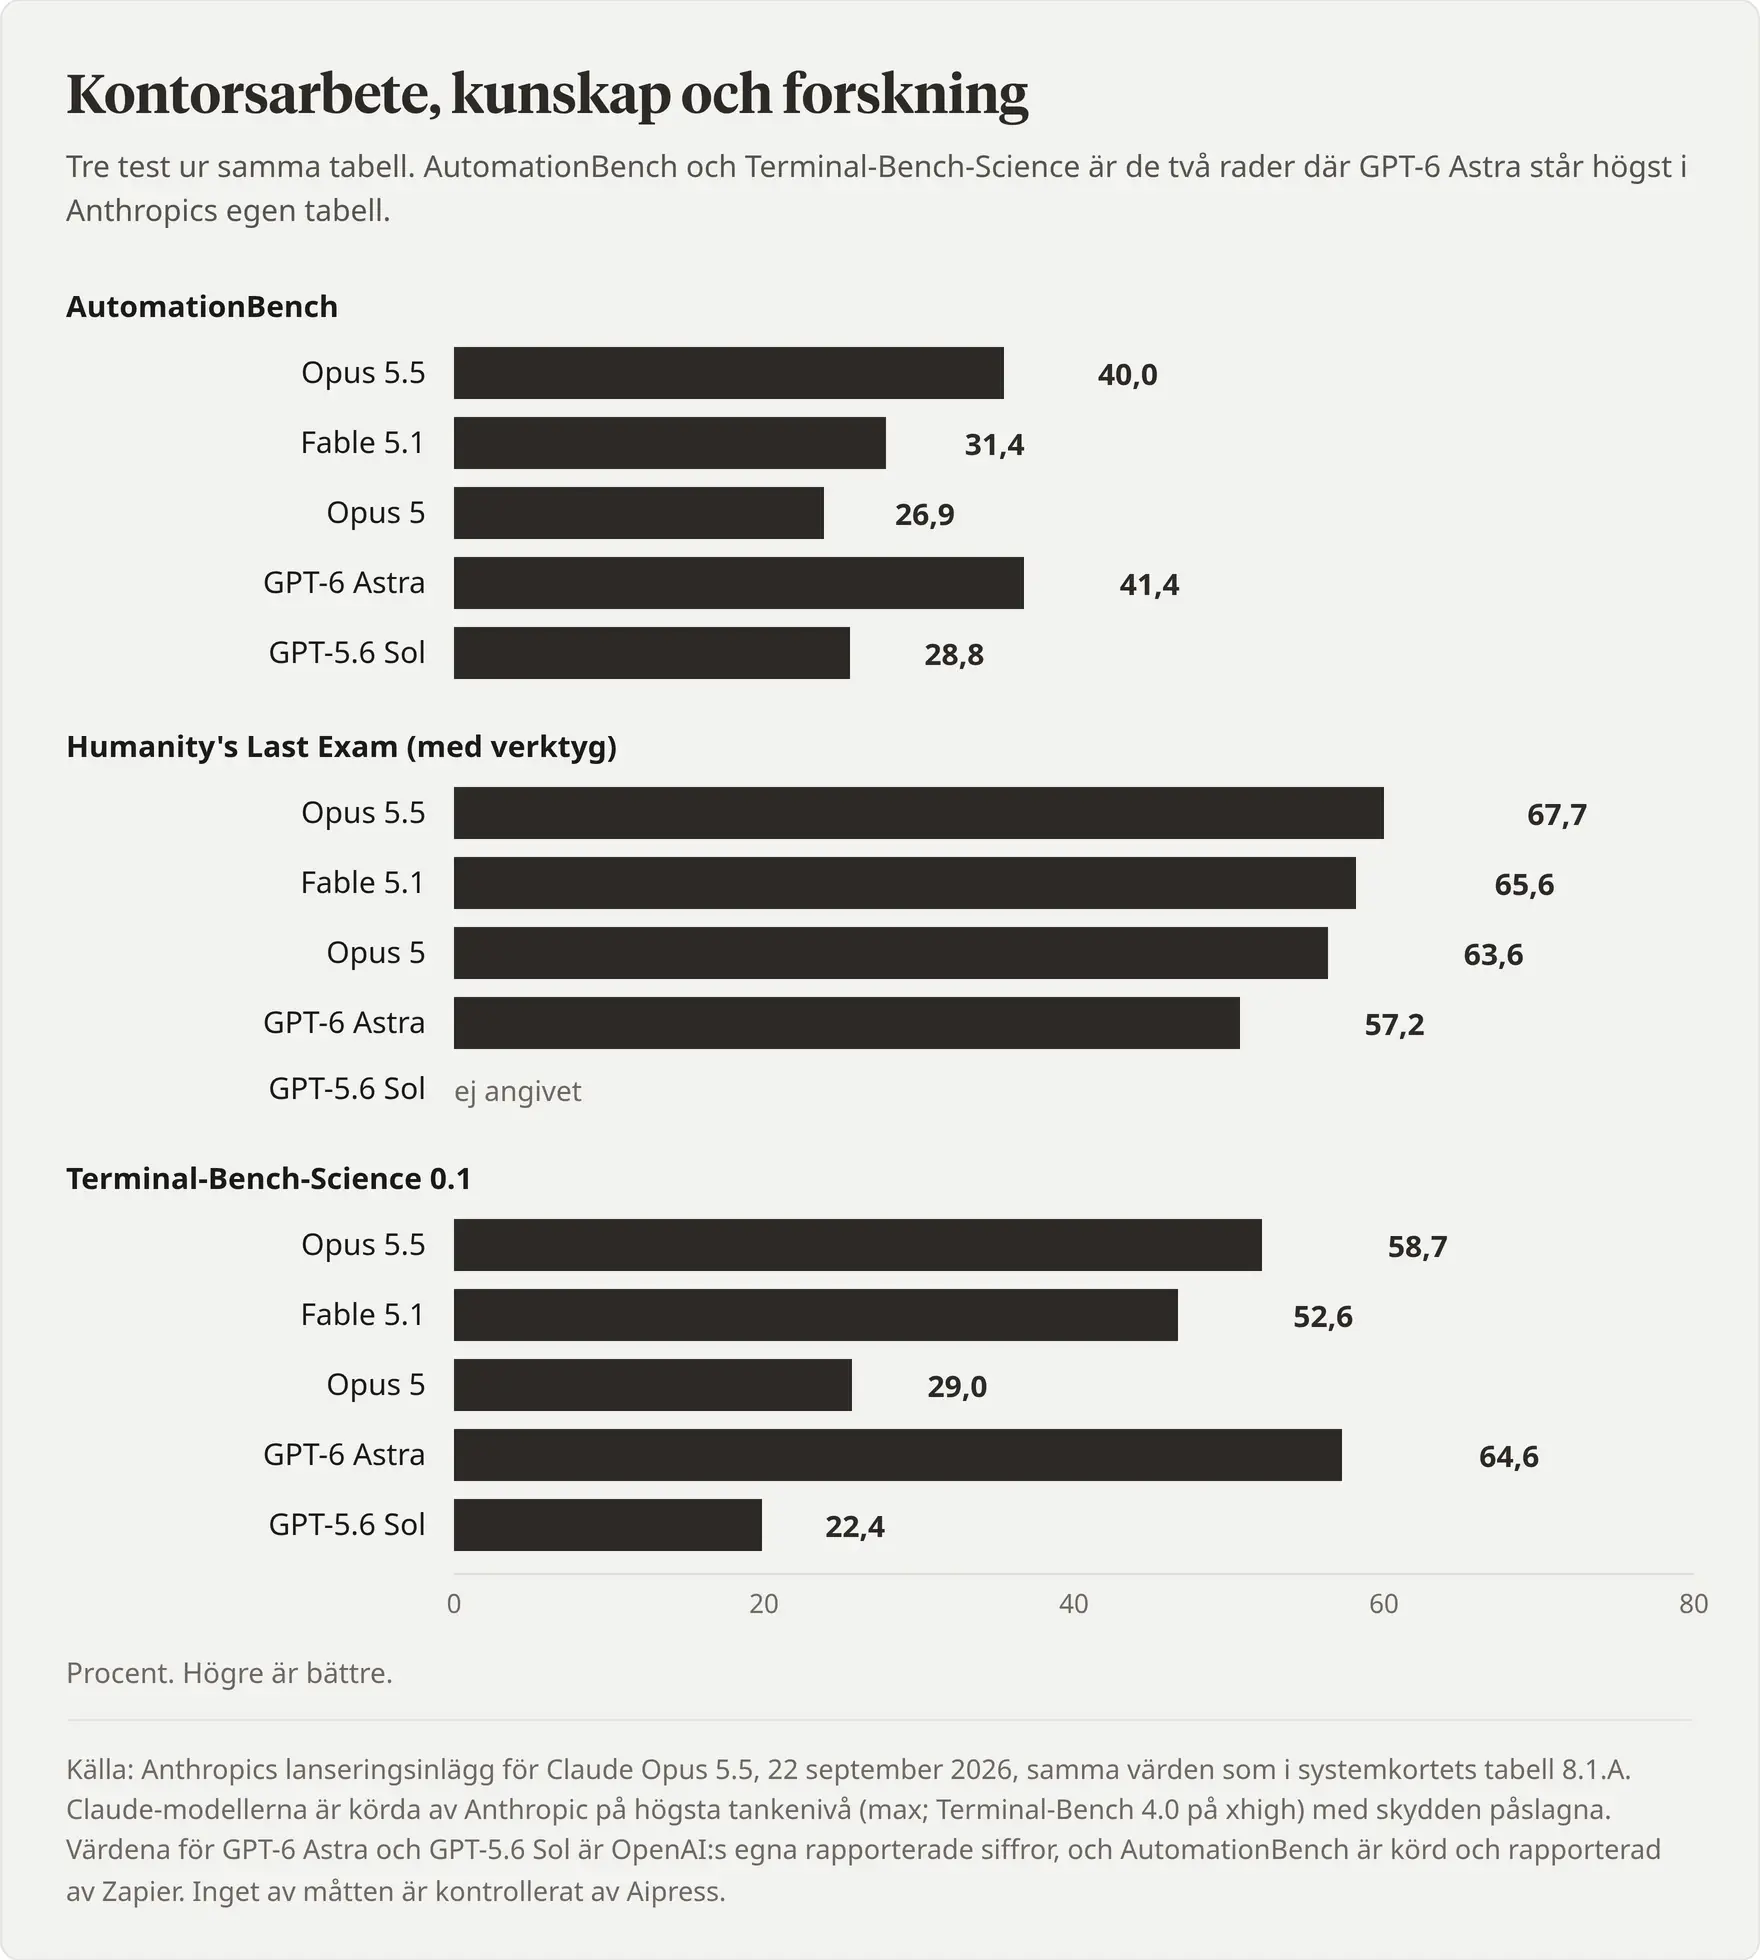
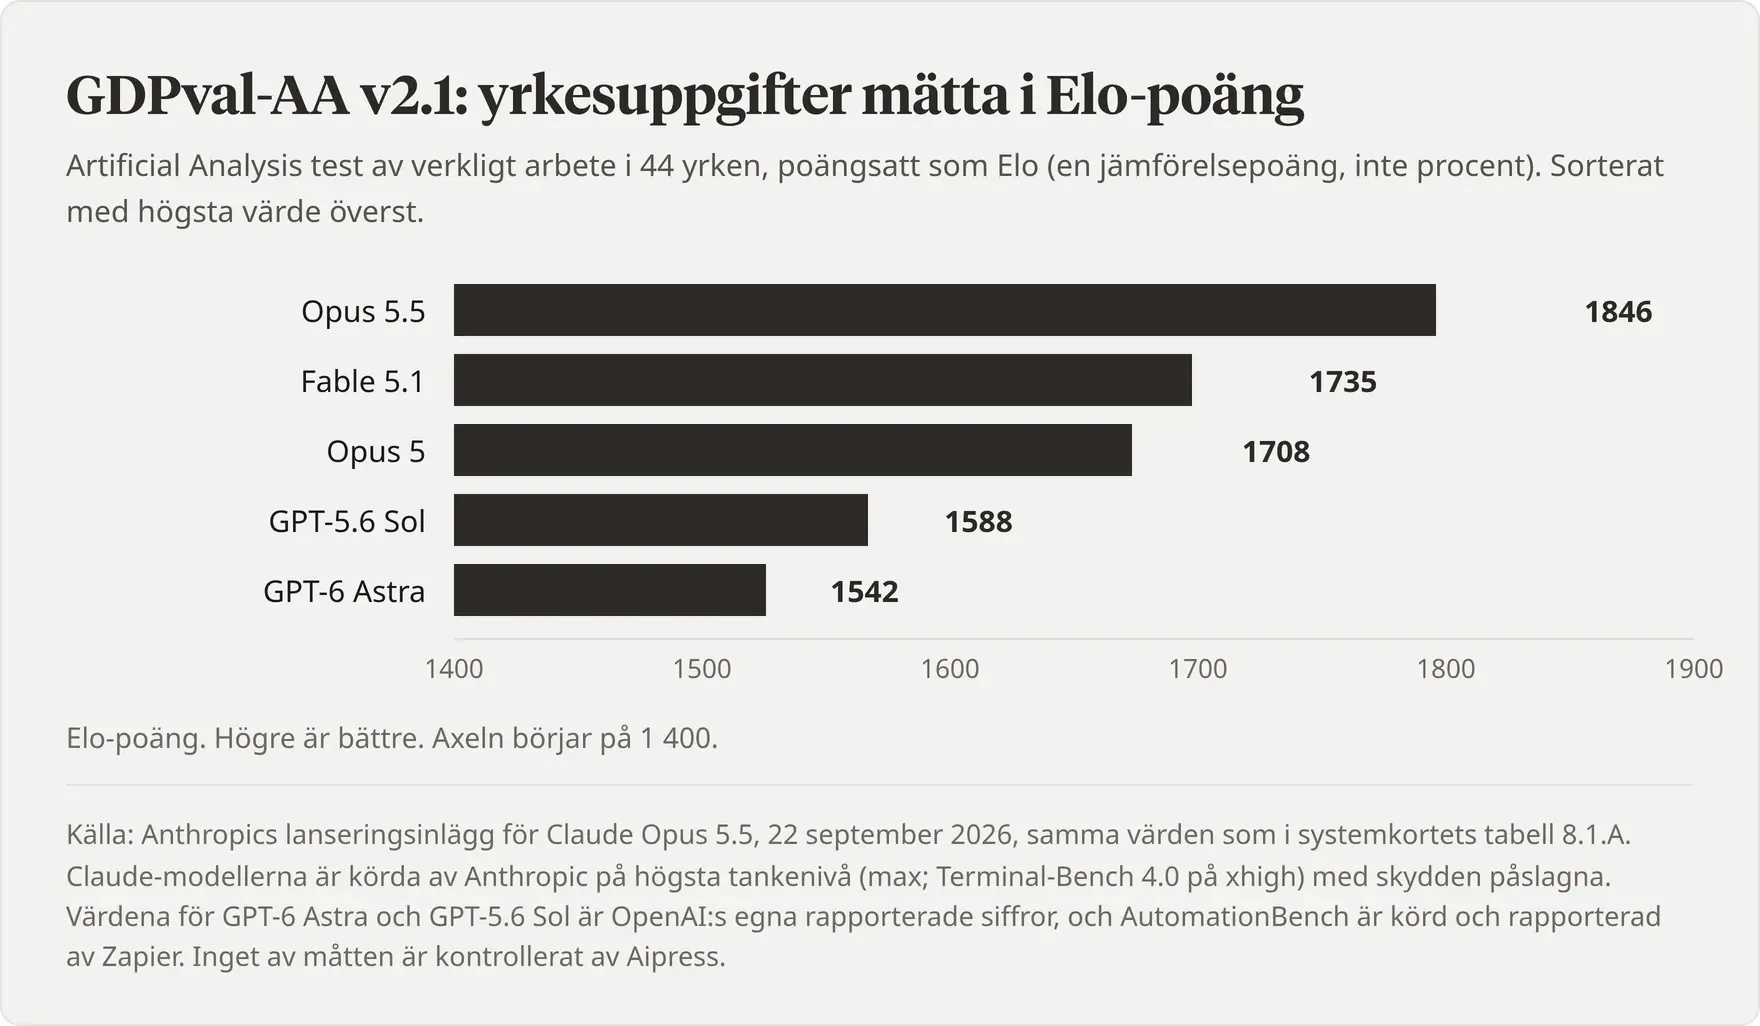
Systemkortets fullständiga sammanställning (tabell 8.1.A), där ett streck står för värden som saknas. GDPval-AA och AA-Briefcase är Elo-poäng, de övriga raderna andelar:
| Riktmärke | Opus 5.5 | Opus 5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-bench Pro | 89,9 | 79,2 | 81,2 | - |
| SWE-bench Multilingual | 93,9 | 89,5 | 89,1 | - |
| SWE-bench Multimodal | 61,4 | 59,4 | 54,7 | - |
| FrontierCode v1.1 (Main) | 54,4 | 48,0 | 50,3 | 53,3 |
| Terminal-Bench 4.0 | 66,4 | 52,3 | 55,8 | 57,9 |
| Terminal-Bench-Science 0.1 | 58,7 | 29,0 | 52,6 | 64,6 |
| Humanity’s Last Exam, utan verktyg | 64,4 | 56,6 | 60,9 | - |
| Humanity’s Last Exam, med verktyg | 67,7 | 63,6 | 65,6 | 57,2 |
| OSWorld 2.0 (partial/strict) | 81,8/48,7 | 74,0/37,2 | 80,7/42,8 | - |
| HealthBench Professional | 65,6 | 59,8 | 62,1 | 63,4 |
| GDPval-AA v2.1 | 1846 | 1708 | 1735 | 1542 |
| AA-Briefcase v1.1 | 1822 | 1673 | 1678 | 1569 |
| AutomationBench | 40,0 | 26,9 | 31,4 | 41,4 |
Aipress test gav sex av sju vardagsuppgifter helt rätt
Aipress körde sju uppgifter genom Claude Code 2.1.280 med Claude Opus 5.5 och tankenivån medium uttryckligen valda. Testerna gjordes från en svensk dator med ett Claude Max-abonnemang.
Uppgifterna omfattade bland annat att rätta ett svenskt kundmejl, hitta fel i Python-kod, läsa ett kvitto, kontrollera väder, tolka en fotograferad prislista samt skapa en Excel-budget och en PowerPoint-presentation.
| Uppgift | Opus 5.5 | Tid | Kostnad | Astra: tid | Astra: kostnad | Grok 4.7: tid | Grok: kostnad |
|---|---|---|---|---|---|---|---|
| Rätta sju fel i ett svenskt kundmejl | 7 av 7 | 9,8 s | 0,0244 dollar | 11,4 s | 0,0263 dollar | 43,7 s | 0,0217 dollar |
| Hitta två fel i Python-kod | 2 av 2 | 8,8 s | 0,0177 dollar | 5,2 s | 0,0136 dollar | 9,0 s | 0,0040 dollar |
| Göra ett ICA-kvitto till JSON | Värdena rätt, JSON i kodblock | 7,0 s | 0,0195 dollar | 8,1 s | 0,0224 dollar | 25,5 s | 0,0132 dollar |
| Kontrollera vädret för två orter | Godkänd | 7,1 s | 0,0184 dollar | 6,1 s | 0,0110 dollar | 4,8 s | 0,0071 dollar |
| Läsa en prislista på ett foto | 156 kr | 7,3 s | 0,0274 dollar | 4,1 s | 0,0117 dollar | 5,4 s | 0,0043 dollar |
| Skapa en månadsbudget i Excel | 9 av 9 krav | 74,7 s | 0,5130 dollar | 41,3 s | 0,1578 dollar | 219,1 s | 0,1037 dollar |
| Skapa en PowerPoint-presentation | 10 av 10 krav | 74,1 s | 0,4389 dollar | 99,3 s | 0,2843 dollar | 181,9 s | 0,0743 dollar |
| Totalt | 6 av 7 helt rätt | 189 s | 1,059 dollar | 175 s | 0,527 dollar | 489 s | 0,228 dollar |
Alla sakuppgifter i kvittot blev rätt, men JSON-svaret placerades i ett markdownblock trots instruktionen att lämna ren JSON. En människa kan läsa innehållet utan problem, men ett program som väntar sig giltig JSON stannar redan vid det första tecknet. Felet uppstod vid båda körningarna av uppgiften.
I Python-testet hittades de två planterade felen. AI:n ändrade dessutom avrundningen från hela kronor till två decimaler, trots att det inte ingick i uppgiften. Ändringen var rimligt motiverad men avvek från facit. Det visar en återkommande svaghet: Claude vill gärna förbättra mer än användaren har bett om.
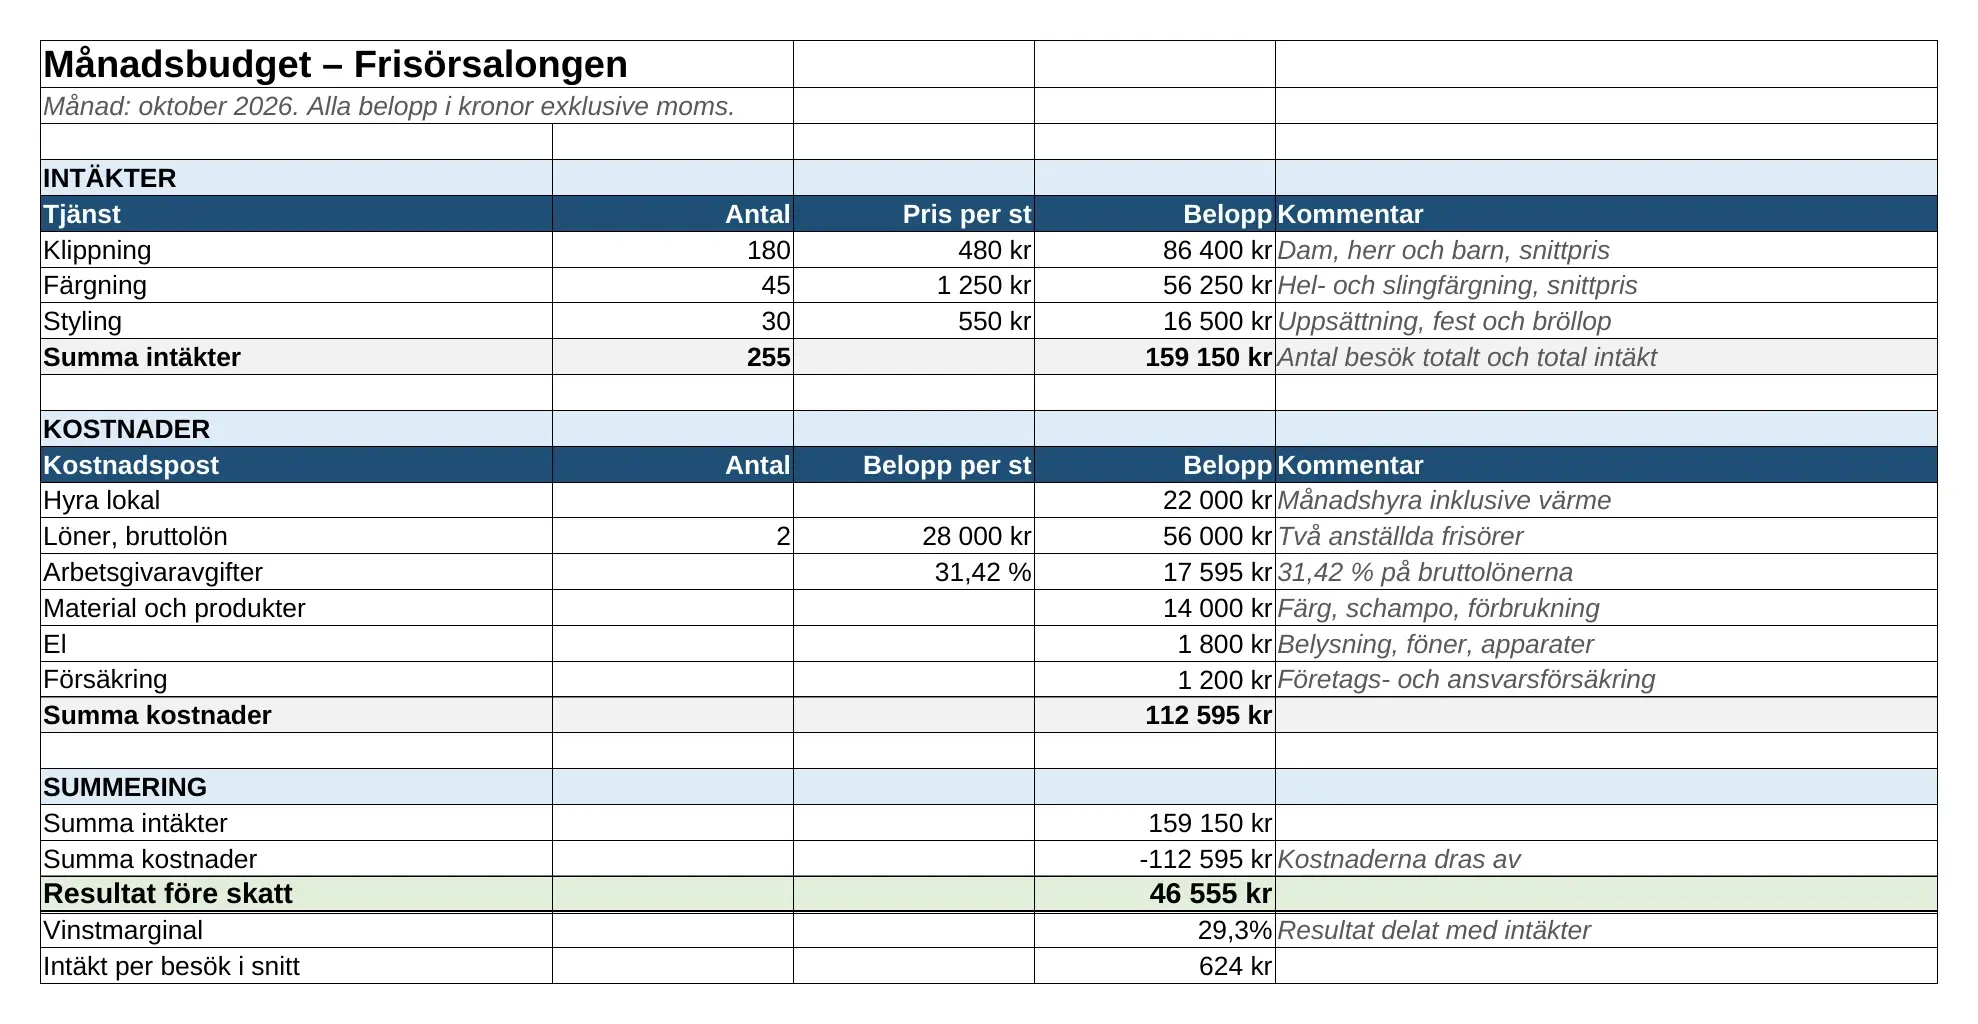
Excel-filen klarade samtliga nio krav och innehöll riktiga formler samt sparade beräknade värden. Där fanns även arbetsgivaravgifter, resultatmarginal och genomsnittlig intäkt per besök. Resultatet före skatt, 46 555 kronor, stämde vid en separat kontroll. Kalkylbladet går att öppna här.
PowerPoint-presentationen, som går att ladda ner här, klarade alla tio krav och hade en sammanhållen formgivning. Däremot hittade Claude på ett kundnamn, en adress, ett telefonnummer och en domän som såg verkliga ut. I svaret varnades det för att domänen inte hade kontrollerats, men uppgifterna i presentationen var inte märkta som exempel. Sådana tillägg är olämpliga i material som kan lämna företaget utan manuell granskning.
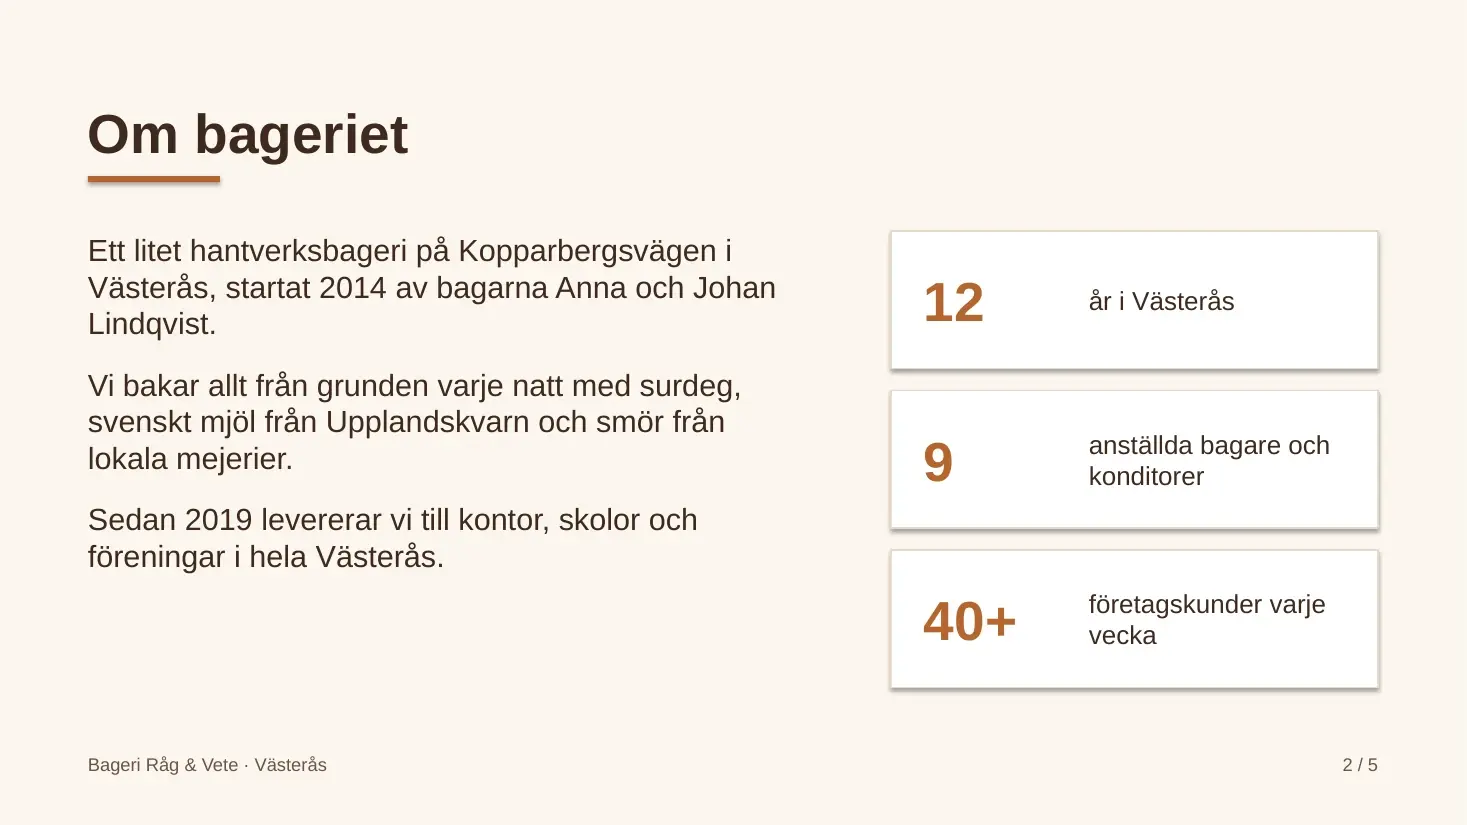
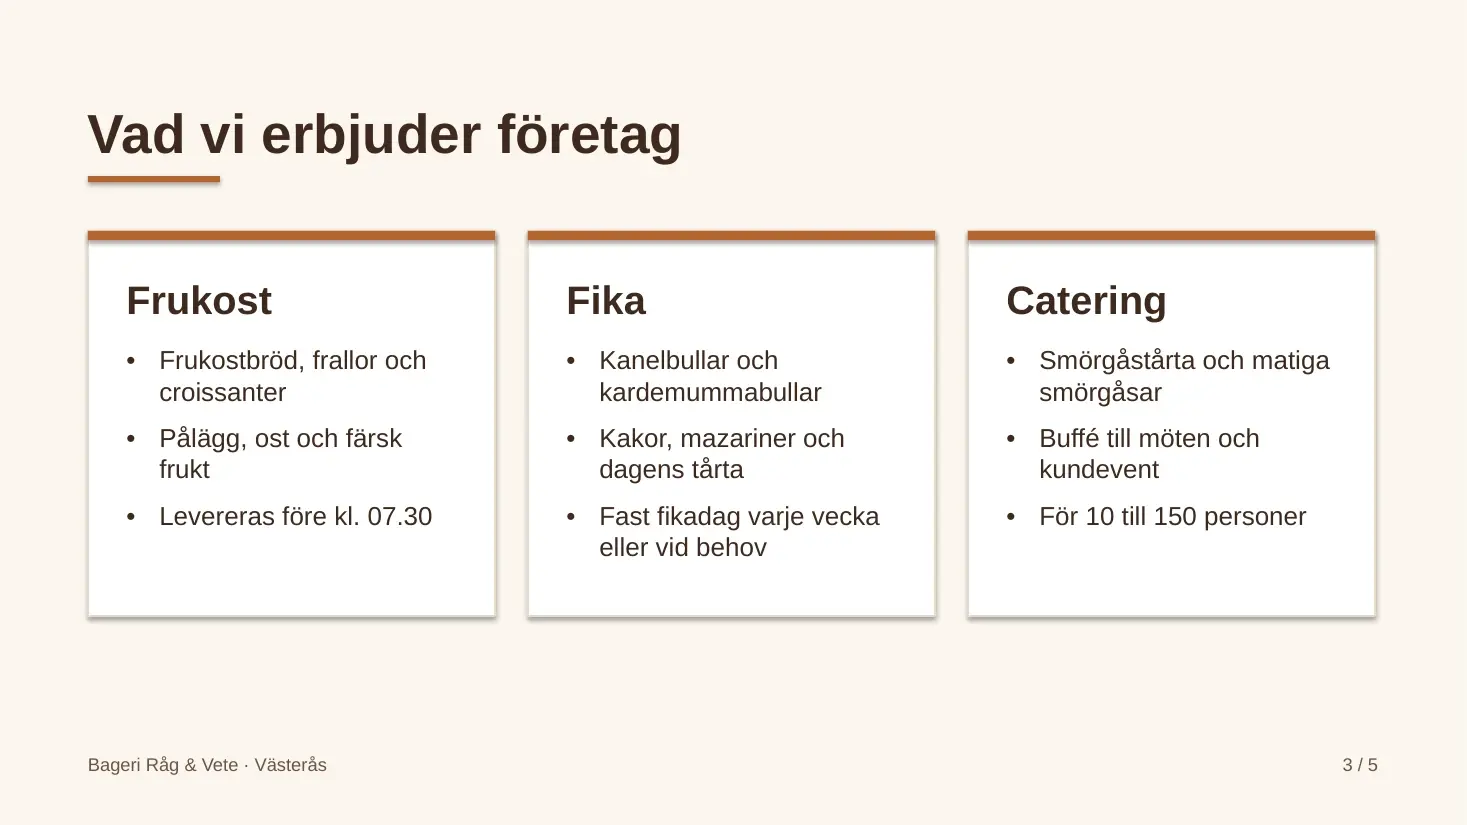
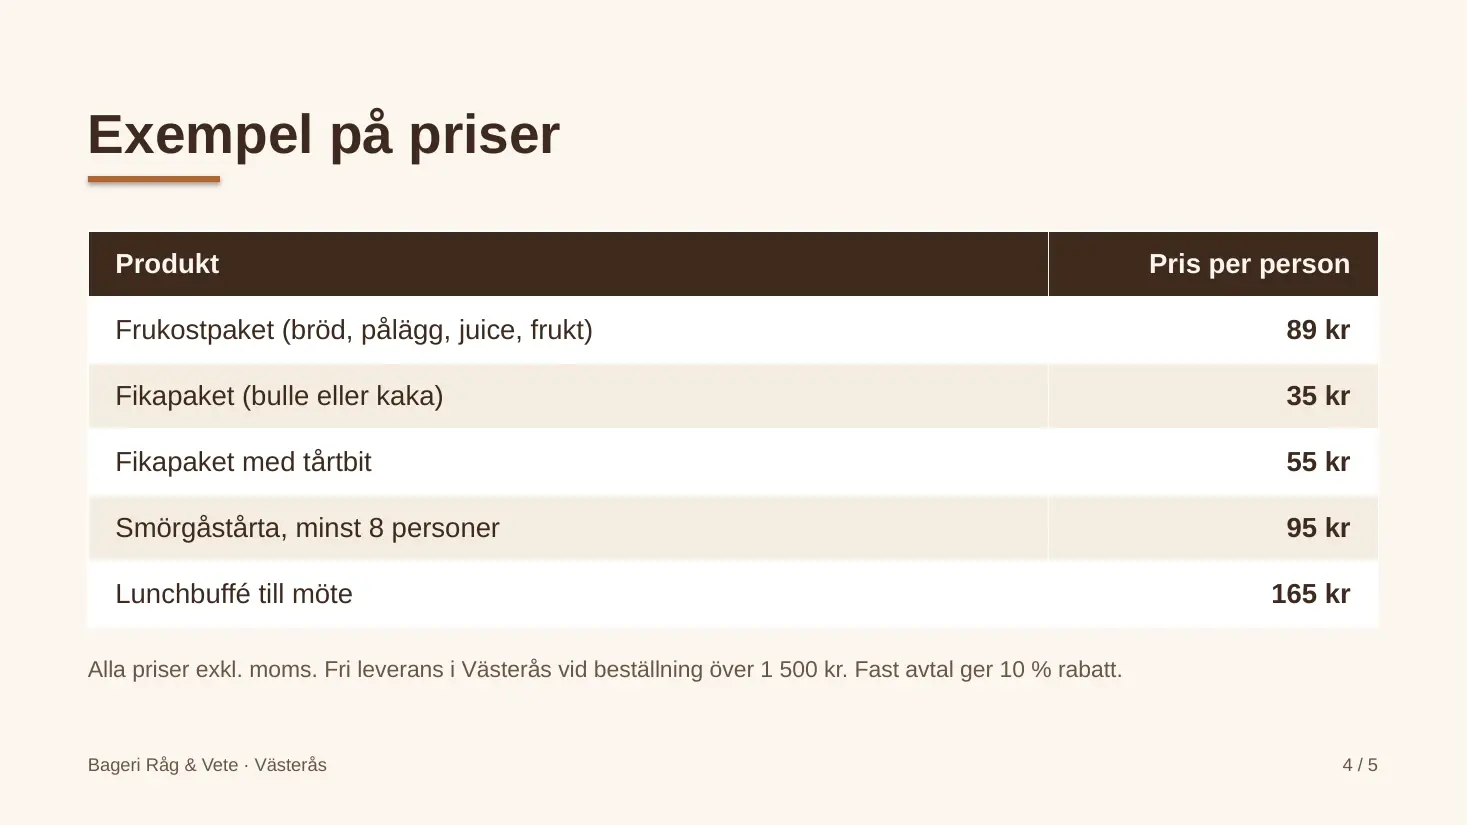
De sju uppgifterna kostade ungefär dubbelt så mycket som motsvarande tidigare körningar med GPT-6 Astra och drygt fyra gånger så mycket som körningarna med Grok 4.7. Miljöerna var inte helt jämförbara för filuppgifterna. Claude skrev och körde egna skript i 10 verktygsvarv för Excel-filen och 11 för presentationen. Eftersom hela samtalet läses in på nytt vid varje varv blev just dessa uppgifter dyra. Varje test gjordes dessutom bara en gång. Resultaten ska därför läsas som praktiska exempel, inte som ett vetenskapligt modelltest.
Fyra fungerande spel med stora kostnadsskillnader
För att undersöka vad tankenivån betyder fick Claude skapa ett asteroidspel på medium, high, xhigh och max. Spelet skulle ligga i en enda HTML-fil, fungera utan externa bibliotek och innehålla styrning, skott, poäng, liv, game over och cyberpunkstil.
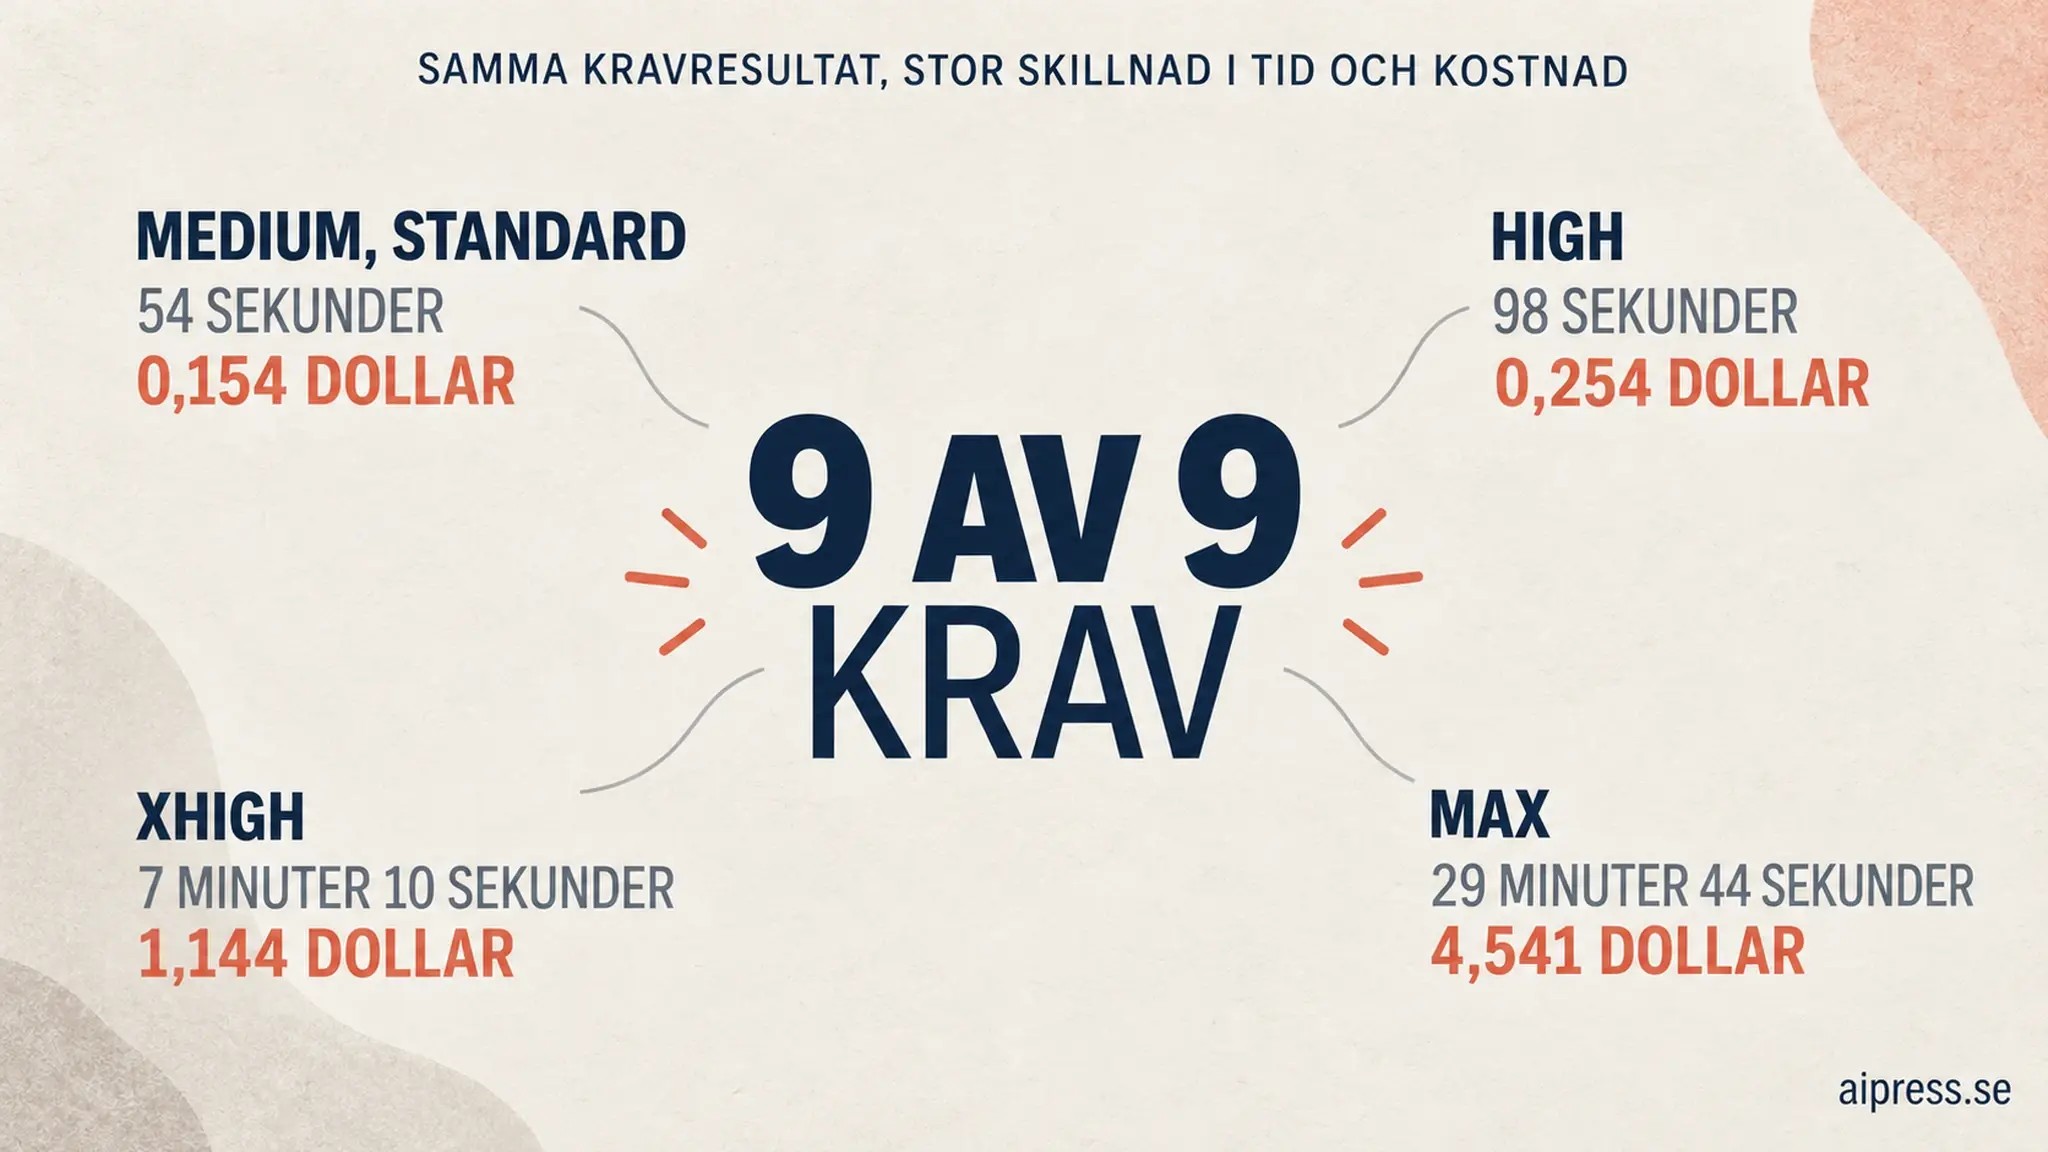
Alla fyra versionerna uppfyllde de nio kraven och startade utan fel i webbläsaren.
| Tankenivå | Krav | Tid | Kostnad | Tanketoken |
|---|---|---|---|---|
| Medium, standard | 9 av 9 | 54 sekunder | 0,154 dollar | 383 |
| High | 9 av 9 | 98 sekunder | 0,254 dollar | 4 097 |
| Xhigh | 9 av 9 | 7 minuter 10 sekunder | 1,144 dollar | 40 202 |
| Max | 9 av 9 | 29 minuter 44 sekunder | 4,541 dollar | 211 381 |
Maxversionen kostade 29,5 gånger mer än standardversionen och tog nästan 33 gånger längre tid. Tänkandet pågick så länge att det första svaret nådde gränsen för maximal utdata och fick fortsätta i ett andra anrop. Det första synliga tecknet kom efter ungefär 17 minuter.
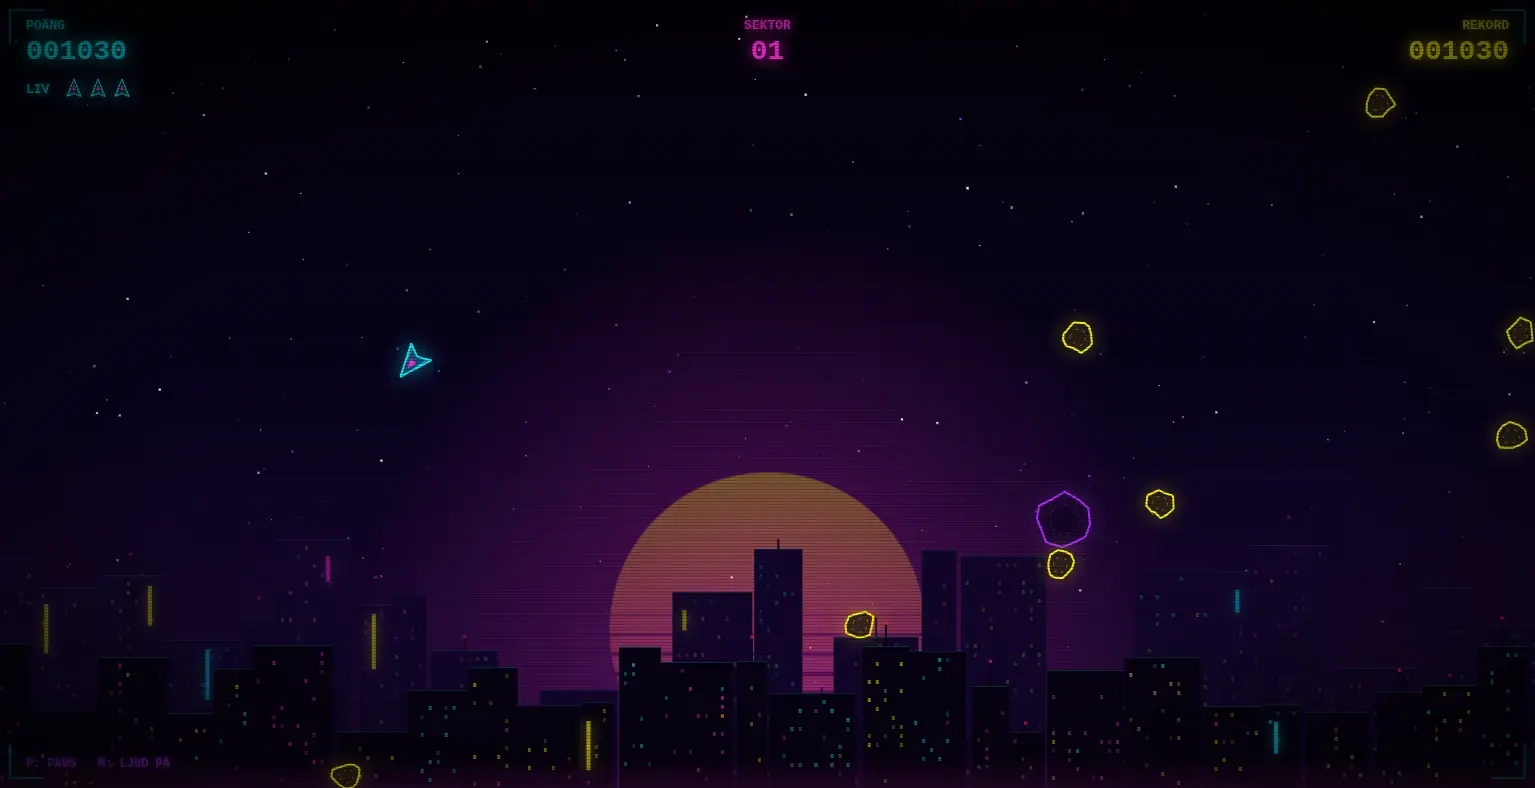
De högre nivåerna gav fler detaljer. Xhigh-varianten lade till en stadssilhuett, syntetiserat ljud och olika sektorer. Maxvarianten fick bland annat vågor, ljudeffekter och en mer påkostad startskärm. Grundfunktionerna var redan kompletta på standardnivån.
Läsaren kan spela xhigh-varianten här, publicerad under namnet Opus-Asteroid. Det var den variant som klarade spelbarhetstestet bäst.
Skillnaden mellan nivåerna blev ännu mindre i korrekturtestet. Claude hittade samtliga sju fel på alla fem inställningar från low till max. Low tog 8,1 sekunder och kostade drygt två cent. Max tog 155 sekunder och kostade 35 cent för identiska rättelser.
Hela jämförelsen, en körning per cell:
| Tankenivå (rätt, sekunder, dollar) | Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol | Grok 4.7 |
|---|---|---|---|---|
| low | 7 av 7, 8,1 s, 0,0207 | 7 av 7, 7,8 s, 0,0233 | 7 av 7, 10,0 s, 0,012 | 6 av 7, 18,7 s, 0,0094 |
| medium | 7 av 7, 9,8 s, 0,0244 | 7 av 7, 8,3 s, 0,0285 | 7 av 7, 10,9 s, 0,016 | 7 av 7, 43,7 s, 0,0217 |
| high | 7 av 7, 11,6 s, 0,0281 | 7 av 7, 36,1 s, 0,0667 | 7 av 7, 13,0 s, 0,0166 | 6 av 7, 45,8 s, 0,0224 |
| xhigh | 7 av 7, 15,7 s, 0,0376 | 7 av 7, 52,0 s, 0,1116 | 7 av 7, 24,5 s, 0,0370 | 6 av 7, 42,9 s, 0,0207 |
| max | 7 av 7, 155,3 s, 0,3526 | - | - | - |
För vanliga mejl, sammanfattningar och enklare kodgranskning finns inget i våra tester som motiverar max som standard. Medium är en rimlig utgångspunkt. Xhigh och max bör reserveras för uppgifter där det går att visa en mätbar kvalitetsvinst.
Spelen fungerar på snabba skärmar
Aipress kontrollerade också om spelen gick att styra i mänskligt tempo och om hastigheten förändrades på skärmar med 144 bilder per sekund.
Alla fyra var spelbara. Asteroider och skott rörde sig efter verklig tid i stället för att flyttas en bestämd sträcka vid varje bildruta. Därmed blir spelet inte mer än dubbelt så snabbt på en 144-hertzskärm.
Standardversionen hade ett mindre fel i friktionsberäkningen. På en snabb skärm blev skeppet trögare, med en uppmätt toppfart på 219 i stället för 450 pixlar per sekund. High, xhigh och max var helt tidsbaserade.
Testet avslöjade samtidigt ett fel i Grok-spelet som Aipress tidigare publicerat. Där styrdes all rörelse av bildfrekvensen. På en 144-hertzskärm gick spelet 2,4 gånger snabbare och kunde vara över innan spelaren hunnit trycka på en tangent. Den tidigare automatiska tangentsekvensen hade inte fångat detta. Tekniskt uppfyllda krav räcker alltså inte för att avgöra om en interaktiv produkt fungerar för en människa.
Alltid aktivt tänkande förändrar användningen
Claude Opus 5.5 har fem tankenivåer: low, medium, high, xhigh och max. Tänkandet går inte att stänga av. Nivån styr hur mycket beräkning som får användas, och tanketoken debiteras som vanlig utdata.
Standardnivån är medium. Opus 5 använde high om utvecklaren inte gjorde ett aktivt val. Den som byter till den nya i ett befintligt system bör därför mäta kvalitet, tid och kostnad på nytt.
Grunddata ur dokumentationen:
| Claude Opus 5.5 | |
|---|---|
| Modell-id | claude-opus-5-5 (Bedrock: anthropic.claude-opus-5-5) |
| Kontextfönster | 1 miljon token |
| Största svar | 128 000 token |
| Kunskapsgräns | juni 2026 |
| Tänkande | adaptivt, alltid på |
| Standardnivå | medium |
| Nivåer | low, medium, high, xhigh, max |
| Avvecklas tidigast | 22 september 2027 |
| Plattformar | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS |
För utvecklare finns även flera brytande ändringar. Tvingade verktygsanrop genom tool_choice med värdet any eller tool stöds inte och ger felkod 400. Tidigare tankeblock kan inte flyttas fritt mellan modeller, och ett äldre verktyg för datorstyrning måste bytas ut på Claude API och Google Cloud. Migreringsguiden rekommenderar uttryckligen att utvecklare ställer in tankenivån i stället för att förlita sig på standardvärdet.
Starkare skydd med kvarvarande risker
Anthropic beskriver Opus 5.5 som den hittills bäst presterande modellen i företagets automatiska beteendegranskning. Den uppges vara mindre benägen att utföra handlingar som är svåra att återkalla och bättre på att stå emot instruktioner som göms i dokument, webbsidor eller andra externa källor.
Systemkortet visar samtidigt varför sådana påståenden behöver läsas med försiktighet. I ett test utan produktskydd följde den färdiga Opus 5.5 en planterad instruktion i inklistrad text i omkring 2 procent av försöken på standardnivån (medium) och 7,4 procent på max. Den högsta inställningen gav alltså sämre motstånd i just detta test. Med produktskydden aktiverade följdes ingen av de synliga eller dolda instruktionerna. Systemkortet skriver:
Following the updated training, the final version of Claude Opus 5.5 acted on the planted instruction in about 2% of attempts at its default reasoning effort and about 7.4% at max effort.
Det betyder att en dold instruktion i text som användaren själv klistrar in, till exempel från ett mejl eller en webbsida, i sällsynta fall följdes innan produktskydden räknas in.
Anthropic tar nu bort osynliga tecken och märker inklistrad text så att Claude lättare kan skilja användarens fråga från material som kan innehålla manipulerande instruktioner. Systemkortet säger också att AI:n ibland verkar förstå att den utvärderas, vilket gör det svårare att avgöra hur väl testresultaten motsvarar verklig användning.
Vissa uppgifter inom cybersäkerhet och biologi kan automatiskt skickas vidare till äldre Claude-versioner när säkerhetsfiltren ingriper. Det sker utan att användaren själv väljer bytet.
Vilka abonnemang får Opus 5.5 och vad kostar de?
Claude Opus 5.5 finns via Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry och Claude Platform on AWS. Modellnamnet i Anthropics API är claude-opus-5-5.
Aipress kunde använda den både på claude.ai och i Claude Code från Sverige med ett Max-abonnemang på lanseringsdagen. På webben stod modellväljaren på ”Opus 5.5 Medium”.
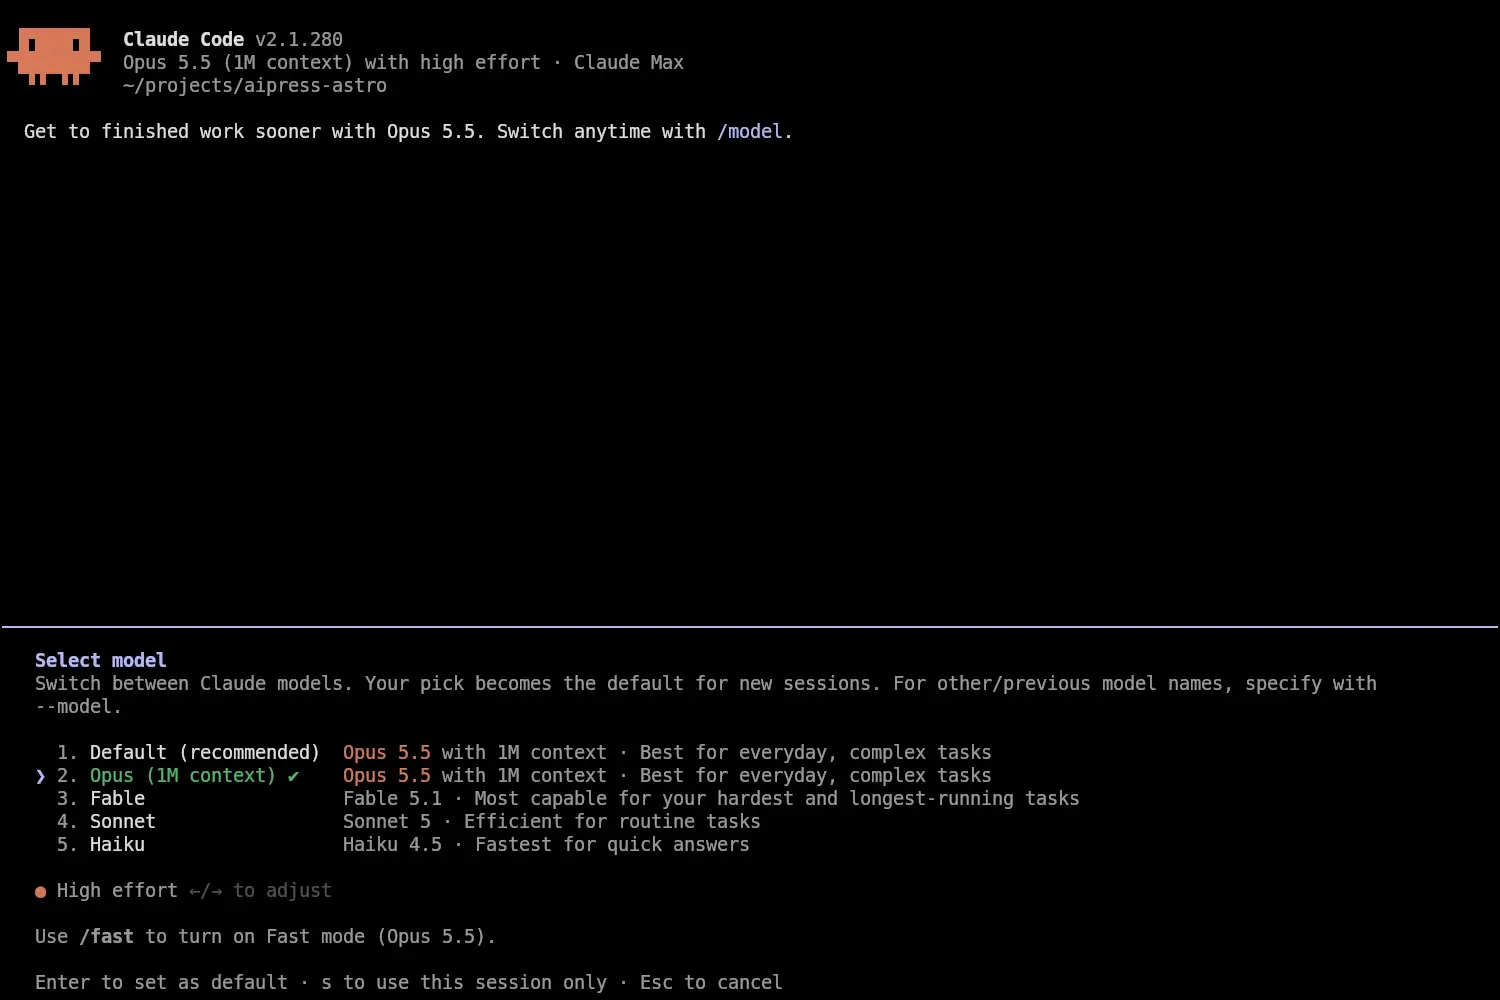
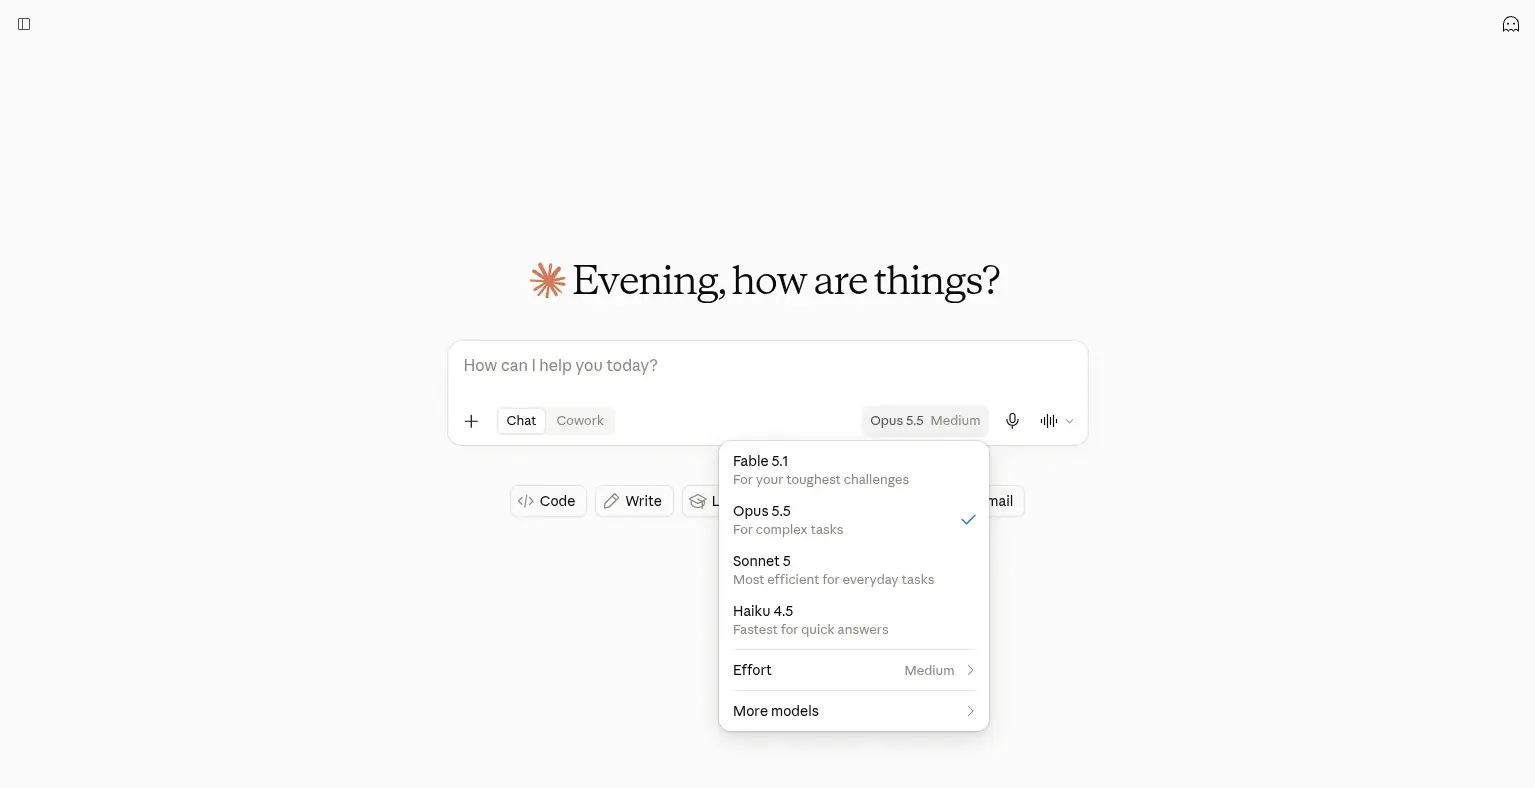
Anthropics dokumentation anger den även som standard i Claude Code för Pro, Max, Team och Enterprise samt för användare som ansluter direkt till företagets API. Pro och Team Standard hade tidigare Sonnet som standard. Claude Code måste uppdateras till 2.1.280 eller senare.
I samband med lanseringen höjer Anthropic femtimmarsgränserna för Pro, Max och Team. Företaget ger också abonnemangsanvändare en återställning av användningsgränsen som kan sparas och aktiveras vid ett valfritt tillfälle.
Det publicerade materialet anger inte vad Free-användare får, och Aipress har inte kunnat kontrollera den planen.
På den svenska uppgraderingssidan visades Pro för 196 kronor per månad vid årsbetalning, totalt 2 349 kronor per år inklusive moms. Max började på 1 149 kronor per månad inklusive moms. Det är abonnemangspriser. Användning via API debiteras separat i dollar.
Claude Sonnet 5.5 och Claude Haiku 5.5 ska enligt Anthropic följa under de kommande veckorna.
Aipress slutsats
Claude Opus 5.5 levererade korrekta svar, fungerande filer och spelbar kod i Aipress tester. Den klarade långa verktygsuppgifter utan tekniska fel och var betydligt bättre på faktisk spelbarhet än vad en enkel kravlista kunde visa.
Resultaten behöver ändå granskas. Claude gjorde obeställda ändringar, hittade på realistiska kontaktuppgifter och misslyckades med ett strikt JSON-format. Sådant kan se obetydligt ut för en människa men orsaka fel i automatiserade arbetsflöden.
Den tydligaste lärdomen gäller tankenivån. Medium räckte långt och är rätt standardval för de flesta uppgifter. Max gav mer utsmyckning men ingen högre kravuppfyllelse i spel- eller korrekturtesten. När tid och kostnad kan öka trettiofalt bör den högsta nivån väljas först när uppgiften kräver den och resultatet går att kontrollera.
Vanliga frågor (FAQ)
Får jag Claude Opus 5.5 automatiskt om jag har Claude Pro?
I Claude Code blir Claude Opus 5.5 standardmodell för Pro, Max, Team och Enterprise när programmet har uppdaterats till version 2.1.280 eller senare. Pro och Team Standard använde tidigare Sonnet som standard. På claude.ai visade Aipress Max-konto ”Opus 5.5 Medium”, men Anthropic har inte angett vad Free-användare får.
Vilken tankenivå ska jag välja för Opus 5.5?
Medium är standardnivån och en rimlig utgångspunkt för de flesta uppgifter med Claude Opus 5.5. I Aipress korrekturtest hittade alla fem nivåerna samma sju fel, men low tog 8,1 sekunder och kostade drygt två cent medan max tog 155 sekunder och kostade 35 cent. I speltestet klarade medium, high, xhigh och max samma nio krav, trots att max kostade 29,5 gånger mer än medium och tog nästan 30 minuter.
Går det att stänga av tänkandet i Opus 5.5?
Nej, tänkandet är alltid aktiverat i Claude Opus 5.5 och det enda reglaget är tankenivån: low, medium, high, xhigh eller max. Tanketoken debiteras som vanlig utdata. Opus 5 hade high som standard, medan Opus 5.5 använder medium.
Källor
- Claude Opus 5.5
Anthropic, hämtad
- Models overview
Anthropic, hämtad
- What's new in Claude Opus 5.5
Anthropic, hämtad
- Migrating to Claude Opus 5.5
Anthropic, hämtad
- Pricing
Anthropic, hämtad
- Claude Opus 5.5 System Card
Anthropic, hämtad
- Claude Code changelog
Anthropic, hämtad
- Model configuration
Anthropic, hämtad
- Models, usage and limits in Claude Code
Anthropic, hämtad
Thomas Karlsson
Huvudredaktör, AI expert och journalist
Thomas bevakar generativ AI, språkmodeller och verktygen som förändrar hur vi arbetar. Han skriver för dig som vill förstå utvecklingen utan att redan kunna tekniken.